Reference:李宏毅机器学习
信息量(Information)
假设 \(X\) 是一个离散型随机变量,其取值集合为 \(\mathcal{X}\),概率分布函数为 \(p(x)=\Pr(X=x),\ x\in\mathcal{X}\),则事件 \(X=x_0\) 的信息量定义为
\[ I(x_0) = -\log p(x_0) \]
熵(Entropy)
一个事件发生的概率为 \(p\) 时,它的信息量是 \(-\log p\)。把这个事件的所有可能性罗列出来,就可以求得信息量的期望,这个期望就是熵。
假设事件 \(X\) 共有 \(n\) 种可能,发生 \(x_i\) 的概率为 \(p(x_i)\),那么该事件的熵 \(H(X)\) 为
\[ H(X)=-\sum_{i=1}^n p(x_i)\log p(x_i) \]
相对熵(KL 散度)
对于同一个随机变量 \(x\),若有两个独立的概率分布 \(P(x)\) 和 \(Q(x)\),可以用 KL 散度(Kullback–Leibler divergence)来衡量这两个分布的差异。其中 \(P\) 往往表示样本的真实分布,\(Q\) 表示模型所预测的分布。
\[ D_{KL}(p\|q)=\sum_{i=1}^n p(x_i)\log\frac{p(x_i)}{q(x_i)} \]
交叉熵
将 KL 散度公式变形:
\[ \begin{aligned} D_{KL}(p\|q)&=\sum_{i=1}^n p(x_i)\log\frac{p(x_i)}{q(x_i)}\\ &=\sum_{i=1}^n p(x_i)\log p(x_i)-\sum_{i=1}^n p(x_i)\log q(x_i)\\ &=-H(p)+\Big[-\sum_{i=1}^n p(x_i)\log q(x_i)\Big] \end{aligned} \]
等式的前一部分恰好是 \(p\) 的熵,后一部分就是交叉熵:
\[ H(p,q)=-\sum_{i=1}^n p(x_i)\log q(x_i) \]
JS 散度
JS 散度同样度量两个概率分布的相似度,是 KL 散度的变体,解决了 KL 散度非对称的问题:
\[ JS(P_1\|P_2)=\frac12 KL\!\left(P_1\Big\|\frac{P_1+P_2}{2}\right)+\frac12 KL\!\left(P_2\Big\|\frac{P_1+P_2}{2}\right) \]
Wasserstein GAN
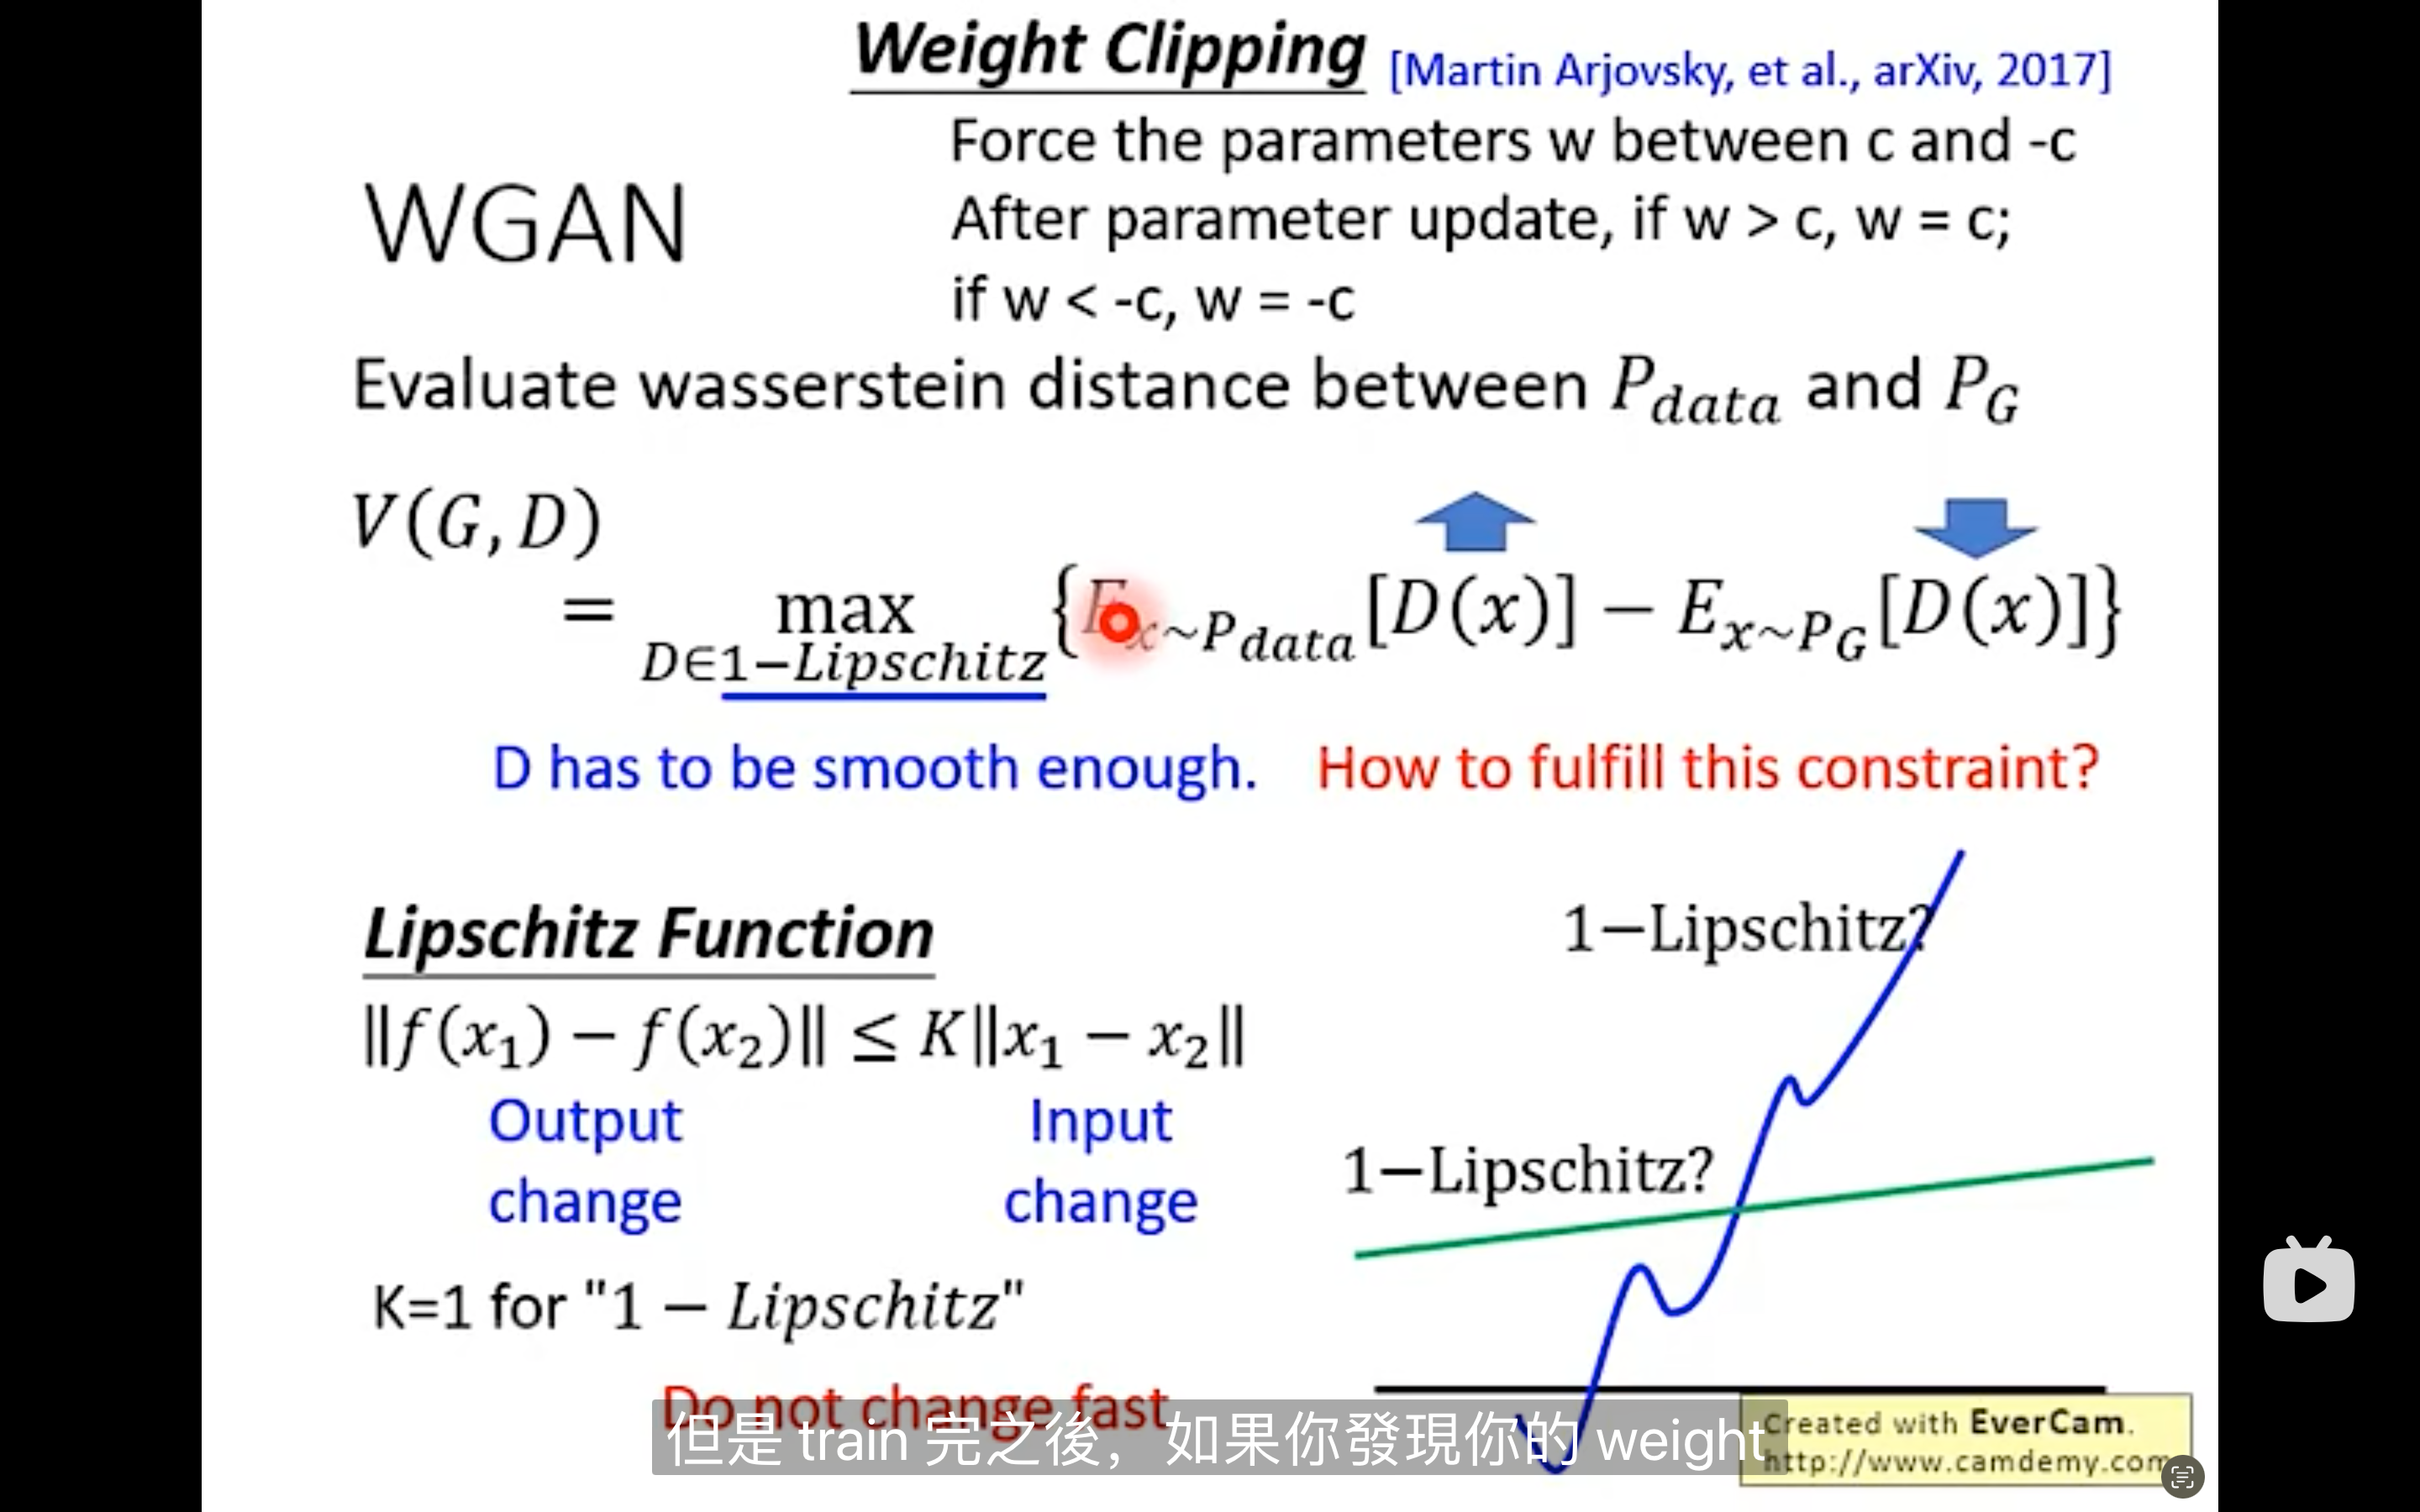
Wasserstein distance:
\[ W(p,q)=\inf_{\gamma\in\Pi(p,q)}\mathbb{E}_{x,y\sim\gamma}\big[\|x-y\|\big] \]
其中 \(\Pi(p,q)\) 表示分布 \(p\) 和 \(q\) 组合起来的所有可能的联合分布的集合。对于每一个可能的联合分布 \(\gamma\),可以从中采样 \((x,y)\sim\gamma\) 得到一对样本 \(x\) 和 \(y\),并计算这对样本的距离 \(\|x-y\|\);于是可以算出在该联合分布 \(\gamma\) 下样本对距离的期望值 \(\mathbb{E}_{x,y\sim\gamma}\big[\|x-y\|\big]\)。在所有可能的联合分布中,这个期望值能够取到的下界就是 Wasserstein 距离。
用推土的方式理解:\(\mathbb{E}_{x,y\sim\gamma}\big[\|x-y\|\big]\) 是在 \(\gamma\) 这种路径规划下,把 \(p\) 这堆土移成 \(q\) 的样子所需的消耗,而 Wasserstein 距离就是在最优路径规划下的最小消耗。
在 WGAN 中,具体表现为
\[ \max_{D\in 1\text{-Lipschitz}}\Big\{\mathbb{E}_{x\sim p_{\text{data}}}[D(x)]-\mathbb{E}_{x\sim p_G}[D(x)]\Big\} \]
Auto-Encoder
训练好 Auto-Encoder 后,把 decoder 单独拿出来就相当于是一个 Generator。
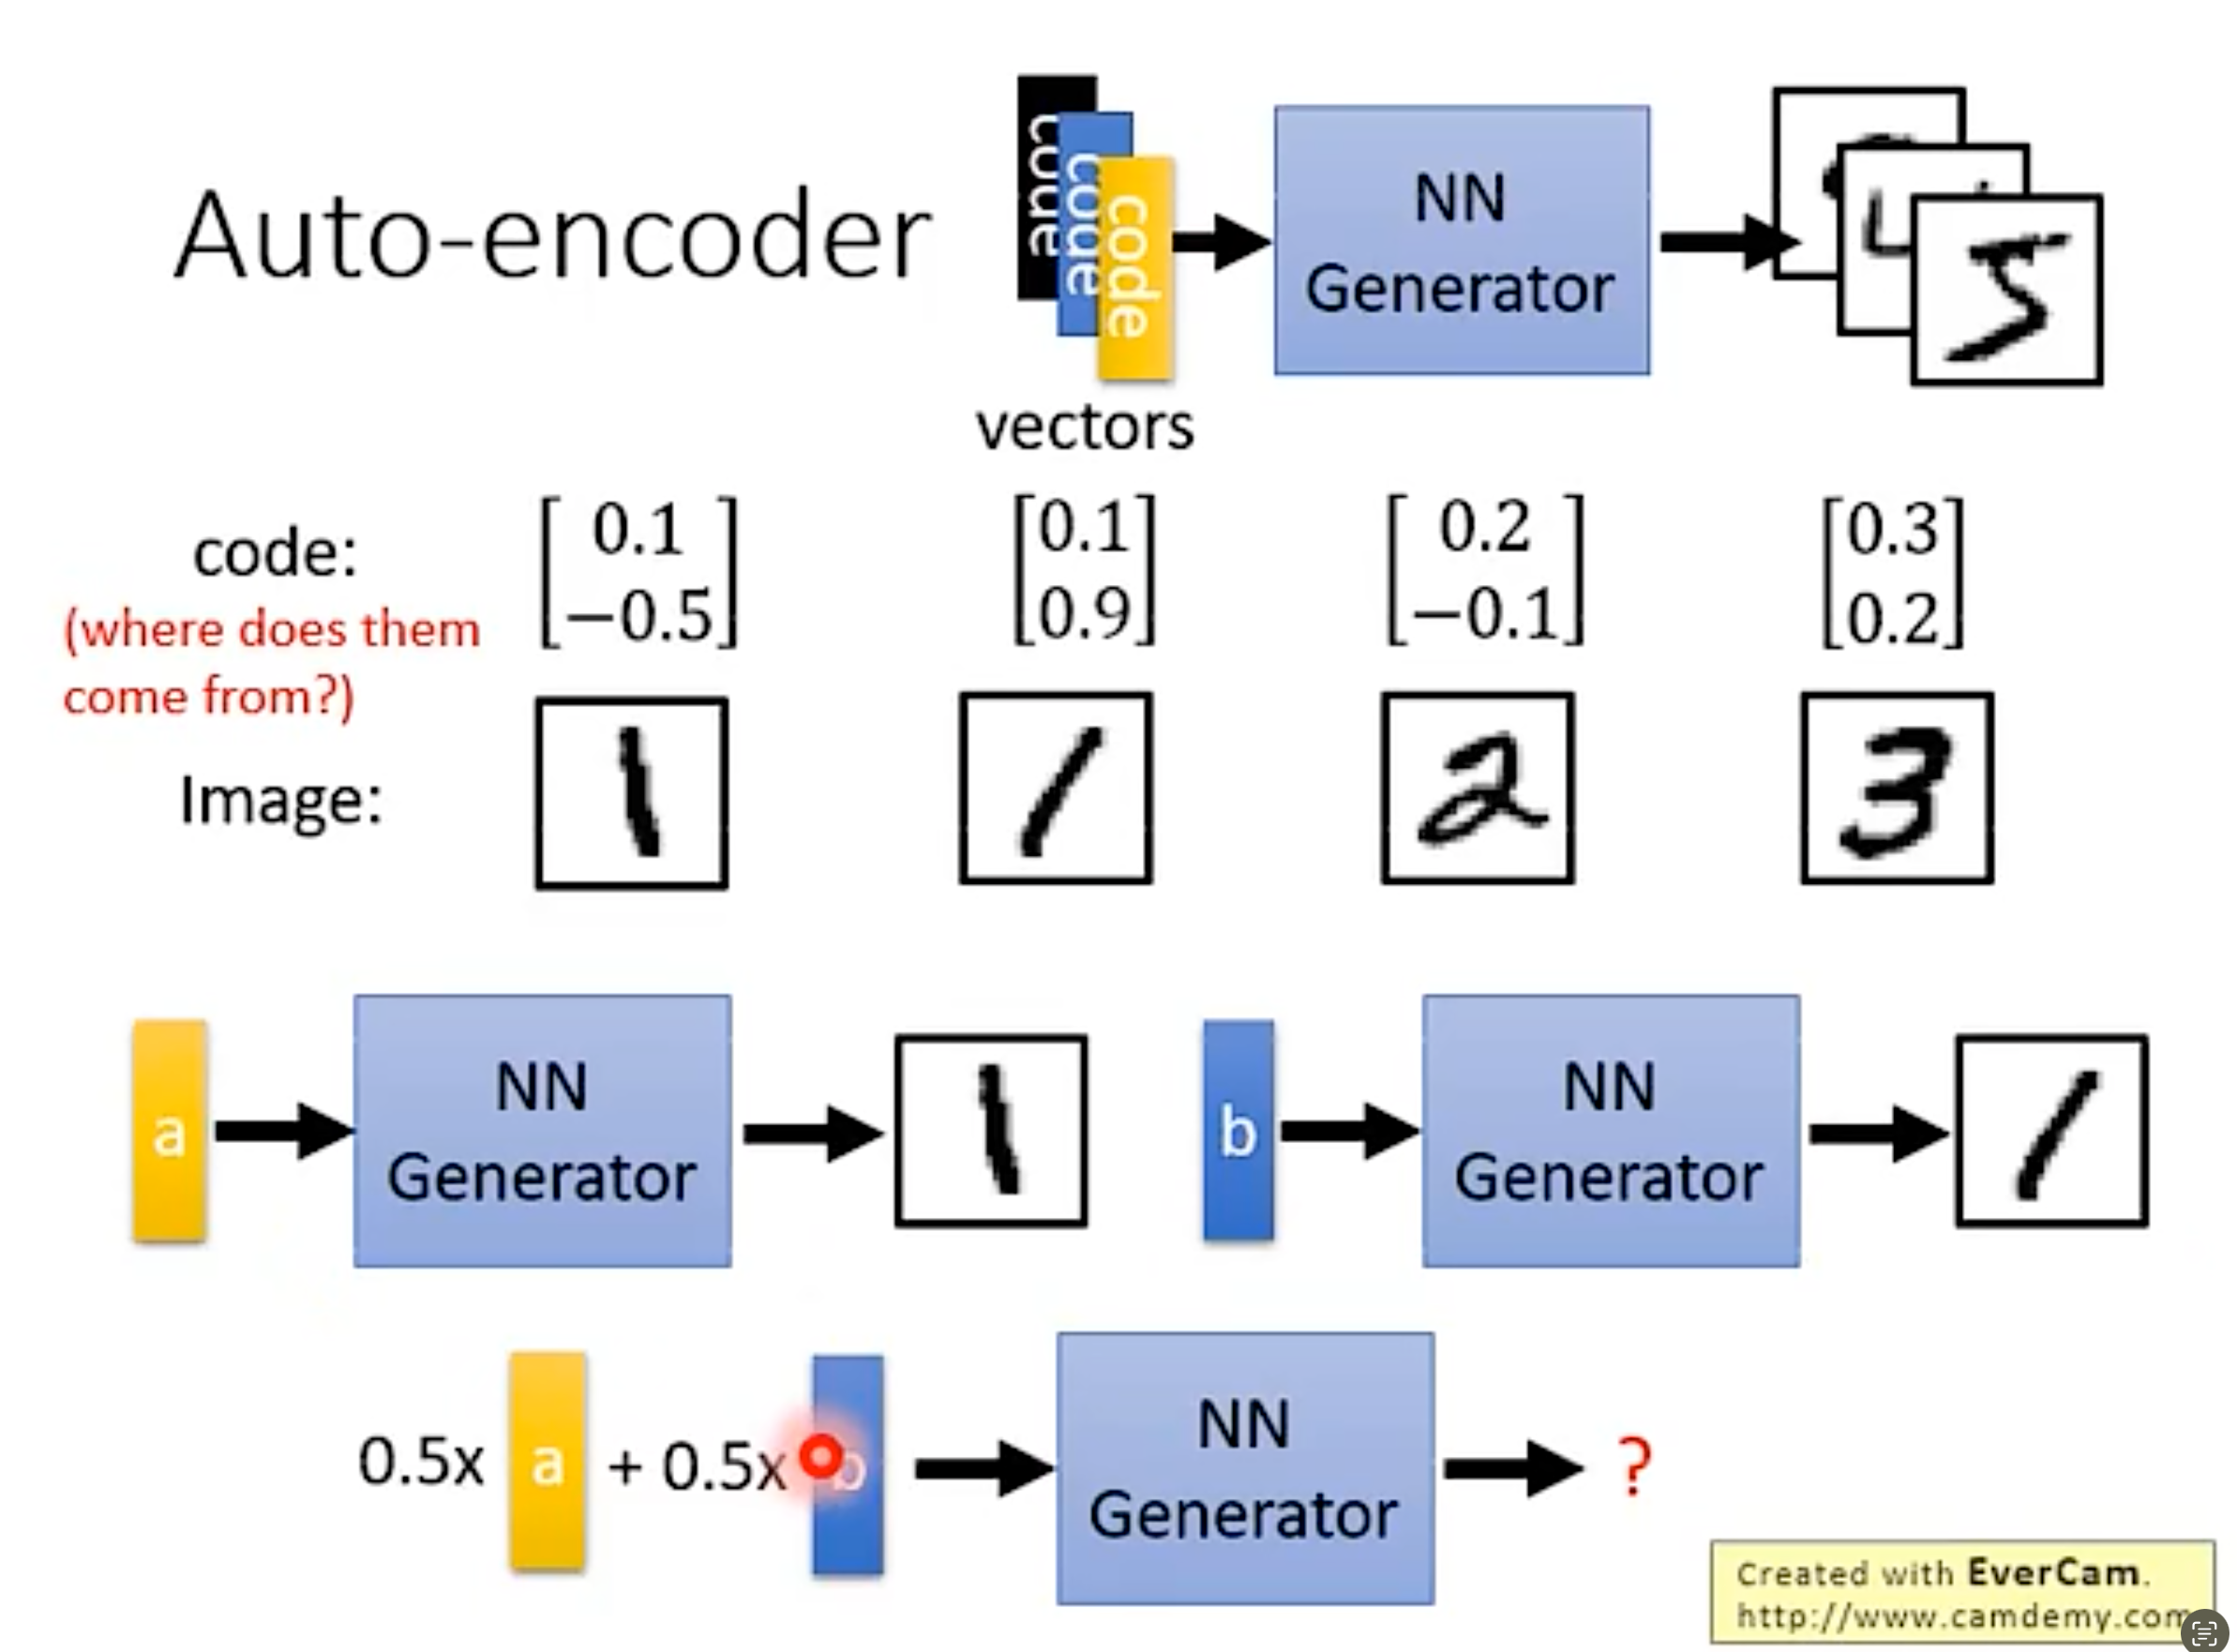
但存在一个问题:把两个 latent code 做线性插值 \(0.5a+0.5b\) 送进 decoder,输出的会是噪声,而不是介于两者之间的合理图像——latent space 并不连续。
为了解决这个问题,提出了 VAE。
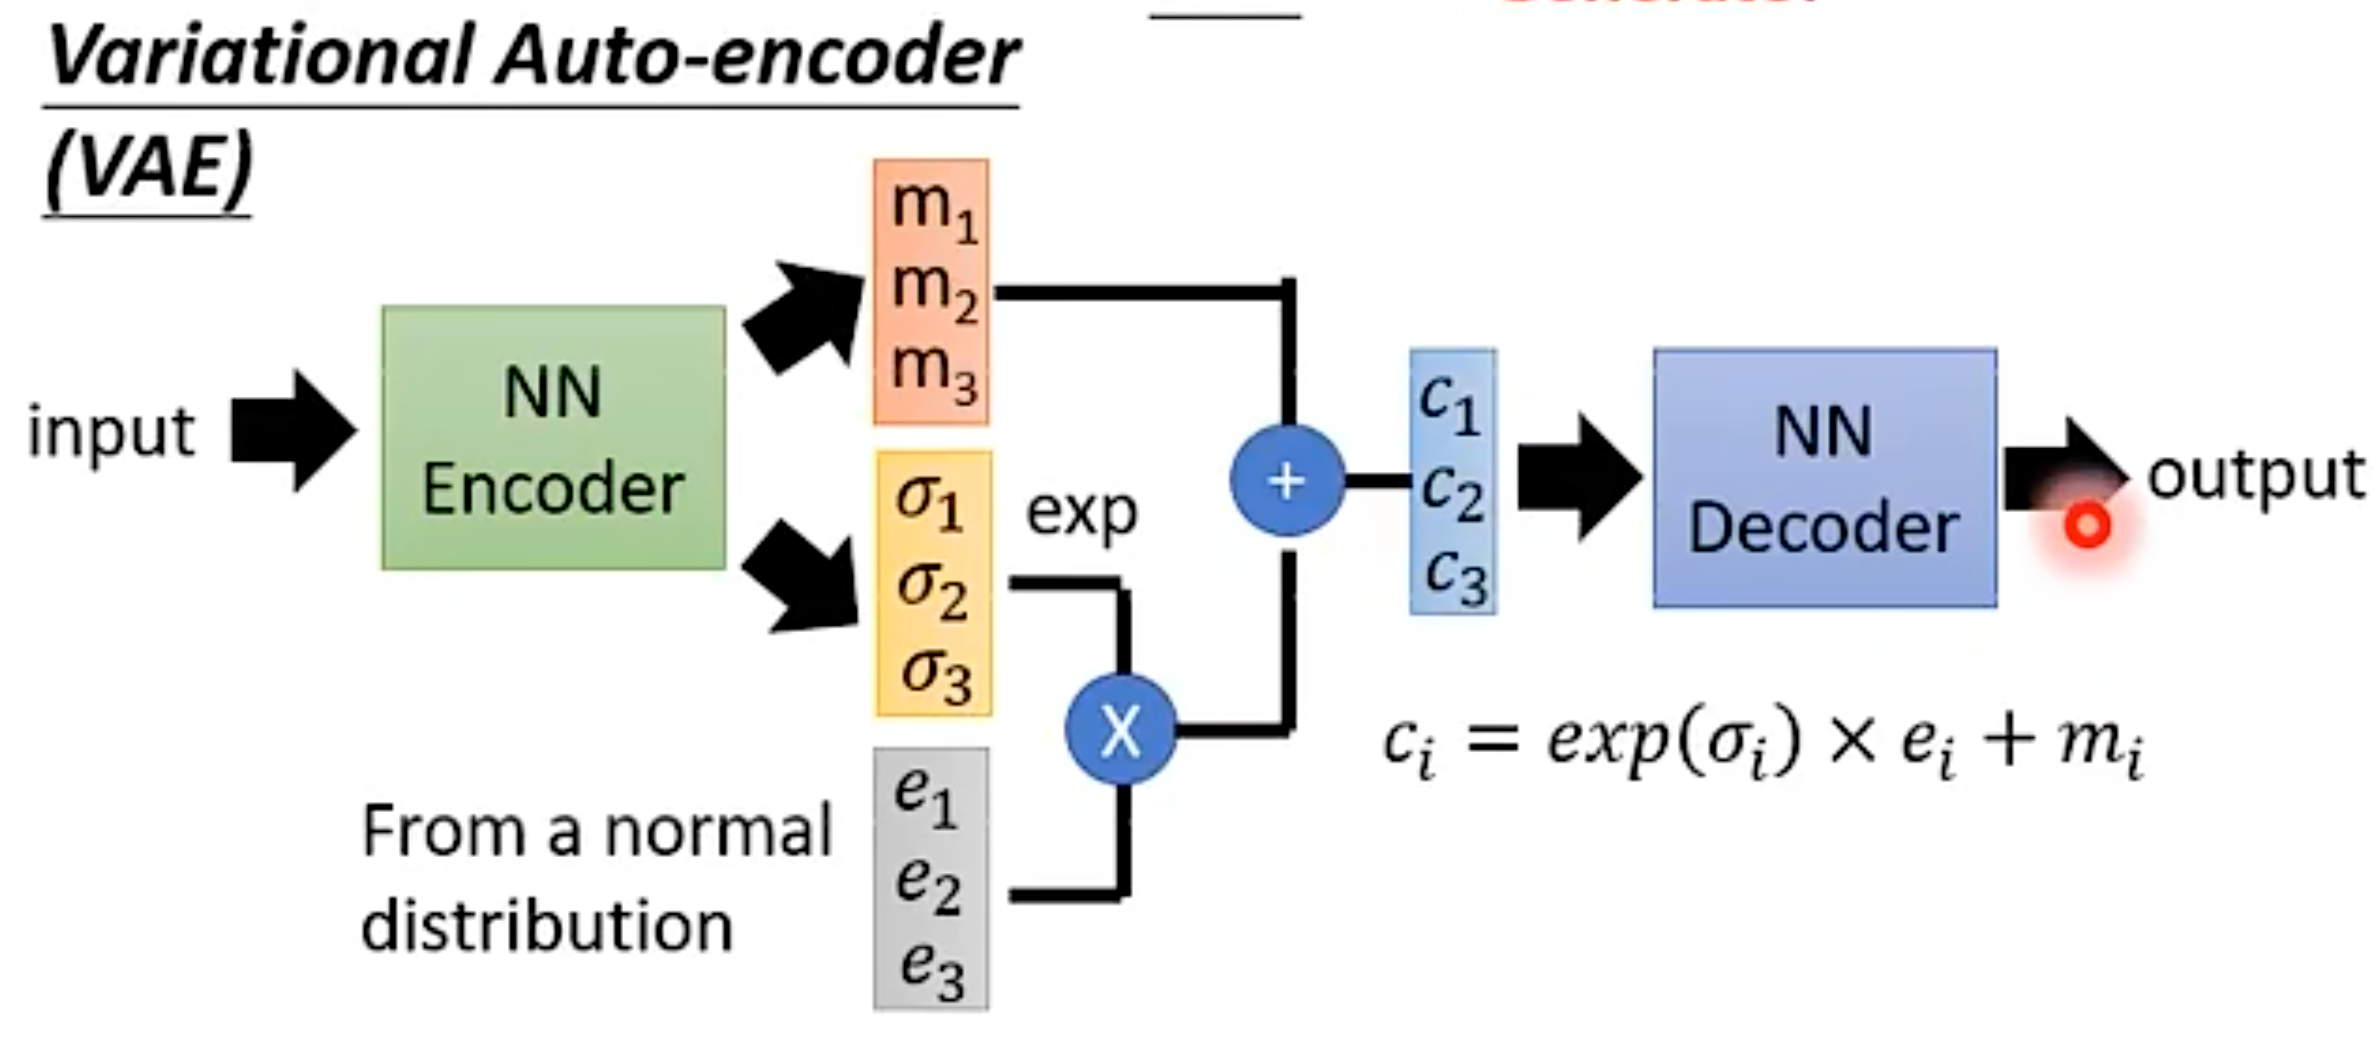
Variational Auto-Encoder