《视觉 SLAM 十四讲》读书笔记。
Chapter 2: 初识 SLAM
一、经典 SLAM 框架
1. 视觉里程计 Visual Odometry(前端)
为什么叫「里程计」?因为它和实际的里程计一样,只计算相邻时刻的运动,而和更早的历史信息没有关联。
VO 能够通过相邻帧间的图像估计相机运动,并恢复场景的空间结构。
只要把相邻时刻的运动「串」起来,就构成了机器人的运动轨迹,从而解决了定位问题。另一方面,根据每个时刻的相机位置,计算出各像素对应空间点的位置,就得到了地图。
2. 后端优化
处理 SLAM 过程中的噪声问题。如何从这些带有噪声的数据中估计整个系统的状态,以及这个状态估计的不确定性有多大——这称为最大后验概率估计(Maximum-a-Posteriori, MAP)。这里的状态既包括机器人自身的轨迹,也包含地图。
3. 回环检测(Loop Closure Detection)
解决位置估计随时间漂移的问题。为了实现回环检测,需要让机器人具有识别曾到过的场景的能力,可以通过判断图像间的相似性来完成。
4. 建图
度量地图(Metric Map):强调精确地表示地图中物体的位置关系。
- 稀疏地图:可以选择用 Landmarks 路标来表达
- 稠密地图:建模所有看到的东西
拓扑地图(Topological Map):更强调图元素之间的关系。它是一个图,由节点和边组成,只考虑节点间的连通性。
二、SLAM 问题的数学表述
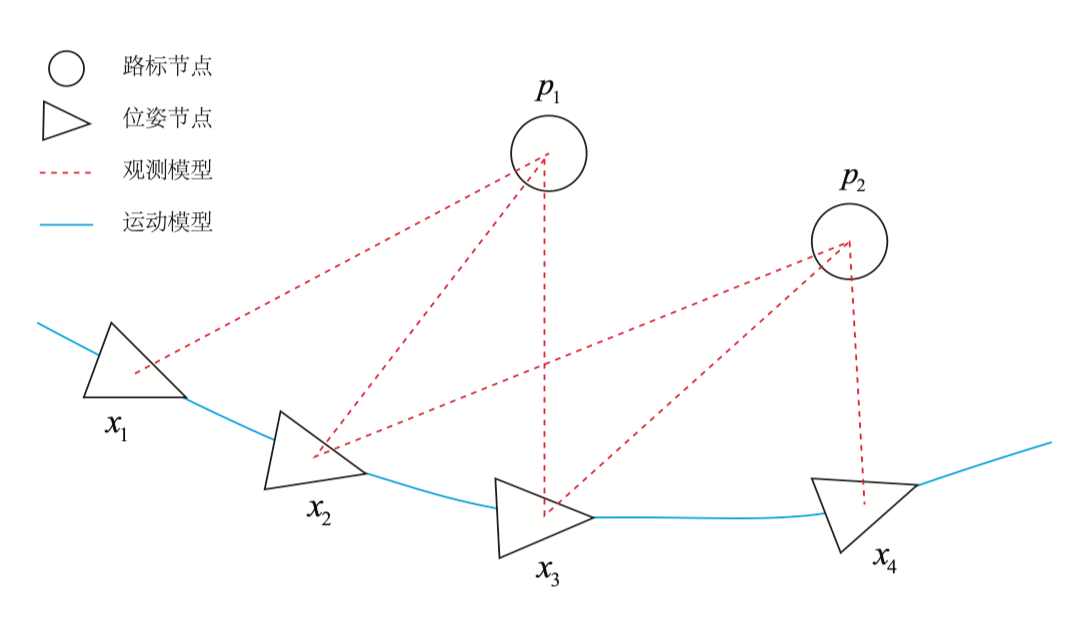
\(\mathbf{x}\) 表示小萝卜自身的位置,各时刻的位置记为 \(\mathbf{x}_1, \ldots, \mathbf{x}_K\),它们构成了小萝卜的轨迹。
对于地图,假设地图由多个路标(Landmark)组成。每个时刻传感器会测量到一部分路标点,得到观测数据。假设一共 \(N\) 个路标点,用 \(\mathbf{y} = \{\mathbf{y}_1, \ldots, \mathbf{y}_N\}\) 来表示它们。
例如:
\[ \begin{aligned} & \text{Platform State} \quad \mathbf{x}_k = [x_k \quad y_k \quad \theta_k]^T \\ & \text{Sensor} \quad\quad\quad\ \ \boldsymbol{u}_k = [\Delta x_k, \Delta y_k, \Delta \theta_k]^T\\ & \text{Map State} \quad\quad\ \ \mathbf{y} = \{ y^1, y^2, \ldots, y^N \} \end{aligned} \]
其中 \(y\) 是 landmark,上标是 landmark 的 label。
- 什么是运动?考虑从 \(k-1\) 时刻到 \(k\) 时刻,小萝卜的位置 \(\mathbf{x}\) 是如何变化的。
- 什么是观测?假设小萝卜在 \(k\) 时刻,于 \(\mathbf{x}_k\) 处探测到了某一个路标 \(\mathbf{y}_j\)。
运动方程(process model):
\[ \boldsymbol{x}_k=f\left(\boldsymbol{x}_{k-1},\boldsymbol{u}_k,\boldsymbol{w}_k\right) \]
\(\boldsymbol{u}_k\) 是运动传感器的读数(输入),\(\boldsymbol{w}_k\) 是噪声。
观测方程(observation model):
描述的是,当小萝卜在 \(\mathbf{x}_k\) 位置上看到某个路标点 \(\mathbf{y}_j\) 时,产生了一个观测数据 \(\boldsymbol{z}_{k,j}\)。
\[ \boldsymbol{z}_{k,j}=h\left(\boldsymbol{y}_j,\boldsymbol{x}_k,\boldsymbol{v}_{k,j}\right) \]
\(\boldsymbol{v}_{k,j}\) 是这次观测里的噪声。
以上两个方程描述了最基本的 SLAM 问题:当我们知道运动测量的读数 \(\boldsymbol{u}\) 以及传感器的读数 \(\boldsymbol{z}\) 时,如何求解定位问题(估计 \(\boldsymbol{x}\))和建图问题(估计 \(\boldsymbol{y}\))?
写成概率形式为
\[ f\left(\mathbf{x}_k,\mathbf{y}\mid\mathbf{Z}_{0:k},\mathbf{U}_{0:k},\mathbf{x}_0\right) \]
Chapter 3: 三维空间刚体运动
一、旋转矩阵
1. 点、向量、坐标系
位置是指相机在空间中的哪个地方,而姿态则是指相机的朝向。
向量是线性空间中的一个元素。不要把向量和它的坐标两个概念混淆:一个向量是空间当中的一样东西,只有指定这个三维空间中的某个坐标系时,才可以讨论该向量在此坐标系下的坐标。
内积:
\[ \boldsymbol{a}\cdot\boldsymbol{b}=\boldsymbol{a}^T\boldsymbol{b}=\sum_{i=1}^3a_ib_i=\left|\boldsymbol{a}\right|\left|\boldsymbol{b}\right|\cos\left\langle\boldsymbol{a},\boldsymbol{b}\right\rangle \]
外积:
\[ \boldsymbol{a}\times\boldsymbol{b}= \begin{bmatrix}0&-a_3&a_2\\a_3&0&-a_1\\-a_2&a_1&0\end{bmatrix}\boldsymbol{b} \triangleq \boldsymbol{a}^\wedge \boldsymbol{b} \]
这个矩阵是一个反对称矩阵(skew-symmetric)。\(\wedge\) 符号为反对称符号,它把一个向量变成了反对称矩阵。
2. 欧氏变换
由矩阵 \(\mathbf{T}\) 来表示。相机运动是一个刚体运动,它保证了同一个向量在各个坐标系下的长度和夹角都不会发生变化,这种变换称为欧氏变换。
\[ \begin{bmatrix}a_1\\a_2\\a_3\end{bmatrix} =\begin{bmatrix} \boldsymbol{e}_1^T\boldsymbol{e}_1'&\boldsymbol{e}_1^T\boldsymbol{e}_2'&\boldsymbol{e}_1^T\boldsymbol{e}_3'\\ \boldsymbol{e}_2^T\boldsymbol{e}_1'&\boldsymbol{e}_2^T\boldsymbol{e}_2'&\boldsymbol{e}_2^T\boldsymbol{e}_3'\\ \boldsymbol{e}_3^T\boldsymbol{e}_1'&\boldsymbol{e}_3^T\boldsymbol{e}_2'&\boldsymbol{e}_3^T\boldsymbol{e}_3' \end{bmatrix} \begin{bmatrix}a_1'\\a_2'\\a_3'\end{bmatrix} \triangleq\boldsymbol{R}\boldsymbol{a}' \]
\(\boldsymbol{R}\) 这个矩阵由两组基之间的内积组成,刻画了旋转前后同一个向量的坐标变换关系。
- 旋转矩阵是一个行列式为 1 的正交矩阵(逆等于转置)
- 行列式为 1 的正交矩阵也是旋转矩阵
旋转矩阵群定义如下:
\[ SO(n)=\{\boldsymbol{R}\in\mathbb{R}^{n\times n}\mid\boldsymbol{R}\boldsymbol{R}^T=\boldsymbol{I},\ \det(\boldsymbol{R})=1\} \]
\(SO(n)\) 是特殊正交群(Special Orthogonal Group),具体见第四章。
欧氏变换公式:
\[ \boldsymbol{a}'=\boldsymbol{R}\boldsymbol{a}+\boldsymbol{t} \]
引入齐次坐标:
\[ \begin{bmatrix}\boldsymbol{a}'\\1\end{bmatrix} =\begin{bmatrix}\boldsymbol{R}&\boldsymbol{t}\\\mathbf{0}^T&1\end{bmatrix} \begin{bmatrix}\boldsymbol{a}\\1\end{bmatrix} \triangleq\boldsymbol{T}\begin{bmatrix}\boldsymbol{a}\\1\end{bmatrix} \]
在齐次坐标中,某个点 \(x\) 的每个分量同乘一个非零常数 \(k\) 后,仍然表示同一个点:
\[ \tilde{\boldsymbol{x}}=\left[x,y,z,w\right]^T=\left[x/w,y/w,z/w,1\right]^T \]
忽略掉最后一项,这个点的坐标就和欧氏空间中一样。
对于 \(\boldsymbol{T}\),它具有比较特别的结构:左上角为旋转矩阵,右侧为平移向量,左下角为 \(\mathbf{0}\) 向量,右下角为 1。这种矩阵又称为特殊欧氏群(Special Euclidean Group):
\[ SE(3)=\left\{\boldsymbol{T}=\begin{bmatrix}\boldsymbol{R}&\boldsymbol{t}\\\mathbf{0}^T&1\end{bmatrix}\in\mathbb{R}^{4\times4}\ \middle|\ \boldsymbol{R}\in SO(3),\ \boldsymbol{t}\in\mathbb{R}^3\right\} \]
二、旋转向量和欧拉角
旋转矩阵描述旋转的方式比较冗余,因此我们希望有一种更紧凑的方式来描述旋转和平移。
任意旋转都可以用一个旋转轴和一个旋转角来刻画。于是可以使用一个向量,其方向与旋转轴一致,长度等于旋转角。这种向量称为旋转向量(事实上就是李代数),或轴角(Axis-Angle)。
旋转向量到旋转矩阵的转换(罗德里格斯公式 Rodrigues' Formula):
\[ \boldsymbol{R}=\cos\theta\,\boldsymbol{I}+\left(1-\cos\theta\right)\boldsymbol{n}\boldsymbol{n}^T+\sin\theta\,\boldsymbol{n}^\wedge \]
旋转矩阵到旋转向量的转换:
\[ \begin{aligned} &\operatorname{tr}\left(\boldsymbol{R}\right)= 1 + 2\cos\theta \quad\Rightarrow\quad \theta=\arccos\left(\frac{\operatorname{tr}(\boldsymbol{R})-1}{2}\right) \\ &\boldsymbol{R}\boldsymbol{n} = \boldsymbol{n} \end{aligned} \]
因此转轴 \(\boldsymbol{n}\) 是矩阵 \(\boldsymbol{R}\) 特征值 1 对应的特征向量。
欧拉角
- 绕物体的 \(Z\) 轴旋转,得到偏航角 yaw
- 绕旋转之后的 \(Y\) 轴旋转,得到俯仰角 pitch
- 绕旋转之后的 \(X\) 轴旋转,得到滚转角 roll
可以使用 \([r, p, y]^T\) 这样一个三维向量描述任意旋转,但会遇到万向锁(Gimbal Lock)问题。
三、四元数(Quaternion)
事实上,找不到不带奇异性(系统丢失一个自由度)的三维向量描述方式。
四元数是紧凑的,也没有奇异性,且能用单位四元数表示三维空间中任意一个旋转:
\[ \begin{aligned} &\boldsymbol{q}=q_0+q_1 i+q_2 j+q_3 k \\ &\begin{cases} i^2=j^2=k^2=-1\\ ij=k,\ ji=-k\\ jk=i,\ kj=-i\\ ki=j,\ ik=-j \end{cases} \\ &\boldsymbol{q}=[s,\boldsymbol{v}],\quad s=q_0\in\mathbb{R},\ \boldsymbol{v}=[q_1,q_2,q_3]^T\in\mathbb{R}^3 \end{aligned} \]
四元数与旋转向量的关系
旋转向量到四元数:假设某个旋转是绕单位向量 \(\boldsymbol{n} = [n_x, n_y, n_z]^T\) 进行了角度为 \(\theta\) 的旋转,那么这个旋转的四元数形式为
\[ \boldsymbol{q}=\left[\cos\frac\theta2,\ n_x\sin\frac\theta2,\ n_y\sin\frac\theta2,\ n_z\sin\frac\theta2\right]^T \]
四元数到旋转向量:
\[ \begin{cases} \theta=2\arccos q_0\\ \left[n_x,n_y,n_z\right]^T=\left[q_1,q_2,q_3\right]^T/\sin\dfrac{\theta}{2} \end{cases} \]
把 \(\theta\) 加上 \(2\pi\),可以发现 \(\boldsymbol{q}\) 变成了 \(-\boldsymbol{q}\)。所以在四元数中,任意的旋转都可以由两个互为相反数的四元数表示。
四元数的运算
设
\[ \boldsymbol{q}_a=s_a+x_a i+y_a j+z_a k,\quad \boldsymbol{q}_b=s_b+x_b i+y_b j+z_b k \]
加减法
\[ \boldsymbol{q}_a\pm\boldsymbol{q}_b=[s_a\pm s_b,\ \boldsymbol{v}_a\pm\boldsymbol{v}_b] \]
乘法
\[ \begin{aligned} \boldsymbol{q}_{a}\boldsymbol{q}_{b}& =s_as_b-x_ax_b-y_ay_b-z_az_b \\ &+\left(s_ax_b+x_as_b+y_az_b-z_ay_b\right)i \\ &+\left(s_ay_b-x_az_b+y_as_b+z_ax_b\right)j \\ &+\left(s_{a}z_{b}+x_{a}y_{b}-y_{a}x_{b}+z_{a}s_{b}\right)k \end{aligned} \]
共轭
\[ \boldsymbol{q}_a^*=s_a-x_a i-y_a j-z_a k=[s_a,-\boldsymbol{v}_a] \]
模长
\[ \|\boldsymbol{q}_a\|=\sqrt{s_a^2+x_a^2+y_a^2+z_a^2} \]
逆
\[ \boldsymbol{q}^{-1}=\boldsymbol{q}^*/\|\boldsymbol{q}\|^2 \]
数乘与点乘
\[ k\boldsymbol{q}=[ks,k\boldsymbol{v}], \qquad \boldsymbol{q}_a\cdot\boldsymbol{q}_b=s_as_b+x_ax_b+y_ay_b+z_az_b \]
用四元数表示旋转
\[ \begin{aligned} &\boldsymbol{p}=[0,x,y,z]=[0,\boldsymbol{v}] \\ &\boldsymbol{q}=\left[\cos\frac\theta2,\ \boldsymbol{n}\sin\frac\theta2\right]\\ &\boldsymbol{p}'=\boldsymbol{q}\boldsymbol{p}\boldsymbol{q}^{-1} \end{aligned} \]
四元数与旋转矩阵的转换
四元数到旋转矩阵
\[ \boldsymbol{R}= \begin{bmatrix} 1-2q_2^2-2q_3^2 & 2q_1q_2+2q_0q_3 & 2q_1q_3-2q_0q_2\\ 2q_1q_2-2q_0q_3 & 1-2q_1^2-2q_3^2 & 2q_2q_3+2q_0q_1\\ 2q_1q_3+2q_0q_2 & 2q_2q_3-2q_0q_1 & 1-2q_1^2-2q_2^2 \end{bmatrix} \]
旋转矩阵到四元数
\[ q_0=\frac{\sqrt{\operatorname{tr}(\boldsymbol{R})+1}}{2},\quad q_1=\frac{m_{23}-m_{32}}{4q_0},\quad q_2=\frac{m_{31}-m_{13}}{4q_0},\quad q_3=\frac{m_{12}-m_{21}}{4q_0} \]
四、相似、仿射、射影变换
具体参考《基于图像的三维重建》课程,或者《计算机视觉:模型、学习和推理》。
相似变换
\[ \boldsymbol{T}_S=\begin{bmatrix}s\boldsymbol{R}&\boldsymbol{t}\\\mathbf{0}^T&1\end{bmatrix} \]
仿射变换
\[ \boldsymbol{T}_A=\begin{bmatrix}\boldsymbol{A}&\boldsymbol{t}\\\mathbf{0}^T&1\end{bmatrix} \]
射影变换
\[ \boldsymbol{T}_P=\begin{bmatrix}\boldsymbol{A}&\boldsymbol{t}\\\boldsymbol{a}^T&v\end{bmatrix} \]
Chapter 4: 李群与李代数
因为在 SLAM 中位姿是未知的,而我们需要解决「什么样的相机位姿最符合当前观测数据」这样的问题。一种典型的方式是把它构建成一个优化问题,求解最优的 \(\boldsymbol{R},\boldsymbol{t}\) 使误差最小化。通过李群与李代数之间的转换关系,我们希望把位姿估计变成无约束的优化问题,从而简化求解方式。
一、李群李代数基础
旋转矩阵或者变换矩阵对于加法是不封闭的,但是关于乘法是封闭的:
\[ \begin{aligned} &R_1+R_2\notin SO(3), \quad T_1+T_2\notin SE(3)\\ &R_1R_2\in SO(3), \quad T_1T_2\in SE(3) \end{aligned} \]
乘法对应着旋转或变换的复合——两个旋转矩阵相乘表示做了两次旋转。对于这种只有一个运算的集合,我们把它叫做群。
1. 群
群(Group)是一种集合加上一种运算的代数结构。把集合记作 \(A\),运算记作 \(\cdot\),那么群可以记作 \(G = (A, \cdot)\),并满足:
\[ \begin{aligned} &1.\quad\text{封闭性:}\quad\forall a_1,a_2\in A,\quad a_1\cdot a_2\in A\\ &2.\quad\text{结合律:}\quad\forall a_1,a_2,a_3\in A,\quad(a_1\cdot a_2)\cdot a_3=a_1\cdot(a_2\cdot a_3)\\ &3.\quad\text{幺元:}\quad\exists a_0\in A,\ \text{s.t.}\ \forall a\in A,\quad a_0\cdot a=a\cdot a_0=a\\ &4.\quad\text{逆:}\quad\forall a\in A,\ \exists a^{-1}\in A,\ \text{s.t.}\ a\cdot a^{-1}=a_0 \end{aligned} \]
矩阵中常见的群:
- 一般线性群 \(GL(n)\):指 \(n \times n\) 的可逆矩阵,它们对矩阵乘法成群。
- 特殊正交群 \(SO(n)\):也就是所谓的旋转矩阵群,其中 \(SO(2)\) 和 \(SO(3)\) 最为常见。
- 特殊欧氏群 \(SE(n)\):也就是前面提到的 \(n\) 维欧氏变换,如 \(SE(2)\) 和 \(SE(3)\)。
李群是指具有连续(光滑)性质的群。\(SO(n)\) 和 \(SE(n)\) 在实数空间上是连续的(一个刚体能够连续地在空间中运动),且每个李群都有对应的李代数。
2. 李代数
李代数的引出
\[ \boldsymbol{a}^{\wedge}=\boldsymbol{A}= \begin{bmatrix}0&-a_3&a_2\\a_3&0&-a_1\\-a_2&a_1&0\end{bmatrix}, \qquad\boldsymbol{A}^{\vee}=\boldsymbol{a} \]
其中 \(\vee\) 把一个反对称矩阵变为一个向量。考虑
\[ \begin{aligned} & \boldsymbol{R}(t)\boldsymbol{R}(t)^T=\boldsymbol{I} \\ & \dot{\boldsymbol{R}}(t)\boldsymbol{R}(t)^T=-\left(\dot{\boldsymbol{R}}(t)\boldsymbol{R}(t)^T\right)^T \end{aligned} \]
可以看出上式是一个反对称矩阵形式。因为 \(\wedge\) 可以把一个向量变成反对称矩阵,所以
\[ \dot{\boldsymbol{R}}(t)\boldsymbol{R}(t)^T=\boldsymbol{\phi}(t)^\wedge \]
于是可以得到:每次对旋转矩阵求一次导数,只需左乘一个 \(\boldsymbol{\phi}^{\wedge}(t)\) 矩阵即可。\(\boldsymbol{\phi}\) 反映了 \(\boldsymbol{R}\) 的导数性质,称它在 \(SO(3)\) 原点附近的正切空间。
李代数的定义
李代数表述了李群的局部性质。李代数由一个集合 \(\mathbb{V}\)、一个数域 \(\mathbb{F}\) 和一个二元运算 \([,]\) 组成,二元运算称为李括号。满足下面四条的 \((\mathbb{V},\mathbb{F},[,])\) 称为李代数:
\[ \begin{aligned} &1.\ \text{封闭性}\quad\forall\boldsymbol{X},\boldsymbol{Y}\in\mathbb{V},\ [\boldsymbol{X},\boldsymbol{Y}]\in\mathbb{V} \\ &2.\ \text{双线性}\quad\forall\boldsymbol{X},\boldsymbol{Y},\boldsymbol{Z}\in\mathbb{V},\ a,b\in\mathbb{F}: \\ &\qquad [a\boldsymbol{X}+b\boldsymbol{Y},\boldsymbol{Z}]=a[\boldsymbol{X},\boldsymbol{Z}]+b[\boldsymbol{Y},\boldsymbol{Z}],\quad [\boldsymbol{Z},a\boldsymbol{X}+b\boldsymbol{Y}]=a[\boldsymbol{Z},\boldsymbol{X}]+b[\boldsymbol{Z},\boldsymbol{Y}]\\ &3.\ \text{自反性}\quad\forall\boldsymbol{X}\in\mathbb{V},\ [\boldsymbol{X},\boldsymbol{X}]=\mathbf{0} \\ &4.\ \text{雅可比等价}\quad\forall\boldsymbol{X},\boldsymbol{Y},\boldsymbol{Z}\in\mathbb{V}, \\ &\qquad [\boldsymbol{X},[\boldsymbol{Y},\boldsymbol{Z}]]+[\boldsymbol{Z},[\boldsymbol{Y},\boldsymbol{X}]]+[\boldsymbol{Y},[\boldsymbol{Z},\boldsymbol{X}]]=\mathbf{0} \end{aligned} \]
李代数 \(\mathfrak{so}(3)\)
\(SO(3)\) 对应的李代数定义在 \(\mathbb{R}^3\) 上。两个向量 \(\boldsymbol{\phi}_1,\boldsymbol{\phi}_2\) 的李括号定义为
\[ [\boldsymbol{\phi}_1,\boldsymbol{\phi}_2]=(\boldsymbol{\Phi}_1\boldsymbol{\Phi}_2-\boldsymbol{\Phi}_2\boldsymbol{\Phi}_1)^\vee \]
\(\mathfrak{so}(3)\) 的元素是 3 维向量或者 3 维反对称矩阵:
\[ \mathfrak{so}(3)=\left\{\boldsymbol{\phi}\in\mathbb{R}^3,\ \boldsymbol{\Phi}=\boldsymbol{\phi}^{\wedge}\in\mathbb{R}^{3\times3}\right\} \]
每个向量对应到一个反对称矩阵,可以表达旋转矩阵的导数:
\[ \boldsymbol{R}=\exp(\boldsymbol{\phi}^\wedge) \]
也就是说,旋转矩阵的导数可以由旋转向量指定,它指导着如何在旋转矩阵上进行微积分运算。
李代数 \(\mathfrak{se}(3)\)
\[ \begin{aligned} &\mathfrak{se}(3)=\left\{\boldsymbol{\xi}=\begin{bmatrix}\boldsymbol{\rho}\\\boldsymbol{\phi}\end{bmatrix}\in\mathbb{R}^6,\ \boldsymbol{\rho}\in\mathbb{R}^3,\ \boldsymbol{\phi}\in\mathfrak{so}(3),\ \boldsymbol{\xi}^{\wedge}=\begin{bmatrix}\boldsymbol{\phi}^{\wedge}&\boldsymbol{\rho}\\\boldsymbol{0}^{T}&0\end{bmatrix}\in\mathbb{R}^{4\times4}\right\} \\ &\left[\boldsymbol{\xi}_{1},\boldsymbol{\xi}_{2}\right]=\left(\boldsymbol{\xi}_{1}^{\wedge}\boldsymbol{\xi}_{2}^{\wedge}-\boldsymbol{\xi}_{2}^{\wedge}\boldsymbol{\xi}_{1}^{\wedge}\right)^{\vee} \end{aligned} \]
\(\boldsymbol{\xi}\) 前三维为平移,后三维为旋转。
二、指数与对数映射
1. SO(3) 上的指数映射(Exponential Map)
任意矩阵的指数映射可以写成一个泰勒展开:
\[ \exp(\boldsymbol{\phi}^{\wedge})=\sum_{n=0}^{\infty}\frac{1}{n!}(\boldsymbol{\phi}^{\wedge})^{n} \]
令 \(\boldsymbol{\phi} = \theta\boldsymbol{a}\)(\(\boldsymbol{a}\) 为单位向量),利用反对称矩阵的幂次性质可得
\[ \exp(\theta\boldsymbol{a}^\wedge)=\cos\theta\,\boldsymbol{I}+(1-\cos\theta)\boldsymbol{a}\boldsymbol{a}^T+\sin\theta\,\boldsymbol{a}^\wedge \]
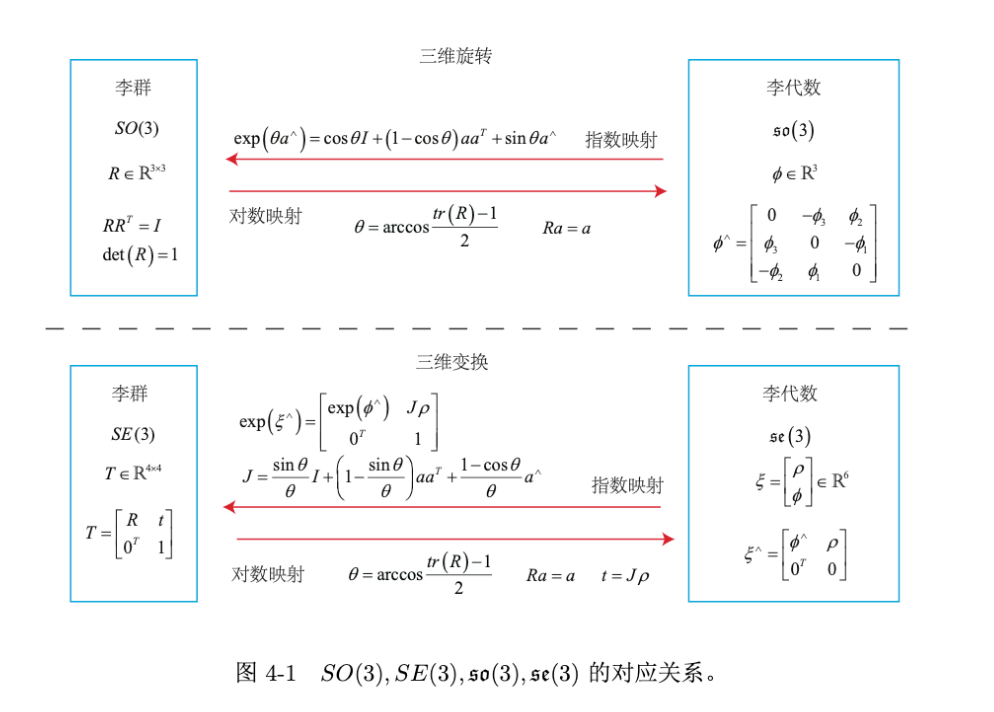
这表明 \(\mathfrak{so}(3)\) 实际上就是由所谓的旋转向量组成的空间,而指数映射即罗德里格斯公式。通过它们,我们把 \(\mathfrak{so}(3)\) 中任意一个向量对应到了一个位于 \(SO(3)\) 中的旋转矩阵。
反之:
\[ \boldsymbol{\phi}=\ln\left(\boldsymbol{R}\right)^{\vee}=\left(\sum_{n=0}^{\infty}\frac{\left(-1\right)^{n}}{n+1}(\boldsymbol{R}-\boldsymbol{I})^{n+1}\right)^{\vee} \]
但实际计算时通常不用这个级数,而是用前面「旋转矩阵到旋转向量」中由 \(\operatorname{tr}(\boldsymbol{R})\) 求 \(\theta\)、再求特征向量得转轴的做法。
2. SE(3) 上的指数映射
\[ \exp(\boldsymbol{\xi}^{\wedge})\triangleq\begin{bmatrix}\boldsymbol{R}&\boldsymbol{J}\boldsymbol{\rho}\\\mathbf{0}^T&1\end{bmatrix}=\boldsymbol{T} \]
其中
\[ \boldsymbol{J}=\frac{\sin\theta}{\theta}\boldsymbol{I}+\left(1-\frac{\sin\theta}{\theta}\right)\boldsymbol{a}\boldsymbol{a}^T+\frac{1-\cos\theta}{\theta}\boldsymbol{a}^\wedge \]
三、李代数求导与扰动模型
1. BCH 公式
两个李代数指数映射乘积的完整形式,由 Baker–Campbell–Hausdorff 公式给出:
\[ \ln\left(\exp\left(\boldsymbol{\phi}_1^{\wedge}\right)\exp\left(\boldsymbol{\phi}_2^{\wedge}\right)\right)^{\vee}\approx \begin{cases} \boldsymbol{J}_l(\boldsymbol{\phi}_2)^{-1}\boldsymbol{\phi}_1+\boldsymbol{\phi}_2&\mathrm{if\ }\boldsymbol{\phi}_1\text{ is small}\\ \boldsymbol{J}_r(\boldsymbol{\phi}_1)^{-1}\boldsymbol{\phi}_2+\boldsymbol{\phi}_1&\mathrm{if\ }\boldsymbol{\phi}_2\text{ is small} \end{cases} \]
假定对某个旋转 \(\boldsymbol{R}\),对应的李代数为 \(\boldsymbol{\phi}\)。给它左乘一个微小旋转 \(\Delta\boldsymbol{R}\),对应的李代数为 \(\Delta\boldsymbol{\phi}\)。那么在李群上得到的结果是 \(\Delta\boldsymbol{R}\cdot\boldsymbol{R}\),而在李代数上,根据 BCH 近似为 \(\boldsymbol{J}_{l}^{-1}(\boldsymbol{\phi})\Delta\boldsymbol{\phi} + \boldsymbol{\phi}\)。注意这里 \(\boldsymbol{J}_l = \boldsymbol{J}\)。
反之,李代数上的加法可以近似为李群上的乘法:
\[ \begin{aligned} &\exp\left(\Delta\boldsymbol{\phi}^{\wedge}\right)\exp\left(\boldsymbol{\phi}^{\wedge}\right)=\exp\left(\left(\boldsymbol{\phi}+\boldsymbol{J}_{l}^{-1}\left(\boldsymbol{\phi}\right)\Delta\boldsymbol{\phi}\right)^{\wedge}\right) \\ &\exp\left((\boldsymbol{\phi}+\Delta\boldsymbol{\phi})^{\wedge}\right)=\exp\left((\boldsymbol{J}_{l}\Delta\boldsymbol{\phi})^{\wedge}\right)\exp\left(\boldsymbol{\phi}^{\wedge}\right)=\exp\left(\boldsymbol{\phi}^{\wedge}\right)\exp\left((\boldsymbol{J}_{r}\Delta\boldsymbol{\phi})^{\wedge}\right) \end{aligned} \]
2. SO(3) 李代数上的求导
在 SLAM 中,我们要估计相机的位置和姿态,该位姿由 \(SO(3)\) 上的旋转矩阵或 \(SE(3)\) 上的变换矩阵描述。
不妨设某个时刻小萝卜的位姿为 \(\boldsymbol{T}\)。它观察到了一个世界坐标位于 \(\boldsymbol{p}\) 的点,产生了一个观测数据 \(\boldsymbol{z}\):
\[ \boldsymbol{z}=\boldsymbol{T}\boldsymbol{p}+\boldsymbol{w} \]
对位姿的估计,相当于寻找一个最优的 \(\boldsymbol{T}\) 使整体误差最小化:
\[ \min_{\boldsymbol{T}}J(\boldsymbol{T})=\sum_{i=1}^N\left\|\boldsymbol{z}_i-\boldsymbol{T}\boldsymbol{p}_i\right\|_2^2 \]
求解此问题需要计算目标函数 \(J\) 关于变换矩阵 \(\boldsymbol{T}\) 的导数。使用李代数解决求导问题的思路分为两种:
- 用李代数表示姿态,然后根据李代数加法来对李代数求导(求导模型)。
- 对李群左乘或右乘微小扰动,然后对该扰动求导,称为左扰动和右扰动模型(扰动模型)。
3. 李代数求导
旋转后的点相对于李代数的导数:
\[ \frac{\partial\left(\boldsymbol{R}\boldsymbol{p}\right)}{\partial\boldsymbol{\phi}}=\left(-\boldsymbol{R}\boldsymbol{p}\right)^{\wedge}\boldsymbol{J}_{l} \]
但这里的 \(\boldsymbol{J}_l\) 比较复杂,所以实际使用下面的扰动模型求导。
4. 扰动模型(左乘)
\[ \frac{\partial\left(\boldsymbol{R}\boldsymbol{p}\right)}{\partial\boldsymbol{\varphi}} \approx -(\boldsymbol{R}\boldsymbol{p})^{\wedge} \]
5. SE(3) 上的李代数求导
使用扰动模型:
\[ \frac{\partial\left(\boldsymbol{T}\boldsymbol{p}\right)}{\partial\delta\boldsymbol{\xi}} \approx \begin{bmatrix}\boldsymbol{I}&-(\boldsymbol{R}\boldsymbol{p}+\boldsymbol{t})^\wedge\\\mathbf{0}^T&\mathbf{0}^T\end{bmatrix} \triangleq(\boldsymbol{T}\boldsymbol{p})^\odot \]
\(\odot\) 是一个算符,把一个齐次坐标的空间点变换成一个 \(4 \times 6\) 的矩阵。
四、相似变换群与李代数
单目视觉中使用的相似变换群 \(Sim(3)\)。
Chapter 5: 相机与图像
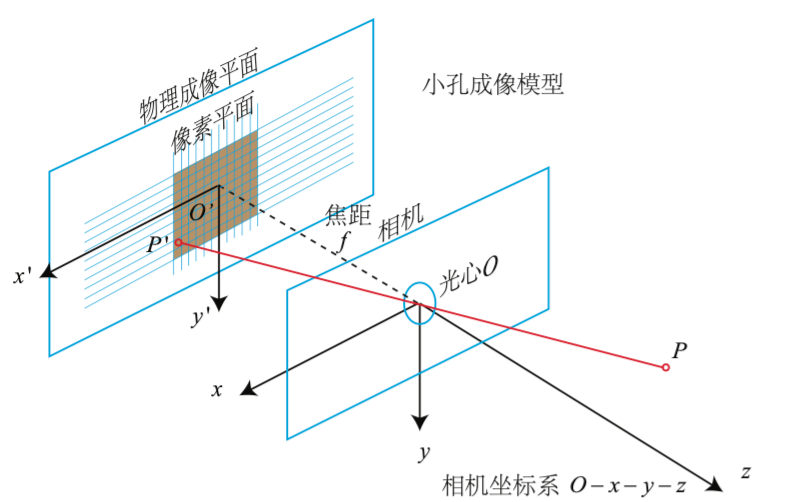
笔记见书。
Chapter 6: 非线性优化
笔记见书以及数值优化部分。
在噪声的影响下,我们希望通过带噪声的数据 \(\boldsymbol{z}\) 和 \(\boldsymbol{u}\),推断位姿 \(\boldsymbol{x}\) 和地图 \(\boldsymbol{y}\)(以及它们的概率分布),这构成了一个状态估计问题。
Chapter 7: 视觉里程计 1(特征点法)
一、特征点法
特征点应有的性质:
- 可重复性(repeatability):相同区域可在不同图像中被找到
- 可区别性(distinctiveness):不同区域有不同表达
- 高效率(efficiency):特征点数量应远小于像素数量
- 本地性(locality):特征仅与一小片图像区域相关
特征点由两部分组成:
- 关键点(key-point):该点在图像中的位置,有些还带有朝向、大小等信息
- 描述子(descriptor):描述关键点周围的像素信息,遵循「外观相似的特征应有相似的描述子」这一原则
常见特征:SIFT(精度高但计算量大,目前在 CPU 上难以实时)、SURF、ORB(速度快,适合实时 SLAM)。
二、ORB 特征
ORB = Oriented FAST + Rotated BRIEF。
1. FAST 关键点
检测局部像素灰度变化明显的地方,速度极快:
- 取像素 \(p\),设其亮度为 \(I_p\),设定阈值 \(T\)(如 \(I_p\) 的 20%)
- 在 \(p\) 周围半径为 3 的圆上取 16 个像素点
- 若连续 \(N\) 个点的亮度大于 \(I_p+T\) 或小于 \(I_p-T\),则 \(p\) 是特征点(\(N\) 常取 12,即 FAST-12)
预测试:先只检测第 1、5、9、13 个像素,快速排除大量非特征点。
FAST 本身不具备尺度和旋转不变性,ORB 对此做了改进:
- 尺度:构建图像金字塔,在每层上检测
- 旋转:用灰度质心法(intensity centroid)确定方向
图像块的矩:\(m_{pq} = \sum_{x,y} x^p y^q I(x,y)\)
质心:\(C = \left(\dfrac{m_{10}}{m_{00}},\ \dfrac{m_{01}}{m_{00}}\right)\)
方向:\(\theta = \arctan\left(m_{01}/m_{10}\right)\)
2. BRIEF 描述子
二进制描述子,由 0/1 组成,长度 128 或 256 位。做法是比较关键点附近两个随机像素 \(p\)、\(q\) 的灰度大小关系。
- 用汉明距离度量相似度,速度极快
- ORB 使用 Steer BRIEF,按关键点方向旋转采样模式,从而具备旋转不变性
3. 特征匹配
- 暴力匹配(Brute-Force):计算所有描述子之间的距离并排序
- 快速近似最近邻(FLANN):适合特征点数量极多时
距离度量:浮点描述子用欧氏距离,二进制描述子用汉明距离。
经验筛选:设定最小距离的 2 倍作为阈值,或使用比率测试(ratio test)。
三、2D-2D:对极几何
1. 对极约束
设空间点 \(P\) 在两幅图像上的归一化坐标为 \(\mathbf{x}_1, \mathbf{x}_2\),像素坐标为 \(\mathbf{p}_1,\mathbf{p}_2\):
\[ \mathbf{x}_2^T \boldsymbol{E}\, \mathbf{x}_1 = 0, \qquad \mathbf{p}_2^T \boldsymbol{F}\, \mathbf{p}_1 = 0 \]
- 本质矩阵 \(\boldsymbol{E} = \boldsymbol{t}^{\wedge}\boldsymbol{R}\),\(3\times3\),尺度等价,5 个自由度
- 基础矩阵 \(\boldsymbol{F} = \boldsymbol{K}^{-T}\boldsymbol{E}\boldsymbol{K}^{-1}\)
相关术语:极点、极线、基线、极平面。
2. 八点法(Eight-point Algorithm)
\(\boldsymbol{E}\) 因尺度等价有 8 个未知量,可以用线性方程求解。
由 \(\boldsymbol{E}\) 恢复 \(\boldsymbol{R},\boldsymbol{t}\) 使用 SVD 分解 \(\boldsymbol{E} = \boldsymbol{U}\boldsymbol{\Sigma}\boldsymbol{V}^T\),会得到 4 组可能解,通过「三角化后点的深度必须为正」来筛选出唯一解。
\(\boldsymbol{E}\) 的内在性质:奇异值必为 \([\sigma, \sigma, 0]^T\) 的形式。
3. 单应矩阵 H
描述两个平面之间的映射关系,在特征点共面或纯旋转时使用:
\[ \mathbf{p}_2 = \boldsymbol{H}\,\mathbf{p}_1 \]
8 个自由度,用四点法求解,分解后同样得到 4 组解。实践中常同时估计 \(\boldsymbol{F},\boldsymbol{E},\boldsymbol{H}\),选择重投影误差最小的那个。
4. 几个讨论点
- 尺度不确定性:单目 SLAM 的平移只有方向、没有单位,通常固定初始化时的尺度(归一化 \(\boldsymbol{t}\) 或深度均值)
- 纯旋转问题:\(\boldsymbol{t} = 0\) 时 \(\boldsymbol{E}\) 为零,无法求解,必须改用 \(\boldsymbol{H}\)
- 多于八对点:用最小二乘,或用 RANSAC 处理误匹配
四、三角测量(Triangulation)
目的是由两处观测的视线交点估计深度。已知 \(\boldsymbol{R},\boldsymbol{t}\),求解
\[ s_1\mathbf{x}_1 = s_2\boldsymbol{R}\mathbf{x}_2 + \boldsymbol{t} \]
两边左乘 \(\mathbf{x}_1^{\wedge}\):
\[ s_1\mathbf{x}_1^{\wedge}\mathbf{x}_1 = 0 = s_2\,\mathbf{x}_1^{\wedge}\boldsymbol{R}\mathbf{x}_2 + \mathbf{x}_1^{\wedge}\boldsymbol{t} \]
因为存在噪声,通常用最小二乘(SVD)求解。
一个内在矛盾:平移越大,深度估计精度越高,但同时图像外观变化也越大、匹配越困难——这就是视差(parallax)问题。另外,纯旋转时无法使用三角测量。
五、3D-2D:PnP(Perspective-n-Point)
已知 3D 点及其 2D 投影,求相机位姿。这是最重要、最常用的方法。
1. 直接线性变换(DLT)
每个特征点提供 2 个线性约束,12 个未知量需要 6 对点。把 \(\boldsymbol{R}\) 当作 12 个独立未知数(忽略正交约束)求解,之后需要对 \(\boldsymbol{R}\) 做 QR 分解,投影回 \(SE(3)\)。
2. P3P
使用 3 对点加 1 对验证点,利用相似三角形和余弦定理,转化为二元二次方程求解。
缺点:只用 3 组点,无法利用更多信息;点受噪声影响时结果不稳定。
其他方法:EPnP、UPnP、AP3P 等,可以利用更多点并做迭代优化。
3. Bundle Adjustment(非线性优化)
构建最小化重投影误差的问题:
\[ \boldsymbol{\xi}^* = \operatorname*{argmin}_{\boldsymbol{\xi}} \frac{1}{2}\sum_{i=1}^{n} \left\| \mathbf{u}_i - \frac{1}{s_i}\boldsymbol{K}\exp(\boldsymbol{\xi}^{\wedge})\boldsymbol{P}_i \right\|_2^2 \]
误差关于位姿的雅可比(左乘扰动模型):
\[ \frac{\partial \mathbf{e}}{\partial \delta\boldsymbol{\xi}} = -\begin{bmatrix} \frac{f_x}{Z'} & 0 & -\frac{f_x X'}{Z'^2} & -\frac{f_x X' Y'}{Z'^2} & f_x + \frac{f_x X'^2}{Z'^2} & -\frac{f_x Y'}{Z'} \\ 0 & \frac{f_y}{Z'} & -\frac{f_y Y'}{Z'^2} & -f_y - \frac{f_y Y'^2}{Z'^2} & \frac{f_y X' Y'}{Z'^2} & \frac{f_y X'}{Z'} \end{bmatrix} \]
误差关于空间点的雅可比:
\[ \frac{\partial \mathbf{e}}{\partial \boldsymbol{P}} = -\begin{bmatrix} \frac{f_x}{Z'} & 0 & -\frac{f_x X'}{Z'^2} \\ 0 & \frac{f_y}{Z'} & -\frac{f_y Y'}{Z'^2} \end{bmatrix}\boldsymbol{R} \]
实践中常用 g2o 或 Ceres 求解。
六、3D-3D:ICP
已知两组已配对的 3D 点,求 \(\boldsymbol{R},\boldsymbol{t}\) 使 \(\mathbf{p}_i = \boldsymbol{R}\mathbf{p}_i' + \boldsymbol{t}\)。
1. SVD 方法
- 计算两组点的质心 \(\mathbf{p},\mathbf{p}'\),得去质心坐标 \(\mathbf{q}_i = \mathbf{p}_i - \mathbf{p}\),\(\mathbf{q}_i' = \mathbf{p}_i' - \mathbf{p}'\)
- 计算 \(\boldsymbol{W} = \sum_{i=1}^{n}\mathbf{q}_i\mathbf{q}_i'^T\)
- 对 \(\boldsymbol{W}\) 做 SVD:\(\boldsymbol{W} = \boldsymbol{U}\boldsymbol{\Sigma}\boldsymbol{V}^T\)
- 当 \(\boldsymbol{W}\) 满秩时 \(\boldsymbol{R}^* = \boldsymbol{U}\boldsymbol{V}^T\)(若 \(\det(\boldsymbol{R}^*) < 0\) 则取 \(-\boldsymbol{R}^*\))
- \(\boldsymbol{t}^* = \mathbf{p} - \boldsymbol{R}^*\mathbf{p}'\)
推导要点:误差项可以拆分为与 \(\boldsymbol{t}\) 无关的去质心项,加上只含 \(\boldsymbol{t}\) 的项,因此可以先优化 \(\boldsymbol{R}\) 再求 \(\boldsymbol{t}\)。
2. 非线性优化方法
用李代数表达位姿迭代求解:
\[ \min_{\boldsymbol{\xi}} \frac{1}{2}\sum_i \left\|\mathbf{p}_i - \exp(\boldsymbol{\xi}^{\wedge})\mathbf{p}_i'\right\|^2, \qquad \frac{\partial \mathbf{e}}{\partial \delta\boldsymbol{\xi}} = -\big(\exp(\boldsymbol{\xi}^{\wedge})\mathbf{p}_i'\big)^{\odot} \]
因为已配对的 ICP 问题存在唯一解、不存在局部极小,所以一定能收敛到全局最优。
七、方法选择总结
| 数据情况 | 方法 |
|---|---|
| 单目初始化(2D-2D) | 对极几何(\(\boldsymbol{E}/\boldsymbol{F}/\boldsymbol{H}\))+ 三角测量 |
| RGB-D/双目/已有地图(3D-2D) | PnP(最常用、最重要) |
| RGB-D/激光(3D-3D) | ICP |
| 混合情况 | 统一到 BA 框架下优化 |
实践建议:单目 SLAM 通常初始化用对极几何,之后用 PnP + BA;深度已知的部分用 3D-2D,未知的用三角测量估计深度。
Chapter 8: 视觉里程计 2(光流法与直接法)
一、为什么需要直接法
特征点法的三个缺点:
- 关键点提取与描述子计算非常耗时——SIFT 在 CPU 上无法实时,ORB 也需要约 20ms
- 丢弃了特征点以外的所有信息——一张图有几十万像素,特征点只有几百个
- 在特征缺失处会失效——白墙、空走廊等纹理缺乏的场合提不出足够特征
三条改进思路:
- 保留关键点但不算描述子,用光流法跟踪特征点运动
- 保留关键点但不算描述子,用直接法计算特征点在下一帧的位置
- 完全不提特征,直接根据像素灰度差异计算相机运动
二、光流法(Optical Flow)
光流描述像素随时间在图像间的运动:
- 稀疏光流:只算部分像素,代表是 Lucas-Kanade(LK)光流
- 稠密光流:算所有像素,代表是 Horn-Schunck(HS)光流
1. 灰度不变假设
LK 光流的核心假设:同一个空间点的像素灰度值,在各个图像中固定不变。
\[ \boldsymbol{I}(x+\mathrm{d}x,\ y+\mathrm{d}y,\ t+\mathrm{d}t) = \boldsymbol{I}(x, y, t) \]
这是一个很强的假设,实际中很可能不成立:相机自动曝光、光照变化、非朗伯反射都会破坏它。
2. 光流方程
对左边做一阶泰勒展开:
\[ \boldsymbol{I}(x+\mathrm{d}x, y+\mathrm{d}y, t+\mathrm{d}t) \approx \boldsymbol{I}(x,y,t) + \frac{\partial \boldsymbol{I}}{\partial x}\mathrm{d}x + \frac{\partial \boldsymbol{I}}{\partial y}\mathrm{d}y + \frac{\partial \boldsymbol{I}}{\partial t}\mathrm{d}t \]
由灰度不变假设,两边相等,故
\[ \frac{\partial \boldsymbol{I}}{\partial x}\mathrm{d}x + \frac{\partial \boldsymbol{I}}{\partial y}\mathrm{d}y + \frac{\partial \boldsymbol{I}}{\partial t}\mathrm{d}t = 0 \]
两边除以 \(\mathrm{d}t\):
\[ \boldsymbol{I}_x u + \boldsymbol{I}_y v = -\boldsymbol{I}_t \qquad\text{即}\qquad \begin{bmatrix} \boldsymbol{I}_x & \boldsymbol{I}_y \end{bmatrix}\begin{bmatrix} u \\ v \end{bmatrix} = -\boldsymbol{I}_t \]
其中 \(u = \mathrm{d}x/\mathrm{d}t\)、\(v = \mathrm{d}y/\mathrm{d}t\) 是像素运动速度,\(\boldsymbol{I}_x,\boldsymbol{I}_y\) 是图像梯度,\(\boldsymbol{I}_t\) 是灰度对时间的变化量。
3. 空间一致性假设与求解
一个方程两个未知量,无法求解,所以 LK 光流假设某个窗口内的像素具有相同的运动。
取 \(w \times w\) 的窗口,得到 \(w^2\) 个方程:
\[ \boldsymbol{A} = \begin{bmatrix} [\boldsymbol{I}_x, \boldsymbol{I}_y]_1 \\ \vdots \\ [\boldsymbol{I}_x, \boldsymbol{I}_y]_{w^2}\end{bmatrix}, \qquad \boldsymbol{b} = \begin{bmatrix} \boldsymbol{I}_{t1} \\ \vdots \\ \boldsymbol{I}_{tw^2} \end{bmatrix} \]
于是 \(\boldsymbol{A}[u,v]^T = -\boldsymbol{b}\) 是一个超定方程,取最小二乘解:
\[ \begin{bmatrix} u \\ v \end{bmatrix}^* = -(\boldsymbol{A}^T\boldsymbol{A})^{-1}\boldsymbol{A}^T\boldsymbol{b} \]
4. 实践要点
- 多层金字塔光流:相机运动较快时单层光流容易陷入局部极小。采用由粗至精(coarse-to-fine):先在分辨率最低的顶层计算,把结果作为下一层的初始值。顶层图像中像素运动看起来小,更容易找到正确解。
- 正向 vs 反向光流:反向光流中雅可比在整个迭代过程中保持不变(用第一幅图的梯度),可以预先计算,节省开销。
结论:光流法可以避免计算和匹配描述子,从而加速基于特征点的 VO,但要求相机运动较慢(或采集频率较高)。
三、直接法(Direct Method)
1. 与特征点法的区别
考虑空间点 \(P\) 在两个相机上的成像 \(\mathbf{p}_1,\mathbf{p}_2\):
\[ \mathbf{p}_1 = \frac{1}{Z_1}\boldsymbol{K}\boldsymbol{P}, \qquad \mathbf{p}_2 = \frac{1}{Z_2}\boldsymbol{K}(\boldsymbol{R}\boldsymbol{P}+\boldsymbol{t}) = \frac{1}{Z_2}\boldsymbol{K}(\boldsymbol{T}\boldsymbol{P})_{1:3} \]
- 特征点法:通过匹配描述子已经知道 \(\mathbf{p}_1,\mathbf{p}_2\) 的像素位置,因此可以算重投影误差。
- 直接法:没有特征匹配,无从知道哪个 \(\mathbf{p}_2\) 与 \(\mathbf{p}_1\) 对应同一个点。思路是根据当前位姿估计值去寻找 \(\mathbf{p}_2\) 的位置;若位姿不够好,\(\mathbf{p}_2\) 的外观会和 \(\mathbf{p}_1\) 有明显差别,于是通过优化位姿来找到与 \(\mathbf{p}_1\) 更相似的 \(\mathbf{p}_2\)。
2. 光度误差(Photometric Error)
直接法优化的目标不再是重投影误差,而是光度误差——两个像的亮度之差(注意这是一个标量):
\[ e = \boldsymbol{I}_1(\mathbf{p}_1) - \boldsymbol{I}_2(\mathbf{p}_2) \]
对 \(N\) 个空间点:
\[ \min_{\boldsymbol{T}} J(\boldsymbol{T}) = \sum_{i=1}^{N} e_i^T e_i, \qquad e_i = \boldsymbol{I}_1(\mathbf{p}_{1,i}) - \boldsymbol{I}_2(\mathbf{p}_{2,i}) \]
能做这种优化的依据,同样是灰度不变假设。
3. 雅可比推导
用李代数扰动模型,给 \(\exp(\boldsymbol{\xi}^\wedge)\) 左乘小扰动 \(\exp(\delta\boldsymbol{\xi}^\wedge)\),记
\[ \mathbf{q} = \delta\boldsymbol{\xi}^\wedge \exp(\boldsymbol{\xi}^\wedge)\boldsymbol{P}, \qquad \mathbf{u} = \frac{1}{Z_2}\boldsymbol{K}\mathbf{q} \]
一阶泰勒展开后
\[ e(\boldsymbol{\xi} \oplus \delta\boldsymbol{\xi}) \approx e(\boldsymbol{\xi}) - \frac{\partial \boldsymbol{I}_2}{\partial \mathbf{u}}\frac{\partial \mathbf{u}}{\partial \mathbf{q}}\frac{\partial \mathbf{q}}{\partial \delta\boldsymbol{\xi}}\delta\boldsymbol{\xi} \]
三项分别是:
\(\dfrac{\partial \boldsymbol{I}_2}{\partial \mathbf{u}}\) 是 \(\mathbf{u}\) 处的像素梯度(\(1\times2\))
\(\dfrac{\partial \mathbf{u}}{\partial \mathbf{q}}\) 是投影方程对相机系三维点的导数,记 \(\mathbf{q} = [X,Y,Z]^T\):
\[ \frac{\partial \mathbf{u}}{\partial \mathbf{q}} = \begin{bmatrix} \frac{f_x}{Z} & 0 & -\frac{f_x X}{Z^2} \\ 0 & \frac{f_y}{Z} & -\frac{f_y Y}{Z^2} \end{bmatrix} \]
- \(\dfrac{\partial \mathbf{q}}{\partial \delta\boldsymbol{\xi}} = [\boldsymbol{I},\ -\mathbf{q}^\wedge]\)
后两项只与三维点有关、与图像无关,实践中常合并:
\[ \frac{\partial \mathbf{u}}{\partial \delta\boldsymbol{\xi}} = \begin{bmatrix} \frac{f_x}{Z} & 0 & -\frac{f_x X}{Z^2} & -\frac{f_x XY}{Z^2} & f_x + \frac{f_x X^2}{Z^2} & -\frac{f_x Y}{Z} \\ 0 & \frac{f_y}{Z} & -\frac{f_y Y}{Z^2} & -f_y - \frac{f_y Y^2}{Z^2} & \frac{f_y XY}{Z^2} & \frac{f_y X}{Z} \end{bmatrix} \]
这与第七讲中 PnP 的位姿雅可比形式完全一致。于是
\[ \boldsymbol{J} = -\frac{\partial \boldsymbol{I}_2}{\partial \mathbf{u}}\frac{\partial \mathbf{u}}{\partial \delta\boldsymbol{\xi}} \]
然后用高斯牛顿或 L-M 迭代求解即可。
4. 直接法的分类
按 \(P\) 的来源分类:
| 类型 | \(P\) 的来源 | 特点 |
|---|---|---|
| 稀疏直接法 | 数百至上千个关键点 | 不算描述子,速度最快,只能稀疏重构 |
| 半稠密直接法 | 只用有梯度的像素 | 舍弃梯度不明显处,可重构半稠密结构 |
| 稠密直接法 | 所有像素 | 几十万到几百万点,CPU 难以实时,需 GPU |
梯度不明显的点在运动估计中贡献很小,重构时位置也难以确定。
5. 实现细节
- 双线性插值:投影后的像素坐标是浮点数,需要插值求亚像素灰度值
- 图像金字塔:与光流类似,由粗到精优化,缓解非凸性
- 小 patch:实践中常取 \(P\) 周围 \(3\times3\) 或 \(4\times4\) 的 patch 比较,增强鲁棒性
四、直接法的优缺点
优点:
- 省去计算特征点和描述子的时间
- 只要求有像素梯度即可,无须特征点,因此可用于特征缺失的场合(极端例子是只有渐变的图像)
- 可以构建半稠密乃至稠密地图,这是特征点法做不到的
缺点:
- 非凸性:完全依靠梯度搜索降低目标函数,而图像是强烈非凸的函数,容易陷入极小值,只在运动很小时才能成功。金字塔可以部分缓解。
- 单个像素没有区分度:像它的像素太多了。于是要么计算图像块,要么计算复杂的相关性——每个像素对相机运动的「意见」不一致,只能少数服从多数,以数量代替质量。
- 灰度不变是很强的假设:自动曝光或光照变化会使整体变亮变暗,破坏灰度不变假设。特征点法对光照有一定容忍性,直接法则会直接失败。目前的直接法开始引入先验的相机感光度模型(photometric calibration),例如 DSO 就对曝光时间和响应函数做了建模。
五、相关经典工作
| 方法 | 类型 | 特点 |
|---|---|---|
| SVO | 稀疏直接法 | Forster et al., 2014,速度极快,可在无人机上运行 |
| LSD-SLAM | 半稠密直接法 | Engel et al., 2014,使用梯度明显的像素 |
| DSO | 稀疏直接法 | Engel et al., 2016,引入光度标定与滑动窗口优化 |
| DTAM | 稠密直接法 | Newcombe et al., 2011,需 GPU |
Chapter 9: 实践——设计前端
这一讲是工程实践章节(官方代码放在 project/ 目录下,而非
ch9/),把前面两讲的内容组织成一个可运行的双目/RGB-D
视觉里程计。要点是软件架构而非新算法:
基本数据结构
Frame:一帧,含 id、时间戳、位姿、图像、提取到的特征MapPoint:地图路标点,含世界坐标、被观测次数、描述子Map:管理所有Frame与MapPoint,区分「激活的」局部地图与全局地图Camera:内参与坐标变换(世界系 ↔︎ 相机系 ↔︎ 像素系)
前端流程(VisualOdometry 状态机)
INITIALIZING:第一帧,提取特征、三角化初始化地图点TRACKING_GOOD/TRACKING_BAD:对新帧提特征、与地图点匹配,用 PnP + BA 估计位姿LOST:内点数量过少则判定丢失,需要重定位
关键工程问题
- 关键帧的选取:不是每帧都插入地图,通常按平移/旋转量或跟踪到的特征比例来判定
- 地图点的管理:新三角化的点加入地图,长期观测不到的点剔除,避免地图无限膨胀
- 优化的范围:只优化「激活」的若干关键帧和它们观测到的地图点(局部 BA),而不是全局优化,以保证实时性
- 多线程:前端跟踪与后端优化分离在不同线程,用互斥锁保护共享的
Map
Chapter 10: 后端 1
一、概述
1. 状态估计的概率解释
重温运动和观测方程:
\[ \begin{cases} \boldsymbol{x}_k=f\left(\boldsymbol{x}_{k-1},\boldsymbol{u}_k\right)+\boldsymbol{w}_k\\ \boldsymbol{z}_{k,j}=h\left(\boldsymbol{y}_j,\boldsymbol{x}_k\right)+\boldsymbol{v}_{k,j} \end{cases} \quad k=1,\ldots,N,\ j=1,\ldots,M \]
实际中观测方程数量会远远大于运动方程数量。
现定义
\[ \boldsymbol{x}_k\triangleq\{\boldsymbol{x}_k,\boldsymbol{y}_1,\ldots,\boldsymbol{y}_m\} \]
它包含当前时刻的相机位姿和 \(m\) 个路标点,于是运动和观测方程变为
\[ \begin{cases} \boldsymbol{x}_k=f\left(\boldsymbol{x}_{k-1},\boldsymbol{u}_k\right)+\boldsymbol{w}_k\\ \boldsymbol{z}_k=h\left(\boldsymbol{x}_k\right)+\boldsymbol{v}_k \end{cases} \quad k=1,\ldots,N \]
我们希望用过去的数据估计当前的状态分布:
\[ P(\boldsymbol{x}_k\mid\boldsymbol{x}_0,\boldsymbol{u}_{1:k},\boldsymbol{z}_{1:k}) \]
通过贝叶斯公式:
\[ P\left(\boldsymbol{x}_{k}\mid\boldsymbol{x}_{0},\boldsymbol{u}_{1:k},\boldsymbol{z}_{1:k}\right)\propto P\left(\boldsymbol{z}_{k}\mid\boldsymbol{x}_{k}\right)P\left(\boldsymbol{x}_{k}\mid\boldsymbol{x}_{0},\boldsymbol{u}_{1:k},\boldsymbol{z}_{1:k-1}\right) \]
通过全概率公式:
\[ P\left(\boldsymbol{x}_{k}\mid\boldsymbol{x}_{0},\boldsymbol{u}_{1:k},\boldsymbol{z}_{1:k-1}\right)=\int P\left(\boldsymbol{x}_{k}\mid\boldsymbol{x}_{k-1},\boldsymbol{x}_{0},\boldsymbol{u}_{1:k},\boldsymbol{z}_{1:k-1}\right)P\left(\boldsymbol{x}_{k-1}\mid\boldsymbol{x}_{0},\boldsymbol{u}_{1:k},\boldsymbol{z}_{1:k-1}\right)\mathrm{d}\boldsymbol{x}_{k-1} \]
2. 线性系统和 KF
假设 \(k\) 时刻状态只与 \(k-1\) 时刻状态有关(马尔可夫性),每一时刻的状态更新都是上面这种递推形式。若运动和观测方程可以由线性方程描述:
\[ \begin{cases} \boldsymbol{x}_k=\boldsymbol{A}_k\boldsymbol{x}_{k-1}+\boldsymbol{u}_k+\boldsymbol{w}_k\\ \boldsymbol{z}_k=\boldsymbol{C}_k\boldsymbol{x}_k+\boldsymbol{v}_k \end{cases} \quad k=1,\ldots,N, \qquad \boldsymbol{w}_k\sim N(\mathbf{0},\boldsymbol{R}),\quad\boldsymbol{v}_k\sim N(\mathbf{0},\boldsymbol{Q}) \]
卡尔曼滤波:
预测
\[ \bar{\boldsymbol{x}}_k=\boldsymbol{A}_k\hat{\boldsymbol{x}}_{k-1}+\boldsymbol{u}_k, \qquad \bar{\boldsymbol{P}}_k=\boldsymbol{A}_k\hat{\boldsymbol{P}}_{k-1}\boldsymbol{A}_k^T+\boldsymbol{R} \]
更新
\[ \begin{aligned} &\boldsymbol{K}=\bar{\boldsymbol{P}}_k\boldsymbol{C}_k^T\left(\boldsymbol{C}_k\bar{\boldsymbol{P}}_k\boldsymbol{C}_k^T+\boldsymbol{Q}\right)^{-1} \\ &\hat{\boldsymbol{x}}_k=\bar{\boldsymbol{x}}_k+\boldsymbol{K}\left(\boldsymbol{z}_k-\boldsymbol{C}_k\bar{\boldsymbol{x}}_k\right)\\ &\hat{\boldsymbol{P}}_k=\left(\boldsymbol{I}-\boldsymbol{K}\boldsymbol{C}_k\right)\bar{\boldsymbol{P}}_k \end{aligned} \]
3. 非线性系统和 EKF
SLAM 中的运动方程和观测方程通常是非线性函数,所以 EKF 是在某个点附近对运动方程和观测方程做一阶泰勒展开:
\[ \begin{aligned} &\boldsymbol{K}_k=\bar{\boldsymbol{P}}_k\boldsymbol{H}^\mathrm{T}\left(\boldsymbol{H}\bar{\boldsymbol{P}}_k\boldsymbol{H}^\mathrm{T}+\boldsymbol{Q}_k\right)^{-1} \\ &\hat{\boldsymbol{x}}_k=\bar{\boldsymbol{x}}_k+\boldsymbol{K}_k\left(\boldsymbol{z}_k-h\left(\bar{\boldsymbol{x}}_k\right)\right), \qquad \hat{\boldsymbol{P}}_k=\left(\boldsymbol{I}-\boldsymbol{K}_k\boldsymbol{H}\right)\bar{\boldsymbol{P}}_k \end{aligned} \]
EKF 的局限:
- 滤波器方法在一定程度上假设了马尔可夫性
- 一次泰勒展开不一定能代表模型
- EKF 需要存储状态量的均值和方差,并对它们进行维护和更新(计算量大)
二、BA 和图优化
1. 投影模型和 BA 代价函数
从三维点到像素坐标也就是观测方程:\(\boldsymbol{z}=h(\boldsymbol{x},\boldsymbol{y})\)。
这里的 \(\boldsymbol{x}\) 指代此时相机的位姿,即外参 \(\boldsymbol{R},\boldsymbol{t}\),它对应的李代数为 \(\boldsymbol{\xi}\);路标 \(\boldsymbol{y}\) 即这里的三维点 \(\boldsymbol{p}\);而观测数据是像素坐标 \(\boldsymbol{z}\triangleq[u_{s},v_{s}]^{T}\)。
代价函数:
\[ \frac12\sum_{i=1}^m\sum_{j=1}^n\|\boldsymbol{e}_{ij}\|^2=\frac12\sum_{i=1}^m\sum_{j=1}^n\|\boldsymbol{z}_{ij}-h(\boldsymbol{\xi}_i,\boldsymbol{p}_j)\|^2 \]
对这个最小二乘进行求解,相当于对位姿和路标同时作了调整,也就是所谓的 BA。其中 \(\boldsymbol{z}_{ij}\) 是观测点(观测数据),\(h(\boldsymbol{\xi}_i,\boldsymbol{p}_j)\) 是计算出来的像素点坐标。
2. BA 的求解
将自变量定义为所有待优化的变量:
\[ \boldsymbol{x}=[\boldsymbol{\xi}_1,\ldots,\boldsymbol{\xi}_m,\boldsymbol{p}_1,\ldots,\boldsymbol{p}_n]^T \]
目标函数为
\[ \frac12\left\|f(\boldsymbol{x}+\Delta\boldsymbol{x})\right\|^2\approx\frac12\sum_{i=1}^m\sum_{j=1}^n\left\|\boldsymbol{e}_{ij}+\boldsymbol{F}_{ij}\Delta\boldsymbol{\xi}_i+\boldsymbol{E}_{ij}\Delta\boldsymbol{p}_j\right\|^2 \]
(具体见第六章和第七章。)
需要解决 \(\boldsymbol{H}\Delta\boldsymbol{x}=\boldsymbol{g}\)。关于求解,可以使用 G-N、L-M 算法等。在 Gauss-Newton 中:
\[ \boldsymbol{J}=[\boldsymbol{F}\ \ \boldsymbol{E}], \qquad \boldsymbol{H}=\boldsymbol{J}^T\boldsymbol{J}=\begin{bmatrix}\boldsymbol{F}^T\boldsymbol{F}&\boldsymbol{F}^T\boldsymbol{E}\\\boldsymbol{E}^T\boldsymbol{F}&\boldsymbol{E}^T\boldsymbol{E}\end{bmatrix} \]
3. 稀疏性和边缘化
一个重大发现是:\(\boldsymbol{H}\) 可以自然、显式地用图优化来表示。
\(\boldsymbol{H}\) 矩阵中非对角部分的非零矩阵块,可以理解为它对应的两个变量之间存在联系,或者称之为约束。
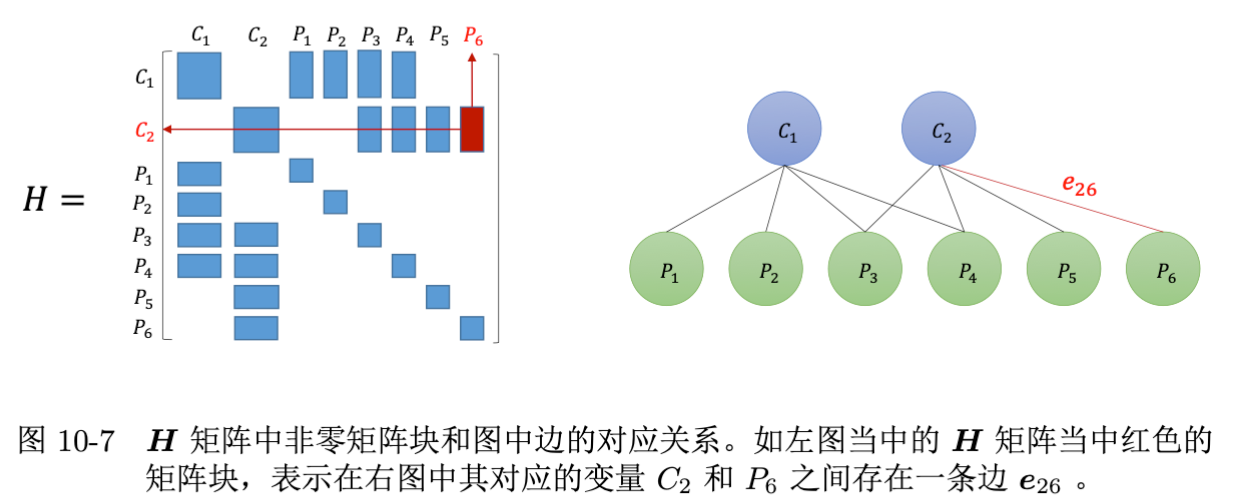
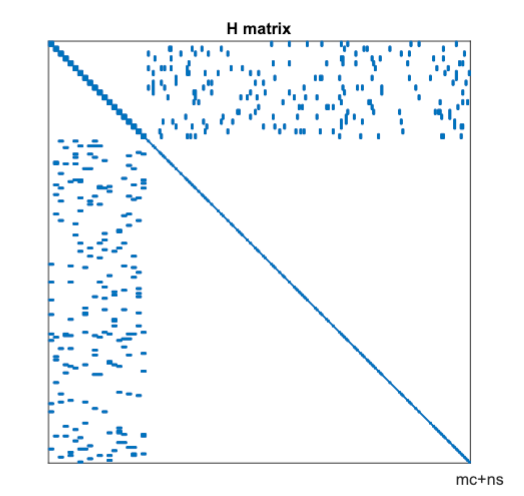
上图是一般情况下的 \(\boldsymbol{H}\) 矩阵。现实中存在若干种利用 \(\boldsymbol{H}\) 的稀疏性加速计算的方法,本章介绍最常用的:Schur 消元(Schur trick),也叫 Marginalization。
对应的 \(\boldsymbol{H}\Delta\boldsymbol{x}=\boldsymbol{g}\) 变为
\[ \begin{bmatrix}\boldsymbol{B}&\boldsymbol{E}\\\boldsymbol{E}^T&\boldsymbol{C}\end{bmatrix} \begin{bmatrix}\Delta\boldsymbol{x}_c\\\Delta\boldsymbol{x}_p\end{bmatrix} =\begin{bmatrix}\boldsymbol{v}\\\boldsymbol{w}\end{bmatrix} \]
高斯消元后:
\[ \begin{aligned} &\left[\boldsymbol{B}-\boldsymbol{E}\boldsymbol{C}^{-1}\boldsymbol{E}^T\right]\Delta\boldsymbol{x}_c=\boldsymbol{v}-\boldsymbol{E}\boldsymbol{C}^{-1}\boldsymbol{w} \\ &\Delta\boldsymbol{x}_p=\boldsymbol{C}^{-1}(\boldsymbol{w}-\boldsymbol{E}^T\Delta\boldsymbol{x}_c) \end{aligned} \]
以上求解过程称为 Marginalization 或 Schur 消元。
在做 BA 时会刻意选择那些具有共同观测的帧作为关键帧。在这种情况下,Schur 消元后得到的 \(\boldsymbol{S}\) 就是稠密矩阵,可以用共轭梯度法求解。
4. 鲁棒核函数
存在一个严重的问题:如果出于误匹配等原因,某个误差项的数据是错误的,它会主导整个优化。核函数保证每条边的误差不会大得没边、掩盖掉其他的边。具体做法是:把原先误差的二范数度量,替换成一个增长没有那么快的函数,同时保证自身的光滑性质。
Chapter 11: 后端 2
一、位姿图(Pose Graph)
1. Pose Graph 的意义
我们更倾向于在优化几次之后就把特征点固定住,只把它们看作位姿估计的约束,而不再实际优化它们的位置估计。这样完全可以构建一个只有轨迹的图优化,而位姿节点之间的边,可以由两个关键帧之间通过特征匹配得到的运动估计来给定初始值。
2. Pose Graph 的优化
这里的节点表示相机位姿,以 \(\boldsymbol{\xi}_1,\ldots,\boldsymbol{\xi}_n\) 表达;而边则是两个位姿节点之间相对运动的估计。总体目标函数为
\[ \min_{\boldsymbol{\xi}}\frac12\sum_{i,j\in\mathcal{E}}\boldsymbol{e}_{ij}^T\boldsymbol{\Sigma}_{ij}^{-1}\boldsymbol{e}_{ij} \]
二、因子图优化初步
1. 贝叶斯网络
SLAM 问题本身可以写成一个贝叶斯网络:位姿节点 \(\boldsymbol{x}_k\) 之间由运动方程连接,位姿与路标 \(\boldsymbol{y}_j\) 之间由观测方程连接,联合分布分解为
\[ P(\boldsymbol{x}_{0:N},\boldsymbol{y}_{1:M},\boldsymbol{z},\boldsymbol{u}) = P(\boldsymbol{x}_0)\prod_{k=1}^{N}P(\boldsymbol{x}_k\mid\boldsymbol{x}_{k-1},\boldsymbol{u}_k)\prod_{k,j}P(\boldsymbol{z}_{k,j}\mid\boldsymbol{x}_k,\boldsymbol{y}_j) \]
求最大后验估计(MAP)就是最大化上式,取负对数后即变成前面熟悉的最小二乘问题。
2. 因子图
因子图是一种二部无向图,由两种节点组成:
- 变量节点:表示待优化的变量(位姿、路标)
- 因子节点:表示一个概率因子,即一项约束(先验、运动约束、观测约束)
每个因子节点只与它所涉及的变量节点相连,整个后验被表示为所有因子的乘积:
\[ P(\boldsymbol{\Theta}\mid\boldsymbol{Z}) \propto \prod_i \phi_i(\boldsymbol{\Theta}_i) \]
其中 \(\boldsymbol{\Theta}_i\) 是第 \(i\) 个因子涉及的变量子集。
与位姿图的关系:位姿图可以看成因子图的一个特例——只保留位姿变量,边(相对运动约束)就是二元因子。
为什么用因子图:它把「哪些变量被哪条约束耦合」显式画了出来,从而
- 直接对应稀疏矩阵 \(\boldsymbol{H}\) 的结构,便于分析稀疏性
- 支持增量式求解:新来一帧只增加少量因子,可以只更新受影响的部分,而不必从头重解。这是 iSAM / iSAM2 的核心思想,实现上依赖把因子图转成 Bayes tree 并做局部重线性化。
- 便于融合异构传感器:IMU 预积分、GPS、轮速计都只是往图里加一类新因子
常用库:GTSAM(因子图 + Bayes tree)、g2o(图优化)。
Appendix
A. 图优化理论
图优化是把优化问题表现成图(Graph)的一种方式。一个图由若干个顶点(Vertex),以及连接这些节点的边(Edge)组成。用顶点表示优化变量,用边表示误差项。对任意一个非线性最小二乘问题,我们都可以构建与之对应的一个图。