Reference:Computer Vision: Models, Learning, and Inference(Simon J. D. Prince)
Introduction
Computer Vision Tasks
- Reconstruction —— 从一张或多张图像构建场景的三维模型
- Camera Tracking —— 在图像序列中识别相机相对于场景的运动
- Object Detection —— 确定某类物体(例如一只狗)出现在场景中
- Segmentation —— 确定究竟哪些像素属于某个特定物体
- Scene Parsing —— 建立对场景的完整理解:每个像素上是什么物体,以及这些物体之间如何互相遮挡
- Identity Recognition —— 在找到物体(例如一张脸)之后,推断它是否是某个特定的人
- Image Enhancement —— 提高图像分辨率(super-resolution)、去噪(denoising)、填补缺失区域(in-painting)
- Generation —— 在学习了某类物体或场景之后,用模型生成该类型的新图像
- Object Tracking —— 用动态模型跟踪物体,并监测其外观随时间的变化
- Object Description —— 找到物体后建立它的特征描述,例如判断人脸的性别、年龄或表情
计算机视觉为什么难
Dimensionality of Input Space
考虑一张 VGA 分辨率(\(640\times480\))的 RGB 图像,每个像素 8 bit(256 个灰度级),则可能的图像总数是 \(256^{640\times480\times3}\)。
Vision is an inverse problem
从场景到图像的映射是多对一的:我们接收到的数据是非唯一的。那么如何确定外面究竟是什么?
Speed
30Hz 的 VGA 相机每秒接收约 27 MB 数据——如何处理这么大的数据量?
Introduction to Probability
为什么概率是适合描述计算机视觉问题的语言
在照相机里,三维世界投影到光学器件表面从而形成图像:一个关于测量参数的二维集合。我们的目标是获取这些测量参数,并用它们推断出产生这些测量的世界的性质。然而存在两个问题。
首先,测量过程有噪声干扰。我们所观察到的不是进入传感器的光线量,而是其总量的一个带噪估计。我们必须描述这些数据中的噪声,为此需要利用概率。
其次,现实世界和测量参数之间的关系一般是多对一的:现实世界的许多种配置可能对应相同的测量参数。每一种可能世界的存在概率也是用概率来表示的。
基本概念
1. 随机变量
2. 联合概率
一个联合概率分布中的相关变量可能全是离散变量,或全是连续变量,也可以兼而有之。
3. 边缘化
任意单变量的概率分布,都可以通过在联合概率分布上对其他变量求和(离散)或积分(连续)而得到:
\[ \Pr(x)=\int \Pr(x,y)\,\mathrm{d}y, \qquad \Pr(y)=\int \Pr(x,y)\,\mathrm{d}x \]
4. 条件概率
\[ \Pr(x\mid y)=\frac{\Pr(x,y)}{\Pr(y)} \]
5. 贝叶斯公式
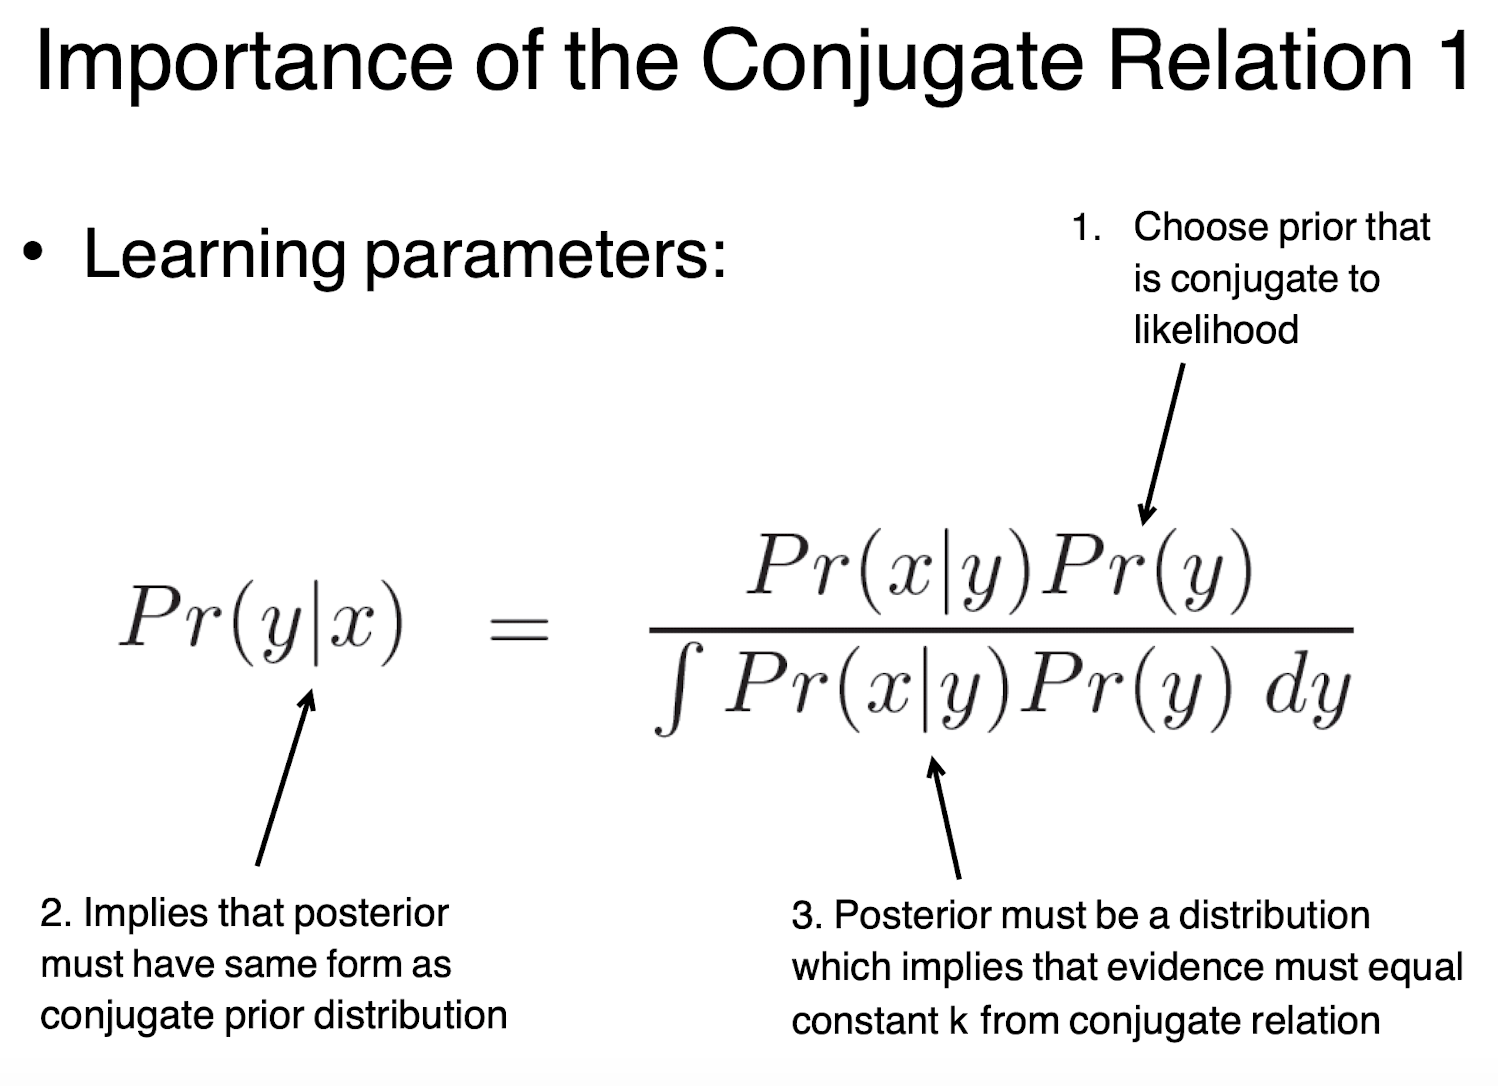
\[ \begin{aligned} \Pr(y\mid x)& =\frac{\Pr(x\mid y)\Pr(y)}{\Pr(x)} \\ &=\frac{\Pr(x\mid y)\Pr(y)}{\int \Pr(x,y)\,\mathrm{d}y} \\ &=\frac{\Pr(x\mid y)\Pr(y)}{\int \Pr(x\mid y)\Pr(y)\,\mathrm{d}y} \end{aligned} \]
其中 \(\Pr(y\mid x)\) 叫做后验概率,\(\Pr(y)\) 叫做先验概率,\(\Pr(x\mid y)\) 叫做似然性,\(\Pr(x)\) 叫做证据。
6. 独立性
如果从变量 \(x\) 不能获得关于变量 \(y\) 的任何信息(反之亦然),就称 \(x\) 和 \(y\) 是独立的:
\[ \Pr(x,y)=\Pr(x\mid y)\Pr(y)=\Pr(x)\Pr(y) \]
7. 期望
\[ \begin{aligned} &\mathrm{E}[f[x]]=\sum_{x}f[x]\Pr(x)\\ &\mathrm{E}[f[x]]=\int f[x]\Pr(x)\,\mathrm{d}x \\ &\mathrm{E}[f[x,y]]=\iint f[x,y]\Pr(x,y)\,\mathrm{d}x\,\mathrm{d}y \end{aligned} \]
| 函数 \(f[\bullet]\) | 期望 |
|---|---|
| \(x\) | 均值 \(\mu(x)\) |
| \(x^k\) | 关于零的第 \(k\) 阶矩 |
| \((x-\mu(x))^k\) | 关于均值的第 \(k\) 阶矩 |
| \((x-\mu(x))^2\) | 方差 |
| \((x-\mu(x))^3\) | 偏度(skew) |
| \((x-\mu(x))^4\) | 峰度(kurtosis) |
| \((x-\mu(x))(y - \mu(y))\) | \(x\) 和 \(y\) 的协方差 |
期望有四条性质,都可以由期望的原始定义简单证得。
若随机变量 \(x\) 是常数 \(k\),则其期望是常数本身:
\[ \mathrm{E}[k]=k \]
常数 \(k\) 与函数 \(f[x]\) 的乘积所得函数的期望,是 \(f[x]\) 期望的 \(k\) 倍:
\[ \mathrm{E}[k f[x]]=k\,\mathrm{E}[f[x]] \]
随机变量都是 \(x\) 时,函数 \(f[x]\) 和 \(g[x]\) 相加所得函数的期望,是两个函数期望之和:
\[ \mathrm{E}[f[x]+g[x]]=\mathrm{E}[f[x]]+\mathrm{E}[g[x]] \]
当 \(x\) 与 \(y\) 独立时,函数 \(f[x]\) 和 \(g[y]\) 相乘所得函数的期望,是两个函数期望的乘积:
\[ \mathrm{E}[f[x]g[y]]=\mathrm{E}[f[x]]\,\mathrm{E}[g[y]] \]
Common Probability Distributions
| Data Type | Domain | Distribution |
|---|---|---|
| univariate, discrete, binary | \(x \in \{0, 1\}\) | Bernoulli |
| univariate, discrete, multi-valued | \(x \in \{1, 2, \ldots, K\}\) | categorical |
| univariate, continuous, unbounded | \(x \in \mathbb{R}\) | univariate normal |
| univariate, continuous, bounded | \(x \in [0, 1]\) | beta |
| multivariate, continuous, unbounded | \(x \in \mathbb{R}^K\) | multivariate normal |
| multivariate, continuous, bounded, sums to one | \(x = [x_1, \ldots, x_K]^T\), \(x_k \in [0, 1]\), \(\sum_{k=1}^K x_k = 1\) | Dirichlet |
| bivariate, continuous, \(x_1\) unbounded, \(x_2\) bounded below | \(x = [x_1, x_2]\), \(x_1 \in \mathbb{R}\), \(x_2 \in \mathbb{R}^+\) | normal-scaled inverse gamma |
| multivariate vector \(x\) and matrix \(X\), \(x\) unbounded, \(X\) square, positive definite | \(x \in \mathbb{R}^K\), \(X \in \mathbb{R}^{K \times K}\), \(z^TXz > 0\ \forall z \neq 0\) | normal inverse Wishart |
Table 3.1 Common probability distributions:分布的选择取决于要建模的数据类型/定义域。
| Distribution | Domain | Parameters modeled by |
|---|---|---|
| Bernoulli | \(x \in \{0, 1\}\) | beta |
| categorical | \(x \in \{1, 2, \ldots, K\}\) | Dirichlet |
| univariate normal | \(x \in \mathbb{R}\) | normal inverse gamma |
| multivariate normal | \(x \in \mathbb{R}^K\) | normal inverse Wishart |
Table 3.2 用于建模的常见分布(左)及其定义域(中)。对每个分布,都有第二个关于其参数的关联分布(右)。
伯努利分布
是二项试验的一个离散分布模型:
\[ \begin{cases} \Pr(x=0)=1-\lambda\\ \Pr(x=1)=\lambda \end{cases} \ \Rightarrow\ \Pr(x)=\lambda^x(1-\lambda)^{1-x} \ \Rightarrow\ \Pr(x)=\mathrm{Bern}_x[\lambda] \]
Beta 分布
Beta 分布是由单变量 \(\lambda\) 定义的连续分布,这里 \(\lambda\in[0,1]\)。因此它适合表示伯努利分布中参数 \(\lambda\) 的不确定性:
\[ \Pr(\lambda)=\frac{\Gamma[\alpha+\beta]}{\Gamma[\alpha]\Gamma[\beta]}\lambda^{\alpha-1}(1-\lambda)^{\beta-1} \ \Rightarrow\ \Pr(\lambda)=\mathrm{Beta}_\lambda[\alpha,\beta] \]
其中 \(\alpha,\beta \in [0, \infty]\) 是两个参数,\(\Gamma\) 是伽马函数。
分类分布
这是一个离散分布,描述观察 \(K\) 个可能结果的概率。观察 \(K\) 种可能结果的概率存储在 \(K\times1\) 的参数向量 \(\lambda=[\lambda_1,\lambda_2,\ldots,\lambda_K]\) 中:
\[ \Pr(x=k)=\lambda_k \ \Rightarrow\ \Pr(x)=\mathrm{Cat}_x[\lambda] \]
狄利克雷分布
定义在 \(K\) 个连续值 \(\lambda_1,\ldots,\lambda_K\) 上,其中 \(\lambda_k\in[0,1],\ \sum_{k=1}^K\lambda_k=1\)。狄利克雷分布适合定义分类分布中参数的分布。
下面式子是联合分布:
\[ \Pr(\lambda_{1\cdots K})=\frac{\Gamma\big[\sum_{k=1}^K\alpha_k\big]}{\prod_{k=1}^K\Gamma[\alpha_k]}\prod_{k=1}^K\lambda_k^{\alpha_k-1} \ \Rightarrow\ \Pr(\lambda_{1\cdots K})=\mathrm{Dir}_{\lambda_{1\cdots K}}[\alpha_{1\cdots K}] \]
一元正态分布
由一个连续值 \(x\in(-\infty, \infty)\) 定义,有两个参数:均值 \(\mu\) 和方差 \(\sigma^2\)。
\[ \Pr(x)=\frac{1}{\sqrt{2\pi\sigma^2}}\exp\left[-\frac{(x-\mu)^2}{2\sigma^2}\right] \ \Rightarrow\ \Pr(x)=\mathrm{Norm}_x[\mu,\sigma^2] \]
正态逆伽马分布
由 \(\mu\) 和 \(\sigma^2\) 两个变量定义,其中前者可取任意值,后者仅取大于零的值。该分布可以定义正态分布中均值和方差的分布。
正态逆伽马分布有 4 个参数 \(\alpha,\beta,\gamma,\delta\),前三个为正实数,最后一个可取任意值:
\[ \Pr(\mu,\sigma^2)=\frac{\sqrt{\gamma}}{\sigma\sqrt{2\pi}}\cdot\frac{\beta^{\alpha}}{\Gamma[\alpha]}\left(\frac{1}{\sigma^2}\right)^{\alpha+1}\exp\left[-\frac{2\beta+\gamma(\delta-\mu)^2}{2\sigma^2}\right] \ \Rightarrow\ \Pr(\mu,\sigma^2)=\mathrm{NormInvGam}_{\mu,\sigma^2}[\alpha,\beta,\gamma,\delta] \]
多元正态分布
由 \(D\) 维变量 \(\mathbf{x}\) 决定,其中 \(\mathbf{x}\) 的每个元素 \(x_1,\ldots,x_D\) 都是连续的任意实数:
\[ \Pr(\mathbf{x})=\frac{1}{(2\pi)^{D/2}|\boldsymbol{\Sigma}|^{1/2}}\exp\left[-\frac{1}{2}(\mathbf{x}-\boldsymbol{\mu})^{\mathrm{T}}\boldsymbol{\Sigma}^{-1}(\mathbf{x}-\boldsymbol{\mu})\right] \ \Rightarrow\ \Pr(\mathbf{x})=\mathrm{Norm}_\mathbf{x}[\boldsymbol{\mu},\boldsymbol{\Sigma}] \]
正态逆威沙特分布
用来描述多元正态分布中参数的概率分布。
正态逆威沙特分布有四个参数 \(\alpha,\boldsymbol{\Psi},\gamma,\boldsymbol{\delta}\),其中 \(\alpha,\gamma\) 是正的标量,\(\boldsymbol{\delta}\) 为 \(D\times1\) 维向量,\(\boldsymbol{\Psi}\) 是 \(D\times D\) 维正定矩阵:
\[ \Pr(\boldsymbol{\mu},\boldsymbol{\Sigma})=\frac{\gamma^{D/2}|\boldsymbol{\Psi}|^{\alpha/2}|\boldsymbol{\Sigma}|^{-(\alpha+D+2)/2}\exp\left[-\frac{1}{2}\left(\operatorname{Tr}[\boldsymbol{\Psi}\boldsymbol{\Sigma}^{-1}]+\gamma(\boldsymbol{\mu}-\boldsymbol{\delta})^\mathrm{T}\boldsymbol{\Sigma}^{-1}(\boldsymbol{\mu}-\boldsymbol{\delta})\right)\right]}{2^{\alpha D/2}(2\pi)^{D/2}\Gamma_D[\alpha/2]} \]
\[ \Downarrow \]
\[ \Pr(\boldsymbol{\mu},\boldsymbol{\Sigma})=\mathrm{NorIWis}_{\boldsymbol{\mu},\boldsymbol{\Sigma}}[\alpha,\boldsymbol{\Psi},\gamma,\boldsymbol{\delta}] \]
共轭性
Beta 分布与伯努利分布共轭,狄利克雷分布与分类分布共轭,正态逆伽马分布与一元正态分布共轭,正态逆威沙特分布与多元正态分布共轭。
当把一个分布与其共轭分布相乘时,结果正比于一个新的分布,它与共轭分布形式相同:
\[ \mathrm{Bern}_x[\lambda]\cdot\mathrm{Beta}_\lambda[\alpha,\beta]=k(x,\alpha,\beta)\cdot\mathrm{Beta}_\lambda[\tilde{\alpha},\tilde{\beta}] \]
其中 \(k\) 是缩放因子,相对于变量 \(\lambda\) 它是一个常量。
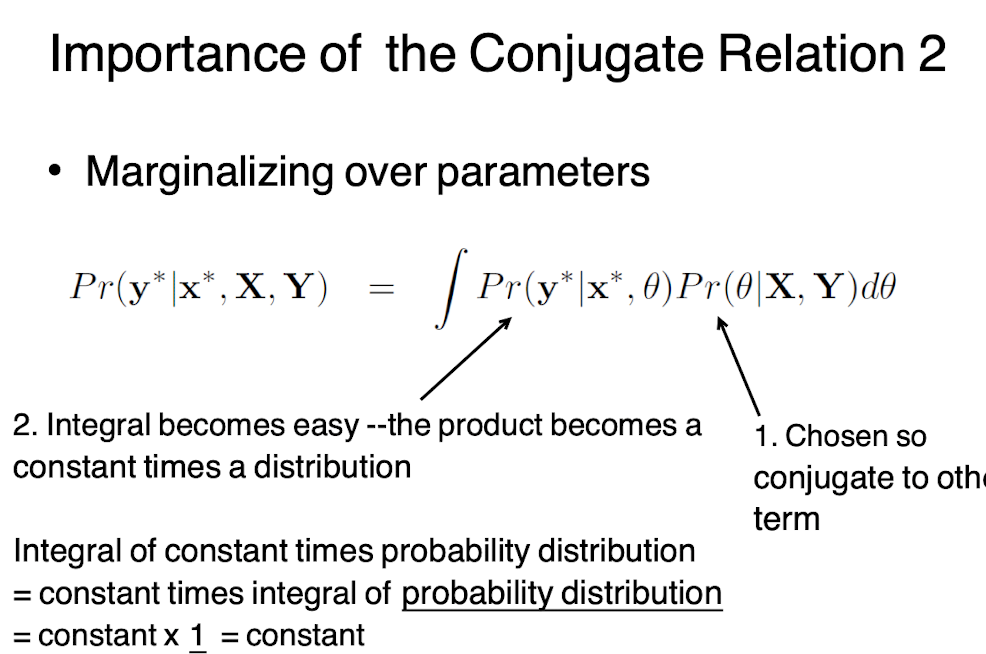
在学习(拟合分布)和评估模型(评估在拟合分布下新数据的概率)的过程中会用到分布的乘积,因此共轭关系很重要——共轭关系意味着这些乘积可以闭式求解。
Fitting Probability Models
三种方法:
- Maximum likelihood
- Maximum a posteriori
- Bayesian approach
1. Maximum likelihood
最大似然(ML)法用来求使数据 \(\{x_i\}_{i=1}^I\) 最有可能的参数集合 \(\hat{\theta}\)。
为了计算在一个数据点 \(x_i\) 处的似然函数 \(\Pr(x_i\mid\theta)\),只需简单估算在 \(x_i\) 处的概率密度函数:
\[ \begin{aligned} \hat{\boldsymbol{\theta}}&=\operatorname*{argmax}_{\boldsymbol{\theta}}\big[\Pr(\boldsymbol{x}_{1\cdots I}\mid\boldsymbol{\theta})\big]\\ &=\operatorname*{argmax}_{\boldsymbol{\theta}}\bigg[\prod_{i=1}^{I}\Pr(\boldsymbol{x}_{i}\mid\boldsymbol{\theta})\bigg] \end{aligned} \]
为了估算新数据点 \(x^*\) 的概率(即计算 \(x^*\) 属于拟合模型的概率),用最大似然拟合出的参数 \(\hat{\theta}\) 简单估算概率密度函数 \(\Pr(x^*\mid\hat{\theta})\) 即可。
2. Maximum a posteriori
在最大后验(MAP)拟合中,引入了参数 \(\theta\) 的先验信息。先前的经验也许会对可能的参数值提供一些信息。例如在一个时间序列中,\(t\) 时刻的参数值会告诉我们 \(t+1\) 时刻可能值的情况,而且这个信息可以从先验分布中得到。
\[ \begin{aligned} \hat{\boldsymbol{\theta}}&=\operatorname*{argmax}_{\boldsymbol{\theta}}\big[\Pr(\boldsymbol{\theta}\mid\boldsymbol{x}_{1\cdots I})\big] \\ &=\operatorname*{argmax}_{\boldsymbol{\theta}}\left[\frac{\Pr(\boldsymbol{x}_{1\cdots I}\mid\boldsymbol{\theta})\Pr(\boldsymbol{\theta})}{\Pr(\boldsymbol{x}_{1\cdots I})}\right] \\ &=\operatorname*{argmax}_{\boldsymbol{\theta}}\left[\frac{\prod_{i=1}^{I}\Pr(\boldsymbol{x}_{i}\mid\boldsymbol{\theta})\Pr(\boldsymbol{\theta})}{\Pr(\boldsymbol{x}_{1\cdots I})}\right] \end{aligned} \]
可以忽略对于参数而言是常数的分母,这样不会影响最大值的位置:
\[ \hat{\boldsymbol{\theta}}=\operatorname*{argmax}_{\boldsymbol{\theta}}\bigg[\prod_{i=1}^I\Pr(\boldsymbol{x}_i\mid\boldsymbol{\theta})\Pr(\boldsymbol{\theta})\bigg] \]
最大似然法是最大后验法在先验信息未知(先验为均匀分布)情况下的一个特例。
估算新数据点 \(x^*\) 的概率时,同样用拟合出的参数 \(\hat{\theta}\) 估算 \(\Pr(x^*\mid\hat{\theta})\)。
3. Bayesian approach
贝叶斯方法在统计学中提供了一种不同于传统频率学派的参数估计方式。在贝叶斯统计中,参数不被视为固定的未知常数(即点估计),而被视为随机变量,其自身也有概率分布。这种方法承认了一个重要的事实:在给定数据的情况下,可能存在多个与数据兼容的参数值。
Fitting
\[ \Pr(\boldsymbol{\theta}\mid\boldsymbol{x}_{1\cdots I})=\frac{\prod_{i=1}^{I}\Pr(\boldsymbol{x}_{i}\mid\boldsymbol{\theta})\Pr(\boldsymbol{\theta})}{\Pr(\boldsymbol{x}_{1\cdots I})} \]
Prediction
\[ \Pr(x^*\mid x_{1\cdots I})=\int \Pr(x^*\mid\theta)\Pr(\theta\mid x_{1\cdots I})\,\mathrm{d}\theta \]
The Normal Distribution
机器视觉中不确定性最常见的表示方式是多元正态分布:
\[ \Pr(\mathbf{x})=\frac{1}{(2\pi)^{D/2}|\boldsymbol{\Sigma}|^{1/2}}\exp\left[-\frac{1}{2}(\mathbf{x}-\boldsymbol{\mu})^{\mathrm{T}}\boldsymbol{\Sigma}^{-1}(\mathbf{x}-\boldsymbol{\mu})\right] \ \Rightarrow\ \Pr(\mathbf{x})=\mathrm{Norm}_\mathbf{x}[\boldsymbol{\mu},\boldsymbol{\Sigma}] \]
协方差矩阵
spherical(球形协方差)
\[ \boldsymbol{\Sigma}_{spher}=\begin{bmatrix}\sigma^2&0\\0&\sigma^2\end{bmatrix} \]
diagonal(对角协方差)
\[ \boldsymbol{\Sigma}_{diag}=\begin{bmatrix}\sigma_1^2&0\\0&\sigma_2^2\end{bmatrix} \]
full(全协方差)
\[ \boldsymbol{\Sigma}_{full}=\begin{bmatrix}\sigma_{11}^2&\sigma_{12}^2\\\sigma_{21}^2&\sigma_{22}^2\end{bmatrix} \]
协方差分解
\[ \mathbf{x}' = \boldsymbol{R}\mathbf{x} \quad\Rightarrow\quad \boldsymbol{\Sigma}_{full}=\boldsymbol{R}^{\mathrm{T}}\boldsymbol{\Sigma}_{diag}^{\prime}\boldsymbol{R} \]
全协方差矩阵可以表示为这种形式的乘积,包括一个旋转矩阵 \(\boldsymbol{R}\) 和一个对角协方差矩阵 \(\boldsymbol{\Sigma}'_{diag}\)。
变量的线性变换
\[ \mathbf{y} = \boldsymbol{A}\mathbf{x} + \mathbf{b}, \quad \Pr(\mathbf{x}) = \mathrm{Norm}_\mathbf{x}[\boldsymbol{\mu}, \boldsymbol{\Sigma}] \quad\Rightarrow\quad \Pr(\mathbf{y})=\mathrm{Norm}_\mathbf{y}\left[\boldsymbol{A}\boldsymbol{\mu}+\mathbf{b},\ \boldsymbol{A}\boldsymbol{\Sigma}\boldsymbol{A}^\mathrm{T}\right] \]
边缘分布
如果忽视多元正态分布中随机变量的任意子集,剩下的分布也是正态分布:
\[ \Pr(\mathbf{x})=\Pr\left(\begin{bmatrix}\mathbf{x}_1\\\mathbf{x}_2\end{bmatrix}\right) =\mathrm{Norm}_\mathbf{x}\left[\begin{bmatrix}\boldsymbol{\mu}_1\\\boldsymbol{\mu}_2\end{bmatrix},\ \begin{bmatrix}\boldsymbol{\Sigma}_{11}&\boldsymbol{\Sigma}_{12}\\\boldsymbol{\Sigma}_{21}&\boldsymbol{\Sigma}_{22}\end{bmatrix}\right] \]
\[ \Downarrow \]
\[ \Pr(\mathbf{x}_1)=\mathrm{Norm}_{\mathbf{x}_1}[\boldsymbol{\mu}_1,\boldsymbol{\Sigma}_{11}], \qquad \Pr(\mathbf{x}_2)=\mathrm{Norm}_{\mathbf{x}_2}[\boldsymbol{\mu}_2,\boldsymbol{\Sigma}_{22}] \]
其中 \(\boldsymbol{\Sigma}_{12}=\boldsymbol{\Sigma}_{21}^\mathrm{T}\)。
条件分布
如果变量 \(\mathbf{x}\) 服从多元正态分布,那么在其余变量 \(\mathbf{x}_2\) 值已知的情况下,关于变量子集 \(\mathbf{x}_1\) 的条件分布也是一个多元正态分布。
- 对任意一个多元正态分布,固定变量的一个子集,观察剩余变量的分布,这个分布也是正态形式。
- 这个新正态分布的均值取决于所固定的值,但协方差始终相同。
- 如果原始多元正态分布有球形或对角协方差,那么无论所固定的值是什么,最终正态分布的均值和方差都相同:协方差矩阵的这些形式意味着各组成变量之间是独立的。
正态分布的乘积
两个正态分布的乘积正比于第三个正态分布:
\[ \begin{aligned} &\mathrm{Norm}_\mathbf{x}[\mathbf{a},\boldsymbol{A}]\,\mathrm{Norm}_\mathbf{x}[\mathbf{b},\boldsymbol{B}]\\ &=\kappa\cdot\mathrm{Norm}_\mathbf{x}\left[(\boldsymbol{A}^{-1}+\boldsymbol{B}^{-1})^{-1}(\boldsymbol{A}^{-1}\mathbf{a}+\boldsymbol{B}^{-1}\mathbf{b}),\ (\boldsymbol{A}^{-1}+\boldsymbol{B}^{-1})^{-1}\right] \\ &\kappa=\mathrm{Norm}_\mathbf{a}[\mathbf{b},\boldsymbol{A}+\boldsymbol{B}]=\mathrm{Norm}_\mathbf{b}[\mathbf{a},\boldsymbol{A}+\boldsymbol{B}] \end{aligned} \]
自共轭性
上面的性质可以用来证明:正态分布关于其均值 \(\boldsymbol{\mu}\) 是自共轭的。
变量改变
考虑一个 \(\mathbf{x}\) 的正态分布,它的均值是第二个变量 \(\mathbf{y}\) 的线性函数 \(\boldsymbol{A}\mathbf{y}+\mathbf{b}\)。这同样可以用 \(\mathbf{y}\) 的正态分布来表示,其中 \(\mathbf{y}\) 是 \(\mathbf{x}\) 的线性函数 \(\boldsymbol{A}'\mathbf{x}+\mathbf{b}'\):
\[ \mathrm{Norm}_\mathbf{x}[\boldsymbol{A}\mathbf{y}+\mathbf{b},\boldsymbol{\Sigma}]=\kappa\cdot\mathrm{Norm}_\mathbf{y}[\boldsymbol{A}^{\prime}\mathbf{x}+\mathbf{b}^{\prime},\boldsymbol{\Sigma}^{\prime}] \]
这里的目标是把 \(\Pr(\mathbf{x}\mid\mathbf{y})\) 变为 \(\Pr(\mathbf{y}\mid\mathbf{x})\)。
Learning and Inference in Vision
在视觉问题中,我们把视觉数据看成 \(x\),并利用它们来推测全局状态 \(w\)。
为了解决视觉问题,需要三个要素:
Model
数学上关联视觉数据 \(x\) 和全局状态 \(w\)。模型指定了 \(x\) 与 \(w\) 之间一族可能的关系,而具体是哪一个关系由模型参数 \(\theta\) 决定。
Learning algorithm
允许我们用成对的训练样本 \(\{x_i, w_i\}\)(既知道测量值也知道其背后的状态)来拟合参数 \(\theta\)。
Inference algorithm
接收一个新的观测 \(x\),并用模型返回关于全局状态 \(w\) 的后验 \(\Pr(w\mid x, \theta)\)。也可以返回 MAP 解,或从后验中采样。
推理的目标是对新的观测量 \(x\) 求出关于可能全局状态 \(w\) 的一个分布 \(\Pr(w\mid x)\)。
模型的类型
- 建立在数据上的全局状态可能性模型 \(\Pr(w\mid x)\):Discriminative model
- 建立在全局状态上的数据可能性模型 \(\Pr(x\mid w)\):Generative model
对每种类别数据的密度进行建模,得到的称为类条件密度函数。
生成模型的例子:朴素贝叶斯分类器
生成模型试图建模数据是如何生成的,它们学习输入数据 \(x\)(例如邮件内容)和输出标签 \(y\)(例如是否为垃圾邮件)的联合概率分布 \(P(x, y)\)。通过这种方式,生成模型可以生成(即模拟)新的输入数据实例。
以垃圾邮件过滤器为例,一个朴素贝叶斯分类器会首先建模垃圾邮件和非垃圾邮件是如何产生的:
- 学习每个类别的概率 \(P(y)\),即邮件是垃圾邮件的概率和不是垃圾邮件的概率。
- 学习每个词汇在给定类别下的概率 \(P(x\mid y)\),例如在垃圾邮件中看到特定词汇(如「免费」「赢取」)的概率。
有了这些信息,朴素贝叶斯分类器就可以用贝叶斯规则计算给定邮件内容 \(x\) 时它属于垃圾邮件 \(y\) 的概率 \(P(y\mid x)\)。
判别模型的例子:逻辑回归
与生成模型不同,判别模型直接建模从输入 \(x\) 到输出 \(y\) 的映射或条件概率 \(P(y\mid x)\),而不尝试建模数据是如何生成的。它的主要目的是「判别」输入数据属于哪个类别。
对于同样的垃圾邮件过滤任务,逻辑回归模型直接学习输入特征(邮件内容)与目标标签之间的关系:
- 特征提取:把邮件内容转换为数值特征(例如词频、特定词汇的存在与否)。
- 模型训练:学习一个权重向量,把邮件的特征与其标签直接关联。
逻辑回归通过最小化损失函数(如交叉熵损失)来优化模型参数,从而准确判别新邮件是否为垃圾邮件。
区别总结
- 目标不同:生成模型(朴素贝叶斯)学习如何生成数据的整体分布;判别模型(逻辑回归)学习如何从输入区分输出。
- 应用范围:生成模型可以用于生成新的数据实例,也能用于分类;判别模型主要用于预测和分类。
- 性能差异:在数据量较少时生成模型可能更有优势,因为它们尝试建模数据的生成过程,可以更好地利用有限的信息;判别模型通常在大数据集上表现更好,尤其是当任务专注于预测而非生成时。
朴素贝叶斯法
- 朴素贝叶斯法对条件概率分布作了条件独立性假设。
- 朴素贝叶斯法实际上学习到生成数据的机制,所以属于生成模型。
- 将后验概率最大的类作为 \(x\) 的类输出:
\[ P(Y=c_k\mid X=x)=\frac{P(X=x\mid Y=c_k)P(Y=c_k)}{\sum_k P(X=x\mid Y=c_k)P(Y=c_k)} \]
\[ \Downarrow \]
\[ y=f(x)=\operatorname*{argmax}_{c_k}\frac{P(Y=c_k)\prod_j P(X^{(j)}=x^{(j)}\mid Y=c_k)}{\sum_k P(Y=c_k)\prod_j P(X^{(j)}=x^{(j)}\mid Y=c_k)} \]
\[ \Downarrow \]
\[ y=\operatorname*{argmax}_{c_k}P(Y=c_k)\prod_j P(X^{(j)}=x^{(j)}\mid Y=c_k) \]
朴素贝叶斯法将实例分到后验概率最大的类中,这等价于期望风险最小化。
Modeling Complex Densities
假设所有复杂的视觉数据都可以用正态分布来表示是不太现实的。本章介绍如何在基础概率密度函数之上,利用隐变量来构建复杂的分布。
我们用多元正态分布来描述数据:
\[ \Pr(\mathbf{x}\mid w)=\mathrm{Norm}_\mathbf{x}[\boldsymbol{\mu}_w,\boldsymbol{\Sigma}_w] \]
\[ \Downarrow \]
\[ \Pr(\mathbf{x}\mid w=0)=\mathrm{Norm}_\mathbf{x}[\boldsymbol{\mu}_0,\boldsymbol{\Sigma}_0], \qquad \Pr(\mathbf{x}\mid w=1)=\mathrm{Norm}_\mathbf{x}[\boldsymbol{\mu}_1,\boldsymbol{\Sigma}_1] \]
上面这两个叫做类条件密度函数。
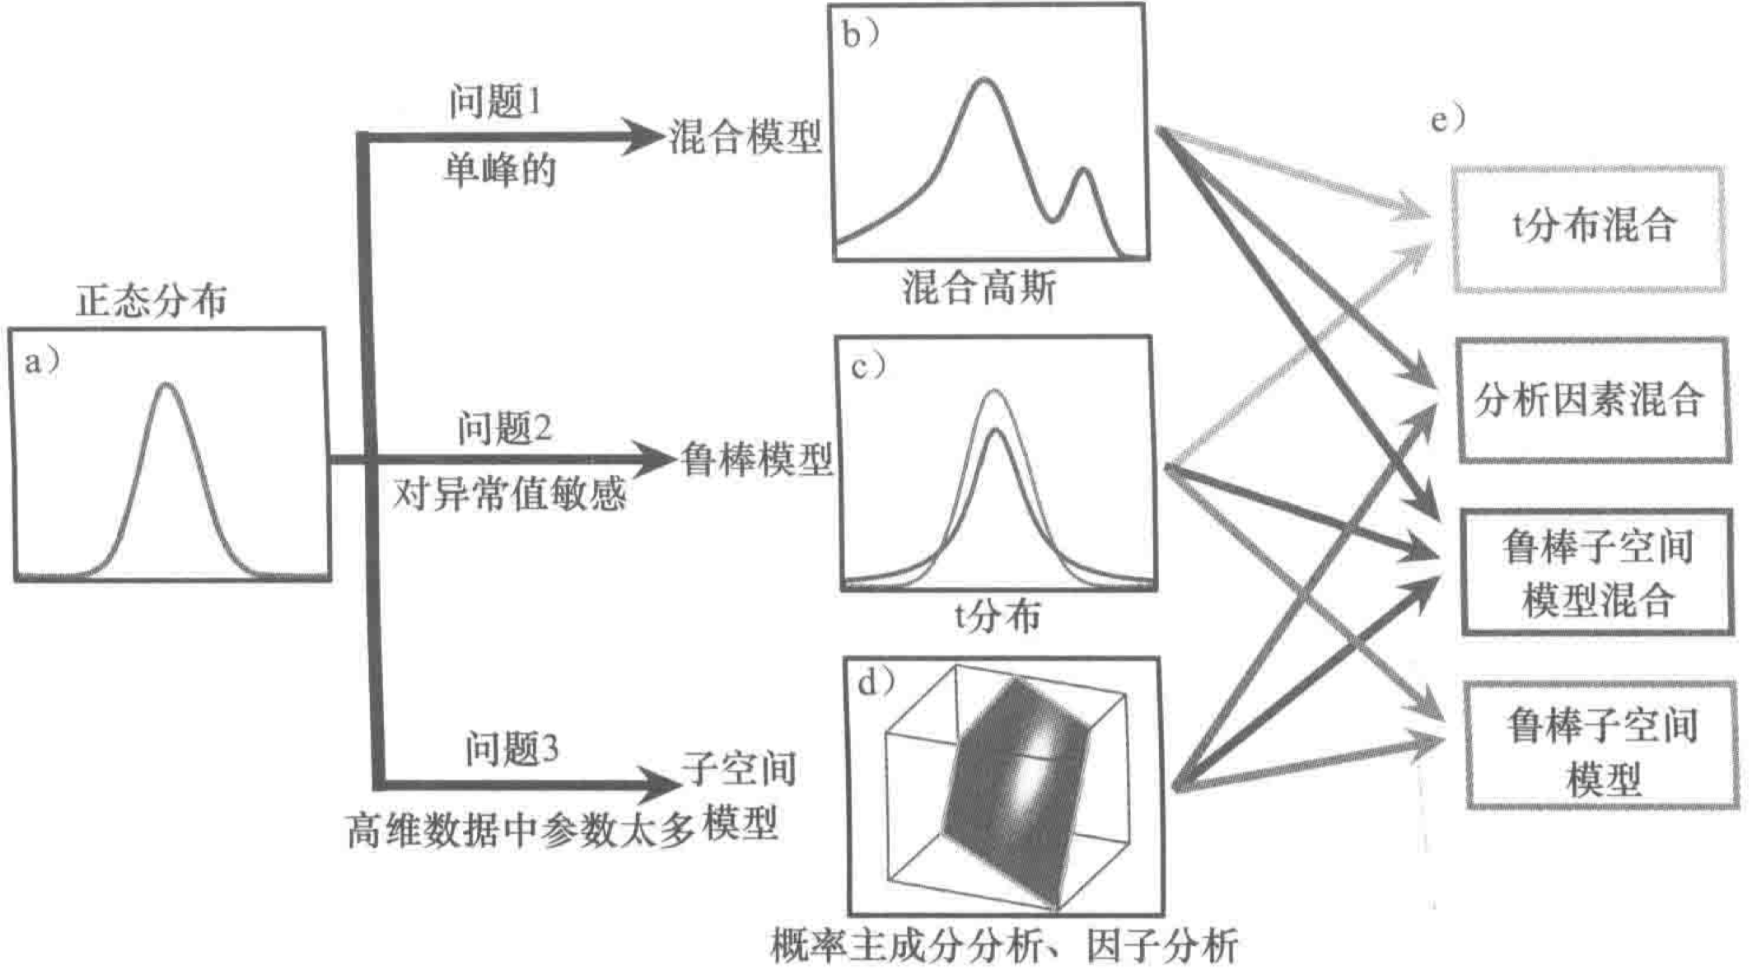
为了使密度函数多峰,我们引入混合模型;为了使密度函数鲁棒,我们把正态分布改为 t 分布;为了处理高维空间中的参数估计,我们引入子空间模型。
1. Hidden(or latent)Variables
\[ \Pr(x)=\int \Pr(x,h)\,\mathrm{d}h, \qquad \Pr(x\mid\theta)=\int \Pr(x,h\mid\theta)\,\mathrm{d}h \]
最大似然法
\[ \hat{\boldsymbol{\theta}}=\operatorname*{argmax}_{\boldsymbol{\theta}}\bigg[\sum_{i=1}^I\log\big[\Pr(\boldsymbol{x}_i\mid\boldsymbol{\theta})\big]\bigg] \]
最大期望算法(EM)
\[ \hat{\boldsymbol{\theta}}=\operatorname*{argmax}_{\boldsymbol{\theta}}\bigg[\sum_{i=1}^{I}\log\bigg[\int \Pr(\boldsymbol{x}_{i},\boldsymbol{h}_{i}\mid\boldsymbol{\theta})\,\mathrm{d}\boldsymbol{h}_{i}\bigg]\bigg] \]
2. 期望最大化算法(EM)
期望最大化算法通过对上式中的对数似然函数定义一个下界 \(\mathcal{B}[\{q_i(\boldsymbol{h}_i)\},\boldsymbol{\theta}]\),并迭代地增加这个下界。下界是 \(\theta\) 和其他量参数化后的函数。
下界:
\[ \begin{aligned} \mathcal{B}[\{q_i(\boldsymbol{h}_i)\},\boldsymbol{\theta}]&=\sum_{i=1}^I\int q_i(\boldsymbol{h}_i)\log\bigg[\frac{\Pr(\boldsymbol{x}_i,\boldsymbol{h}_i\mid\boldsymbol{\theta})}{q_i(\boldsymbol{h}_i)}\bigg]\,\mathrm{d}\boldsymbol{h}_i\\ &\leqslant\sum_{i=1}^I\log\left[\int \Pr(\boldsymbol{x}_i,\boldsymbol{h}_i\mid\boldsymbol{\theta})\,\mathrm{d}\boldsymbol{h}_i\right] \end{aligned} \]
期望最大化算法同时改变参数 \(\boldsymbol{\theta}\) 和分布 \(\{q_i(\boldsymbol{h}_i)\}_{i=1}^I\) 来提高下界:
- 更新概率分布 \(\{q_{i}(h_{i})\}_{i=1}^{I}\) 来增大下界,这叫做期望步或 E 步。
- 更新参数 \(\theta\) 来增大下界,这称为最大化步或 M 步。
E 步
在第 \(t+1\) 次迭代的 E 步,将每个分布 \(q_i(h_i)\) 设为在相关数据样本和当前参数 \(\theta^{[t]}\) 下隐变量的后验分布 \(\Pr(h_i\mid x_i,\theta^{[t]})\):
\[ \hat{q}_i(\boldsymbol{h}_i)=\Pr(\boldsymbol{h}_i\mid\boldsymbol{x}_i,\boldsymbol{\theta}^{[t]})=\frac{\Pr(\boldsymbol{x}_i\mid\boldsymbol{h}_i,\boldsymbol{\theta}^{[t]})\Pr(\boldsymbol{h}_i\mid\boldsymbol{\theta}^{[t]})}{\Pr(\boldsymbol{x}_i)} \]
M 步
在 M 步,直接关于参数 \(\theta\) 最大化下界。实际中可以化简下界的表达式,消去不依赖于 \(\theta\) 的项,得到
\[ \hat{\boldsymbol{\theta}}^{[t+1]}=\operatorname*{argmax}_{\boldsymbol{\theta}}\bigg[\sum_{i=1}^{I}\int\hat{q}_{i}(\boldsymbol{h}_{i})\log\big[\Pr(\boldsymbol{x}_{i},\boldsymbol{h}_{i}\mid\boldsymbol{\theta})\big]\,\mathrm{d}\boldsymbol{h}_{i}\bigg] \]
证明
使用詹森不等式:\(\int \Pr(y)\log[y]\,\mathrm{d}y\leqslant\log\left[\int y\,\Pr(y)\,\mathrm{d}y\right]\)
\[ \begin{aligned} \mathcal{B}\left[\{q_i(h_i)\},\theta\right]& =\sum_{i=1}^I\int q_i(\boldsymbol{h}_i)\log\bigg[\frac{\Pr(\boldsymbol{x}_i,\boldsymbol{h}_i\mid\boldsymbol{\theta})}{q_i(\boldsymbol{h}_i)}\bigg]\,\mathrm{d}\boldsymbol{h}_i \\ &\leqslant\sum_{i=1}^I\log\left[\int q_i(\boldsymbol{h}_i)\frac{\Pr(\boldsymbol{x}_i,\boldsymbol{h}_i\mid\boldsymbol{\theta})}{q_i(\boldsymbol{h}_i)}\,\mathrm{d}\boldsymbol{h}_i\right] \\ &=\sum_{i=1}^I\log\left[\int \Pr(\boldsymbol{x}_i,\boldsymbol{h}_i\mid\boldsymbol{\theta})\,\mathrm{d}\boldsymbol{h}_i\right] \end{aligned} \]
E 步的推导:
\[ \begin{aligned} \mathcal{B}\left[\{q_{i}(h_{i})\},\theta\right]& =\sum_{i=1}^{I}\int q_{i}(\boldsymbol{h}_{i})\log\bigg[\frac{\Pr(\boldsymbol{x}_{i},\boldsymbol{h}_{i}\mid\boldsymbol{\theta})}{q_{i}(\boldsymbol{h}_{i})}\bigg]\,\mathrm{d}\boldsymbol{h}_{i} \\ &=\sum_{i=1}^I\int q_i(\boldsymbol{h}_i)\log\bigg[\frac{\Pr(\boldsymbol{h}_i\mid\boldsymbol{x}_i,\boldsymbol{\theta})\Pr(\boldsymbol{x}_i\mid\boldsymbol{\theta})}{q_i(\boldsymbol{h}_i)}\bigg]\,\mathrm{d}\boldsymbol{h}_i \\ &=\sum_{i=1}^I\int q_i(h_i)\log\big[\Pr(\boldsymbol{x}_i\mid\boldsymbol{\theta})\big]\,\mathrm{d}\boldsymbol{h}_i-\sum_{i=1}^I\int q_i(h_i)\log\bigg[\frac{q_i(\boldsymbol{h}_i)}{\Pr(\boldsymbol{h}_i\mid\boldsymbol{x}_i,\boldsymbol{\theta})}\bigg]\,\mathrm{d}\boldsymbol{h}_i \\ &=\sum_{i=1}^{I}\log\big[\Pr(\boldsymbol{x}_{i}\mid\boldsymbol{\theta})\big]-\sum_{i=1}^{I}\int q_{i}(\boldsymbol{h}_{i})\log\left[\frac{q_{i}(\boldsymbol{h}_{i})}{\Pr(\boldsymbol{h}_{i}\mid\boldsymbol{x}_{i},\boldsymbol{\theta})}\right]\,\mathrm{d}\boldsymbol{h}_{i} \end{aligned} \]
\[ \Downarrow \]
\[ \begin{aligned} \hat{q}(h_{i})&= \operatorname*{argmax}_{q_{i}(\boldsymbol{h}_{i})}\bigg[-\int q_{i}(\boldsymbol{h}_{i})\log\bigg[\frac{q_{i}(\boldsymbol{h}_{i})}{\Pr(\boldsymbol{h}_{i}\mid\boldsymbol{x}_{i},\boldsymbol{\theta})}\bigg]\,\mathrm{d}\boldsymbol{h}_{i}\bigg] \\ &= \operatorname*{argmax}_{q_i(\boldsymbol{h}_i)}\bigg[\int q_i(\boldsymbol{h}_i)\log\bigg[\frac{\Pr(\boldsymbol{h}_i\mid\boldsymbol{x}_i,\boldsymbol{\theta})}{q_i(\boldsymbol{h}_i)}\bigg]\,\mathrm{d}\boldsymbol{h}_i\bigg] \\ &= \operatorname*{argmin}_{q_i(\boldsymbol{h}_i)}\bigg[-\int q_i(\boldsymbol{h}_i)\log\bigg[\frac{\Pr(\boldsymbol{h}_i\mid\boldsymbol{x}_i,\boldsymbol{\theta})}{q_i(\boldsymbol{h}_i)}\bigg]\,\mathrm{d}\boldsymbol{h}_i\bigg] \end{aligned} \]
\[ \Downarrow \]
\[ \begin{aligned} \int q_i(\boldsymbol{h}_i)\log\bigg[\frac{\Pr(\boldsymbol{h}_i\mid\boldsymbol{x}_i,\boldsymbol{\theta})}{q_i(\boldsymbol{h}_i)}\bigg]\,\mathrm{d}\boldsymbol{h}_i &\leqslant\int q_{i}(\boldsymbol{h}_{i})\left(\frac{\Pr(\boldsymbol{h}_{i}\mid\boldsymbol{x}_{i},\boldsymbol{\theta})}{q_{i}(\boldsymbol{h}_{i})}-1\right)\,\mathrm{d}\boldsymbol{h}_{i} \\ &=\int\big[\Pr(\boldsymbol{h}_i\mid\boldsymbol{x}_i,\boldsymbol{\theta})-q_i(\boldsymbol{h}_i)\big]\,\mathrm{d}\boldsymbol{h}_i \\ &=1-1=0 \end{aligned} \]
因此当 \(q_i(\boldsymbol{h}_i)=\Pr(\boldsymbol{h}_i\mid \boldsymbol{x}_i,\boldsymbol{\theta})\) 时取最大值。
M 步的推导:
\[ \begin{aligned} \theta^{[t+1]}& =\operatorname*{argmax}_{\theta}\big[\mathcal{B}[\{q_i^{[t]}(\boldsymbol{h}_i)\},\boldsymbol{\theta}]\big] \\ &=\operatorname*{argmax}_{\boldsymbol{\theta}}\bigg[\sum_{i=1}^{I}\int q_{i}^{[t]}(\boldsymbol{h}_{i})\log\bigg[\frac{\Pr(\boldsymbol{x}_{i},\boldsymbol{h}_{i}\mid\boldsymbol{\theta})}{q_{i}^{[t]}(\boldsymbol{h}_{i})}\bigg]\,\mathrm{d}\boldsymbol{h}_{i}\bigg] \\ &=\operatorname*{argmax}_{\theta}\bigg[\sum_{i=1}^{I}\int\Big( q_{i}^{[t]}(\boldsymbol{h}_{i})\log\big[\Pr(\boldsymbol{x}_{i},\boldsymbol{h}_{i}\mid\boldsymbol{\theta})\big]-q_{i}^{[t]}(\boldsymbol{h}_{i})\log\big[q_{i}^{[t]}(\boldsymbol{h}_{i})\big]\Big)\,\mathrm{d}\boldsymbol{h}_{i}\bigg] \\ &=\operatorname*{argmax}_{\boldsymbol{\theta}}\bigg[\sum_{i=1}^I\int q_i^{[t]}(\boldsymbol{h}_i)\log\big[\Pr(\boldsymbol{x}_i,\boldsymbol{h}_i\mid\boldsymbol{\theta})\big]\,\mathrm{d}\boldsymbol{h}_i\bigg] \end{aligned} \]
3. 混合高斯模型
\[ \Pr(\mathbf{x}\mid\boldsymbol{\theta})=\sum_{k=1}^K\lambda_k\,\mathrm{Norm}_\mathbf{x}[\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k] \]
\[ \begin{aligned} \hat{\boldsymbol{\theta}}&=\operatorname*{argmax}_{\boldsymbol{\theta}}\bigg[\sum_{i=1}^I\log\big[\Pr(\mathbf{x}_i\mid\boldsymbol{\theta})\big]\bigg]\\ &=\operatorname*{argmax}_{\boldsymbol{\theta}}\bigg[\sum_{i=1}^I\log\bigg[\sum_{k=1}^K\lambda_k\,\mathrm{Norm}_{\mathbf{x}_i}\big[\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k\big]\bigg]\bigg] \end{aligned} \]
混合高斯的边缘化
\[ \Pr(\mathbf{x}\mid h,\boldsymbol{\theta})=\mathrm{Norm}_\mathbf{x}[\boldsymbol{\mu}_h,\boldsymbol{\Sigma}_h], \qquad \Pr(h\mid\boldsymbol{\theta})=\mathrm{Cat}_h[\boldsymbol{\lambda}] \]
\[ \Downarrow \]
\[ \begin{aligned} \Pr(\mathbf{x}\mid\boldsymbol{\theta})& =\sum_{k=1}^K\Pr(\mathbf{x},h=k\mid\boldsymbol{\theta}) \\ &=\sum_{k=1}^K\Pr(\mathbf{x}\mid h=k,\boldsymbol{\theta})\Pr(h=k\mid\boldsymbol{\theta}) \\ &=\sum_{k=1}^K\lambda_k\,\mathrm{Norm}_\mathbf{x}[\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k] \end{aligned} \]
按照这种方式解释模型,也就给出了从混合高斯中采样的方法:为了从联合分布 \(\Pr(\mathbf{x},h)\) 中采样,首先从类别先验 \(\Pr(h)\) 中采样 \(h\),接着从与 \(h\) 值相关联的正态分布 \(\Pr(\mathbf{x}\mid h)\) 中采样 \(\mathbf{x}\)。
4. t 分布
使用正态分布描述视觉数据的第二个严重问题是不鲁棒:当移到分布尾部时,正态概率密度函数的下降非常快。
一元 t 分布的概率密度函数为
\[ \begin{aligned} \Pr(x)&=\mathrm{Stud}_x[\mu,\sigma^2,\nu]\\ &=\frac{\Gamma\left[\frac{\nu+1}{2}\right]}{\sqrt{\nu\pi\sigma^2}\,\Gamma\left[\frac{\nu}{2}\right]}\left(1+\frac{(x-\mu)^2}{\nu\sigma^2}\right)^{-\frac{\nu+1}{2}} \end{aligned} \]
多元 t 分布的概率密度函数为
\[ \begin{aligned} \Pr(\mathbf{x})&=\mathrm{Stud}_\mathbf{x}[\boldsymbol{\mu},\boldsymbol{\Sigma},\nu]\\ &=\frac{\Gamma\left[\frac{\nu+D}{2}\right]}{(\nu\pi)^{D/2}|\boldsymbol{\Sigma}|^{1/2}\Gamma\left[\frac{\nu}{2}\right]}\left(1+\frac{(\mathbf{x}-\boldsymbol{\mu})^{\mathrm{T}}\boldsymbol{\Sigma}^{-1}(\mathbf{x}-\boldsymbol{\mu})}{\nu}\right)^{-\frac{\nu+D}{2}} \end{aligned} \]
学生 t 分布的边缘化
和混合高斯模型一样,也可以用隐变量的方式来理解 t 分布:
\[ \Pr(\mathbf{x}\mid h)=\mathrm{Norm}_\mathbf{x}[\boldsymbol{\mu},\boldsymbol{\Sigma}/h], \qquad \Pr(h)=\mathrm{Gam}_h[\nu/2,\nu/2] \]
\[ \Downarrow \]
\[ \begin{aligned} \Pr(\mathbf{x})& =\int \Pr(\mathbf{x},h)\,\mathrm{d}h=\int \Pr(\mathbf{x}\mid h)\Pr(h)\,\mathrm{d}h \\ &=\int\mathrm{Norm}_\mathbf{x}[\boldsymbol{\mu},\boldsymbol{\Sigma}/h]\,\mathrm{Gam}_h[\nu/2,\nu/2]\,\mathrm{d}h \\ &=\mathrm{Stud}_\mathbf{x}[\boldsymbol{\mu},\boldsymbol{\Sigma},\nu] \end{aligned} \]
这个公式同时也提供了从 t 分布中生成数据的方法:先从 Gamma 分布采样 \(h\),再从对应的正态分布采样 \(\mathbf{x}\)。
用 EM 拟合 t 分布
隐变量是每个数据点的尺度 \(h_i\)。由于 Gamma 与正态的尺度参数共轭,\(h_i\) 的后验仍是 Gamma 分布:
\[ \Pr(h_i\mid \mathbf{x}_i,\boldsymbol{\theta}) = \mathrm{Gam}_{h_i}\left[\frac{\nu+D}{2},\ \frac{\nu + (\mathbf{x}_i-\boldsymbol{\mu})^\mathrm{T}\boldsymbol{\Sigma}^{-1}(\mathbf{x}_i-\boldsymbol{\mu})}{2}\right] \]
E 步:由 Gamma 分布的性质,直接写出 M 步需要的两个期望
\[ \mathbb{E}[h_i]=\frac{\nu+D}{\nu+(\mathbf{x}_i-\boldsymbol{\mu})^\mathrm{T}\boldsymbol{\Sigma}^{-1}(\mathbf{x}_i-\boldsymbol{\mu})} \]
\[ \mathbb{E}[\log h_i]=\Psi\!\left(\frac{\nu+D}{2}\right)-\log\left(\frac{\nu+(\mathbf{x}_i-\boldsymbol{\mu})^\mathrm{T}\boldsymbol{\Sigma}^{-1}(\mathbf{x}_i-\boldsymbol{\mu})}{2}\right) \]
其中 \(\Psi(\cdot)\) 是 digamma 函数。
这里可以看出 t 分布鲁棒性的来源:离群点的马氏距离大,于是 \(\mathbb{E}[h_i]\) 小,在下一步里被自动降权。
M 步:对 \(\boldsymbol{\mu},\boldsymbol{\Sigma}\) 是加权版本的闭式解
\[ \hat{\boldsymbol{\mu}}=\frac{\sum_{i=1}^I \mathbb{E}[h_i]\,\mathbf{x}_i}{\sum_{i=1}^I \mathbb{E}[h_i]}, \qquad \hat{\boldsymbol{\Sigma}}=\frac{1}{I}\sum_{i=1}^I \mathbb{E}[h_i]\,(\mathbf{x}_i-\hat{\boldsymbol{\mu}})(\mathbf{x}_i-\hat{\boldsymbol{\mu}})^\mathrm{T} \]
自由度 \(\nu\) 没有闭式解,需要一维数值搜索(如牛顿法)来最大化
\[ \sum_{i=1}^I\left[\frac{\nu}{2}\log\frac{\nu}{2}-\log\Gamma\!\left(\frac{\nu}{2}\right)+\frac{\nu}{2}\big(\mathbb{E}[\log h_i]-\mathbb{E}[h_i]\big)\right] \]
5. 因子分析
因子分析的概率密度函数为
\[ \Pr(\mathbf{x})=\mathrm{Norm}_\mathbf{x}\left[\boldsymbol{\mu},\ \boldsymbol{\Phi}\boldsymbol{\Phi}^\mathrm{T}+\boldsymbol{\Sigma}\right] \]
第一项 \(\boldsymbol{\Phi}\boldsymbol{\Phi}^\mathrm{T}\) 描述子空间上的全协方差模型:\(\boldsymbol{\Phi}= [\boldsymbol{\phi}_1,\boldsymbol{\phi}_2, \ldots, \boldsymbol{\phi}_K]\) 是一个 \(D\times K\) 的长方形矩阵,其各列称为因子。\(\boldsymbol{\Sigma}\) 通常取对角,代表各维独立的噪声。
因子分析的边缘分布
引入 \(K\) 维隐变量 \(\mathbf{h}\)(\(K \ll D\)),模型写成
\[ \Pr(\mathbf{h})=\mathrm{Norm}_\mathbf{h}[\mathbf{0},\boldsymbol{I}], \qquad \Pr(\mathbf{x}\mid\mathbf{h})=\mathrm{Norm}_\mathbf{x}\left[\boldsymbol{\mu}+\boldsymbol{\Phi}\mathbf{h},\ \boldsymbol{\Sigma}\right] \]
也就是说,数据被建模为「均值 + 若干因子的线性组合 + 各维独立噪声」。把 \(\mathbf{h}\) 边缘化掉:
\[ \begin{aligned} \Pr(\mathbf{x})&=\int \mathrm{Norm}_\mathbf{x}\left[\boldsymbol{\mu}+\boldsymbol{\Phi}\mathbf{h},\boldsymbol{\Sigma}\right]\mathrm{Norm}_\mathbf{h}[\mathbf{0},\boldsymbol{I}]\,\mathrm{d}\mathbf{h}\\ &=\mathrm{Norm}_\mathbf{x}\left[\boldsymbol{\mu},\ \boldsymbol{\Phi}\boldsymbol{\Phi}^\mathrm{T}+\boldsymbol{\Sigma}\right] \end{aligned} \]
用的是线性变换后正态分布仍为正态的性质:均值 \(\boldsymbol{\mu}+\boldsymbol{\Phi}\cdot\mathbf{0}=\boldsymbol{\mu}\),协方差 \(\boldsymbol{\Phi}\boldsymbol{I}\boldsymbol{\Phi}^\mathrm{T}+\boldsymbol{\Sigma}\)。
这样做的好处是参数量:全协方差需要 \(D(D+1)/2\) 个参数,而因子分析只需要 \(DK + D\) 个。当 \(D\) 很大(如图像)时差别巨大。
因子分析的期望最大化
E 步:隐变量的后验是正态分布(正态先验 × 正态似然)
\[ \Pr(\mathbf{h}_i\mid\mathbf{x}_i)=\mathrm{Norm}_{\mathbf{h}_i}\left[\big(\boldsymbol{\Phi}^\mathrm{T}\boldsymbol{\Sigma}^{-1}\boldsymbol{\Phi}+\boldsymbol{I}\big)^{-1}\boldsymbol{\Phi}^\mathrm{T}\boldsymbol{\Sigma}^{-1}(\mathbf{x}_i-\boldsymbol{\mu}),\ \big(\boldsymbol{\Phi}^\mathrm{T}\boldsymbol{\Sigma}^{-1}\boldsymbol{\Phi}+\boldsymbol{I}\big)^{-1}\right] \]
从中取出 M 步所需的一阶、二阶矩:
\[ \mathbb{E}[\mathbf{h}_i], \qquad \mathbb{E}[\mathbf{h}_i\mathbf{h}_i^\mathrm{T}]=\operatorname{Cov}[\mathbf{h}_i]+\mathbb{E}[\mathbf{h}_i]\mathbb{E}[\mathbf{h}_i]^\mathrm{T} \]
注意这里必须用二阶矩,而不能只用 \(\mathbb{E}[\mathbf{h}_i]\) 的外积——否则就退化成了 PCA 式的硬指派,丢掉了隐变量的不确定性。
M 步:
\[ \hat{\boldsymbol{\Phi}}=\left[\sum_{i=1}^I(\mathbf{x}_i-\boldsymbol{\mu})\,\mathbb{E}[\mathbf{h}_i]^\mathrm{T}\right]\left[\sum_{i=1}^I\mathbb{E}[\mathbf{h}_i\mathbf{h}_i^\mathrm{T}]\right]^{-1} \]
\[ \hat{\boldsymbol{\Sigma}}=\frac{1}{I}\operatorname{diag}\left[\sum_{i=1}^I\Big((\mathbf{x}_i-\boldsymbol{\mu})(\mathbf{x}_i-\boldsymbol{\mu})^\mathrm{T}-\hat{\boldsymbol{\Phi}}\,\mathbb{E}[\mathbf{h}_i](\mathbf{x}_i-\boldsymbol{\mu})^\mathrm{T}\Big)\right] \]
其中 \(\operatorname{diag}[\cdot]\) 只保留对角元素(因为假设噪声各维独立)。\(\boldsymbol{\mu}\) 可以直接取数据均值,与迭代无关。
注意:\(\boldsymbol{\Phi}\) 只能确定到一个旋转——对任意正交矩阵 \(\boldsymbol{R}\),\(\boldsymbol{\Phi}\boldsymbol{R}\) 给出同样的 \(\boldsymbol{\Phi}\boldsymbol{\Phi}^\mathrm{T}\)。所以因子本身不唯一,只有它们张成的子空间是唯一的。
6. 混合模型总结
- 混合高斯模型包含 \(K\) 个具有不同均值和方差的正态分布的加权和。
- t 分布包含具有相同均值但不同方差的正态分布的无限加权和(见上面的边缘化推导)。
- 把混合模型和因子分析组合,得到混合因子分析(MoFA)模型。
- 组合混合模型和 t 分布:混合 t 分布,或鲁棒混合模型
- 组合 t 分布和因子分析:鲁棒子空间模型
- 组合所有三个模型:混合鲁棒子空间模型
Regression Models
回归问题的目的是根据观测值 \(x\) 来估计一元全局状态 \(w\)。
1. 线性回归
线性回归的目标是根据观测的数据 \(x\) 预测关于全局状态 \(w\) 的后验分布 \(\Pr(w\mid x)\):
\[ \Pr(w_i\mid x_i,\theta)=\mathrm{Norm}_{w_i}\left[\phi_0+\boldsymbol{\phi}^\mathrm{T}\mathbf{x}_i,\ \sigma^2\right] \]
把常数项吸收进 \(\boldsymbol{\phi}\)(对应地在 \(\mathbf{x}_i\) 前面补一个 1),等价于
\[ \Pr(w_i\mid x_i,\theta)=\mathrm{Norm}_{w_i}\left[\boldsymbol{\phi}^\mathrm{T}\mathbf{x}_i,\ \sigma^2\right] \]
对 i.i.d. 样本:
\[ \Pr(\mathbf{w}\mid\boldsymbol{X})=\mathrm{Norm}_\mathbf{w}\left[\boldsymbol{X}^\mathrm{T}\boldsymbol{\phi},\ \sigma^2\boldsymbol{I}\right] \]
学习
\[ \begin{aligned} \hat{\boldsymbol{\theta}}&=\operatorname*{argmax}_{\boldsymbol{\theta}}\big[\Pr(\mathbf{w}\mid \boldsymbol{X},\boldsymbol{\theta})\big]\\ &=\operatorname*{argmax}_{\boldsymbol{\theta}}\big[\log[\Pr(\mathbf{w}\mid \boldsymbol{X},\boldsymbol{\theta})]\big] \end{aligned} \]
取对数后:
\[ \hat{\boldsymbol{\phi}},\hat{\sigma}^2=\operatorname*{argmax}_{\boldsymbol{\phi},\sigma^2}\left[-\frac{I\log[2\pi]}{2}-\frac{I\log[\sigma^2]}{2}-\frac{(\mathbf{w}-\boldsymbol{X}^\mathrm{T}\boldsymbol{\phi})^\mathrm{T}(\mathbf{w}-\boldsymbol{X}^\mathrm{T}\boldsymbol{\phi})}{2\sigma^2}\right] \]
\[ \Downarrow \]
\[ \hat{\boldsymbol{\phi}}=(\boldsymbol{X}\boldsymbol{X}^\mathrm{T})^{-1}\boldsymbol{X}\mathbf{w}, \qquad \hat{\sigma}^2=\frac{(\mathbf{w}-\boldsymbol{X}^\mathrm{T}\hat{\boldsymbol{\phi}})^\mathrm{T}(\mathbf{w}-\boldsymbol{X}^\mathrm{T}\hat{\boldsymbol{\phi}})}{I} \]
推理:求 \(\Pr(w^{*}\mid x^{*})\)。
三个问题
- 模型的预测过于自信
- 局限于线性函数,通常并没有特殊原因使得视觉数据和全局状态是线性关系
- 当观测数据 \(x\) 是高维数据时,该变量的许多元素可能对预测全局状态没有作用,因此得到的模型过于复杂
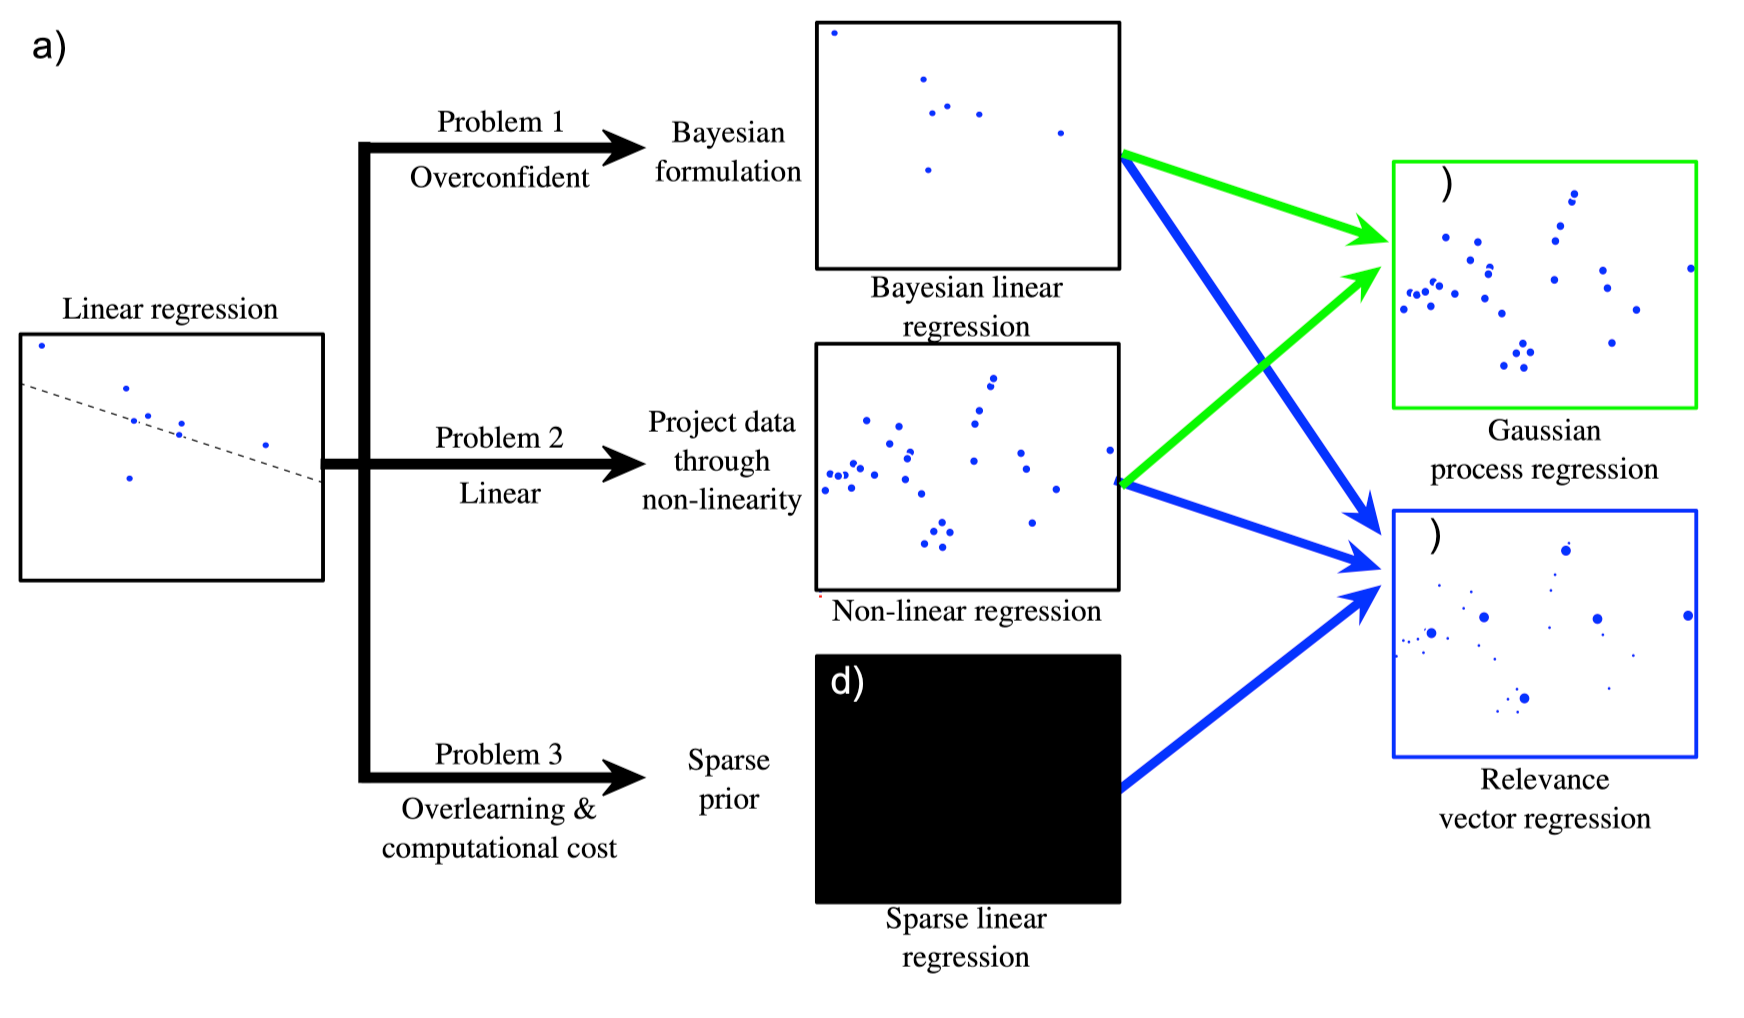
2. 贝叶斯线性回归
此处假设 \(\sigma^2\) 已知,所以待估参数 \(\theta\) 就只有 \(\boldsymbol{\phi}\)。
先验:
\[ \Pr(\boldsymbol{\phi})=\mathrm{Norm}_{\boldsymbol{\phi}}\left[\mathbf{0},\ \sigma_p^2\boldsymbol{I}\right] \]
根据贝叶斯法则:
\[ \Pr(\boldsymbol{\phi}\mid\boldsymbol{X},\mathbf{w})=\frac{\Pr(\mathbf{w}\mid\boldsymbol{X},\boldsymbol{\phi})\Pr(\boldsymbol{\phi})}{\Pr(\mathbf{w}\mid\boldsymbol{X})} \]
其中
\[ \Pr(\mathbf{w}\mid\boldsymbol{X},\boldsymbol{\theta})=\mathrm{Norm}_\mathbf{w}\left[\boldsymbol{X}^\mathrm{T}\boldsymbol{\phi},\ \sigma^2\boldsymbol{I}\right] \]
可得
\[ \Pr(\boldsymbol{\phi}\mid\boldsymbol{X},\mathbf{w})=\mathrm{Norm}_{\boldsymbol{\phi}}\left[\frac{1}{\sigma^2}\boldsymbol{A}^{-1}\boldsymbol{X}\mathbf{w},\ \boldsymbol{A}^{-1}\right] \]
其中
\[ \begin{aligned} \boldsymbol{A}^{-1}& =\left(\frac{1}{\sigma^2}\boldsymbol{X}\boldsymbol{X}^\mathrm{T}+\frac{1}{\sigma_p^2}\boldsymbol{I}_D\right)^{-1} \\ &=\sigma_p^2\boldsymbol{I}_D-\sigma_p^2\boldsymbol{X}\left(\boldsymbol{X}^\mathrm{T}\boldsymbol{X}+\frac{\sigma^2}{\sigma_p^2}\boldsymbol{I}_I\right)^{-1}\boldsymbol{X}^\mathrm{T} \end{aligned} \]
推理:
\[ \begin{aligned} \Pr(w^{*}\mid x^{*},\boldsymbol{X},\mathbf{w})& =\int \Pr(w^*\mid x^*,\boldsymbol{\phi})\Pr(\boldsymbol{\phi}\mid\boldsymbol{X},\mathbf{w})\,\mathrm{d}\boldsymbol{\phi} \\ &=\int\mathrm{Norm}_{w^*}\left[\boldsymbol{\phi}^\mathrm{T}x^*,\sigma^2\right]\mathrm{Norm}_{\boldsymbol{\phi}}\left[\frac{1}{\sigma^2}\boldsymbol{A}^{-1}\boldsymbol{X}\mathbf{w},\boldsymbol{A}^{-1}\right]\,\mathrm{d}\boldsymbol{\phi} \\ &=\mathrm{Norm}_{w^*}\left[\frac{1}{\sigma^2}x^{*\mathrm{T}}\boldsymbol{A}^{-1}\boldsymbol{X}\mathbf{w},\ x^{*\mathrm{T}}\boldsymbol{A}^{-1}x^{*}+\sigma^2\right] \end{aligned} \]
对比之前最大似然的推理,这个结果更准确——它把参数的不确定性也传播到了预测中。
3. Non-Linear Regression
首先把每个数据样本通过一个非线性变换,创建一个通常比原始数据更高维的新数据向量 \(\mathbf{z}_i\):
\[ \mathbf{z}_i=f[\mathbf{x}_i] \]
然后
\[ \Pr(w_i\mid x_i)=\mathrm{Norm}_{w_i}\left[\boldsymbol{\phi}^\mathrm{T}\mathbf{z}_i,\ \sigma^2\right] \]
例如
\[ \Pr(w_i\mid x_i)=\mathrm{Norm}_{w_i}\left[\phi_0+\phi_1x_i+\phi_2x_i^2+\phi_3x_i^3,\ \sigma^2\right] \]
其中
\[ \mathbf{z}_i=\begin{bmatrix}1\\x_i\\x_i^2\\x_i^3\end{bmatrix} \]
最大似然法
\[ \Pr(\mathbf{w}\mid\boldsymbol{X})=\mathrm{Norm}_\mathbf{w}\left[\boldsymbol{Z}^\mathrm{T}\boldsymbol{\phi},\ \sigma^2\boldsymbol{I}\right] \]
\[ \Downarrow \]
\[ \hat{\boldsymbol{\phi}}=(\boldsymbol{Z}\boldsymbol{Z}^\mathrm{T})^{-1}\boldsymbol{Z}\mathbf{w}, \qquad \hat{\sigma}^2=\frac{(\mathbf{w}-\boldsymbol{Z}^\mathrm{T}\hat{\boldsymbol{\phi}})^\mathrm{T}(\mathbf{w}-\boldsymbol{Z}^\mathrm{T}\hat{\boldsymbol{\phi}})}{I} \]
除了上面的多项式 \(\mathbf{z}_i\),还有:
Radial Basis function
\[ \mathbf{z}_i=\begin{bmatrix} 1\\ \exp\left[-(x_i-\alpha_1)^2/\lambda\right]\\ \exp\left[-(x_i-\alpha_2)^2/\lambda\right]\\ \exp\left[-(x_i-\alpha_3)^2/\lambda\right]\\ \exp\left[-(x_i-\alpha_4)^2/\lambda\right]\\ \exp\left[-(x_i-\alpha_5)^2/\lambda\right]\\ \exp\left[-(x_i-\alpha_6)^2/\lambda\right] \end{bmatrix} \]
Arc Tan function
\[ \mathbf{z}_i=\begin{bmatrix} \arctan[\lambda x_i-\alpha_1]\\ \arctan[\lambda x_i-\alpha_2]\\ \arctan[\lambda x_i-\alpha_3]\\ \arctan[\lambda x_i-\alpha_4]\\ \arctan[\lambda x_i-\alpha_5]\\ \arctan[\lambda x_i-\alpha_6]\\ \arctan[\lambda x_i-\alpha_7] \end{bmatrix} \]
贝叶斯非线性回归
\[ \begin{aligned} &\Pr(w^* \mid \mathbf{z}^*, \boldsymbol{X}, \mathbf{w}) \\ &= \mathrm{Norm}_{w^*} \left[\frac{\sigma_p^2}{\sigma^2} \mathbf{z}^{*\mathrm{T}} \boldsymbol{Z} \mathbf{w} - \frac{\sigma_p^4}{\sigma^2}\, \mathbf{z}^{*\mathrm{T}} \boldsymbol{Z} \left(\boldsymbol{Z}^\mathrm{T} \boldsymbol{Z} + \frac{\sigma^2}{\sigma_p^2} \boldsymbol{I}\right)^{-1} \boldsymbol{Z}^\mathrm{T} \boldsymbol{Z} \mathbf{w}, \right.\\ &\qquad\quad \left. \sigma_p^2 \mathbf{z}^{*\mathrm{T}} \mathbf{z}^* - \sigma_p^4\, \mathbf{z}^{*\mathrm{T}} \boldsymbol{Z} \left(\boldsymbol{Z}^\mathrm{T} \boldsymbol{Z} + \frac{\sigma^2}{\sigma_p^2} \boldsymbol{I}\right)^{-1} \boldsymbol{Z}^\mathrm{T} \mathbf{z}^* + \sigma^2 \right] \end{aligned} \]
4. Kernels and Kernel Trick
前面几节介绍的处理非线性回归的贝叶斯方法很少在实际中应用:预测分布的最终表达式与计算内积项 \(\mathbf{z}_i^\mathrm{T}\mathbf{z}_j\) 有关。然而当变换后的空间是高维空间时,显式计算向量 \(\mathbf{z}_i=f[\mathbf{x}_i]\) 和 \(\mathbf{z}_j=f[\mathbf{x}_j]\) 再算内积,成本可能太大。
另一种方法是用核替换:直接定义一个核函数 \(k[\mathbf{x}_i,\mathbf{x}_j]\) 来替换 \(f[\mathbf{x}_i]^\mathrm{T}f[\mathbf{x}_j]\)。
这样做的好处是可以定义核函数把数据投影到高维甚至无限维空间中,这种方法称为核技巧。
有效核函数:
线性核
\[ k[\mathbf{x}_i,\mathbf{x}_j]=\mathbf{x}_i^\mathrm{T}\mathbf{x}_j \]
\(p\) 阶多项式
\[ k[\mathbf{x}_i,\mathbf{x}_j]=(\mathbf{x}_i^\mathrm{T}\mathbf{x}_j+1)^p \]
径向基(RBF)或高斯
\[ k[\mathbf{x}_i,\mathbf{x}_j]=\exp\left[-\frac{1}{2}\left(\frac{(\mathbf{x}_i-\mathbf{x}_j)^\mathrm{T}(\mathbf{x}_i-\mathbf{x}_j)}{\lambda^2}\right)\right] \]
5. Gaussian Process Regression
把非线性回归算法中的内积 \(\mathbf{z}_i^\mathrm{T}\mathbf{z}_j\) 替换为核函数,得到的模型称为高斯过程回归。对于新数据 \(x^*\) 的预测分布为
\[ \begin{aligned} &\Pr(w^* \mid x^*, \boldsymbol{X}, \mathbf{w}) = \mathrm{Norm}_{w^*} \left[ \frac{\sigma_p^2}{\sigma^2} K[x^*, \boldsymbol{X}] \mathbf{w} - \frac{\sigma_p^4}{\sigma^2} K[x^*, \boldsymbol{X}] \left(K[\boldsymbol{X}, \boldsymbol{X}] + \frac{\sigma^2}{\sigma_p^2} \boldsymbol{I}\right)^{-1} K[\boldsymbol{X}, \boldsymbol{X}] \mathbf{w}, \right. \\ &\qquad\qquad \left. \sigma_p^2 K[x^*, x^*] - \sigma_p^4 K[x^*, \boldsymbol{X}] \left(K[\boldsymbol{X}, \boldsymbol{X}] + \frac{\sigma^2}{\sigma_p^2} \boldsymbol{I}\right)^{-1} K[\boldsymbol{X}, x^*] + \sigma^2 \right] \end{aligned} \]
6. Sparse Linear Regression
现在把注意力转到线性回归的第三个缺点。经常会出现这种情况:\(x\) 的维度中只有一小部分对预测 \(w\) 有用。
稀疏线性回归的目标是改造算法,求出一个大多数项为 0 的权重向量:
\[ \begin{aligned} \Pr(\boldsymbol{\phi})&=\prod_{d=1}^D\mathrm{Stud}_{\phi_d}[0,1,\nu]\\ &=\prod_{d=1}^D\frac{\Gamma\left(\frac{\nu+1}{2}\right)}{\sqrt{\nu\pi}\,\Gamma\left(\frac{\nu}{2}\right)}\left(1+\frac{\phi_d^2}{\nu}\right)^{-(\nu+1)/2} \end{aligned} \]
利用贝叶斯方法,目标是用这个新先验求权重向量取值的后验分布 \(\Pr(\boldsymbol{\phi}\mid \boldsymbol{X}, \mathbf{w},\sigma^2)\):
\[ \Pr(\boldsymbol{\phi}\mid\boldsymbol{X},\mathbf{w},\sigma^2)=\frac{\Pr(\mathbf{w}\mid\boldsymbol{X},\boldsymbol{\phi},\sigma^2)\Pr(\boldsymbol{\phi})}{\Pr(\mathbf{w}\mid\boldsymbol{X},\sigma^2)} \]
7. 相关向量回归
把先验加在数据点权重 \(\boldsymbol{\psi}\) 上(而不是维度权重上):
\[ \Pr(\boldsymbol{\psi})=\prod_{i=1}^I\mathrm{Stud}_{\psi_i}[0,1,\nu] \]
该模型称为相关向量回归(relevance vector regression)。
Classification Models
具体目标是:根据给定向量 \(\mathbf{x}\) 的连续观测数据,对离散全局状态 \(w \in \{1, \ldots, K\}\) 的后验概率分布 \(\Pr(w\mid \mathbf{x})\) 直接建立模型。
1. 逻辑回归
\[ \Pr(w\mid\phi_0,\boldsymbol{\phi},\mathbf{x})=\mathrm{Bern}_w\big[\operatorname{sig}[a]\big] \]
其中
\[ a=\phi_0+\boldsymbol{\phi}^\mathrm{T}\mathbf{x}, \qquad \operatorname{sig}[a]=\frac{1}{1+\exp[-a]} \]
学习
\[ \begin{aligned} \Pr(\mathbf{w}\mid\boldsymbol{X},\boldsymbol{\phi})& =\prod_{i=1}^I\lambda^{w_i}(1-\lambda)^{1-w_i} \\ &=\prod_{i=1}^{I}\left(\frac{1}{1+\exp[-\boldsymbol{\phi}^\mathrm{T}\mathbf{x}_i]}\right)^{w_i}\left(\frac{\exp[-\boldsymbol{\phi}^\mathrm{T}\mathbf{x}_i]}{1+\exp[-\boldsymbol{\phi}^\mathrm{T}\mathbf{x}_i]}\right)^{1-w_i} \end{aligned} \]
三个问题
- 按照最大似然估计过于自信
- 只能描述线性决策边界
- 效率低,且对高维数据容易过拟合
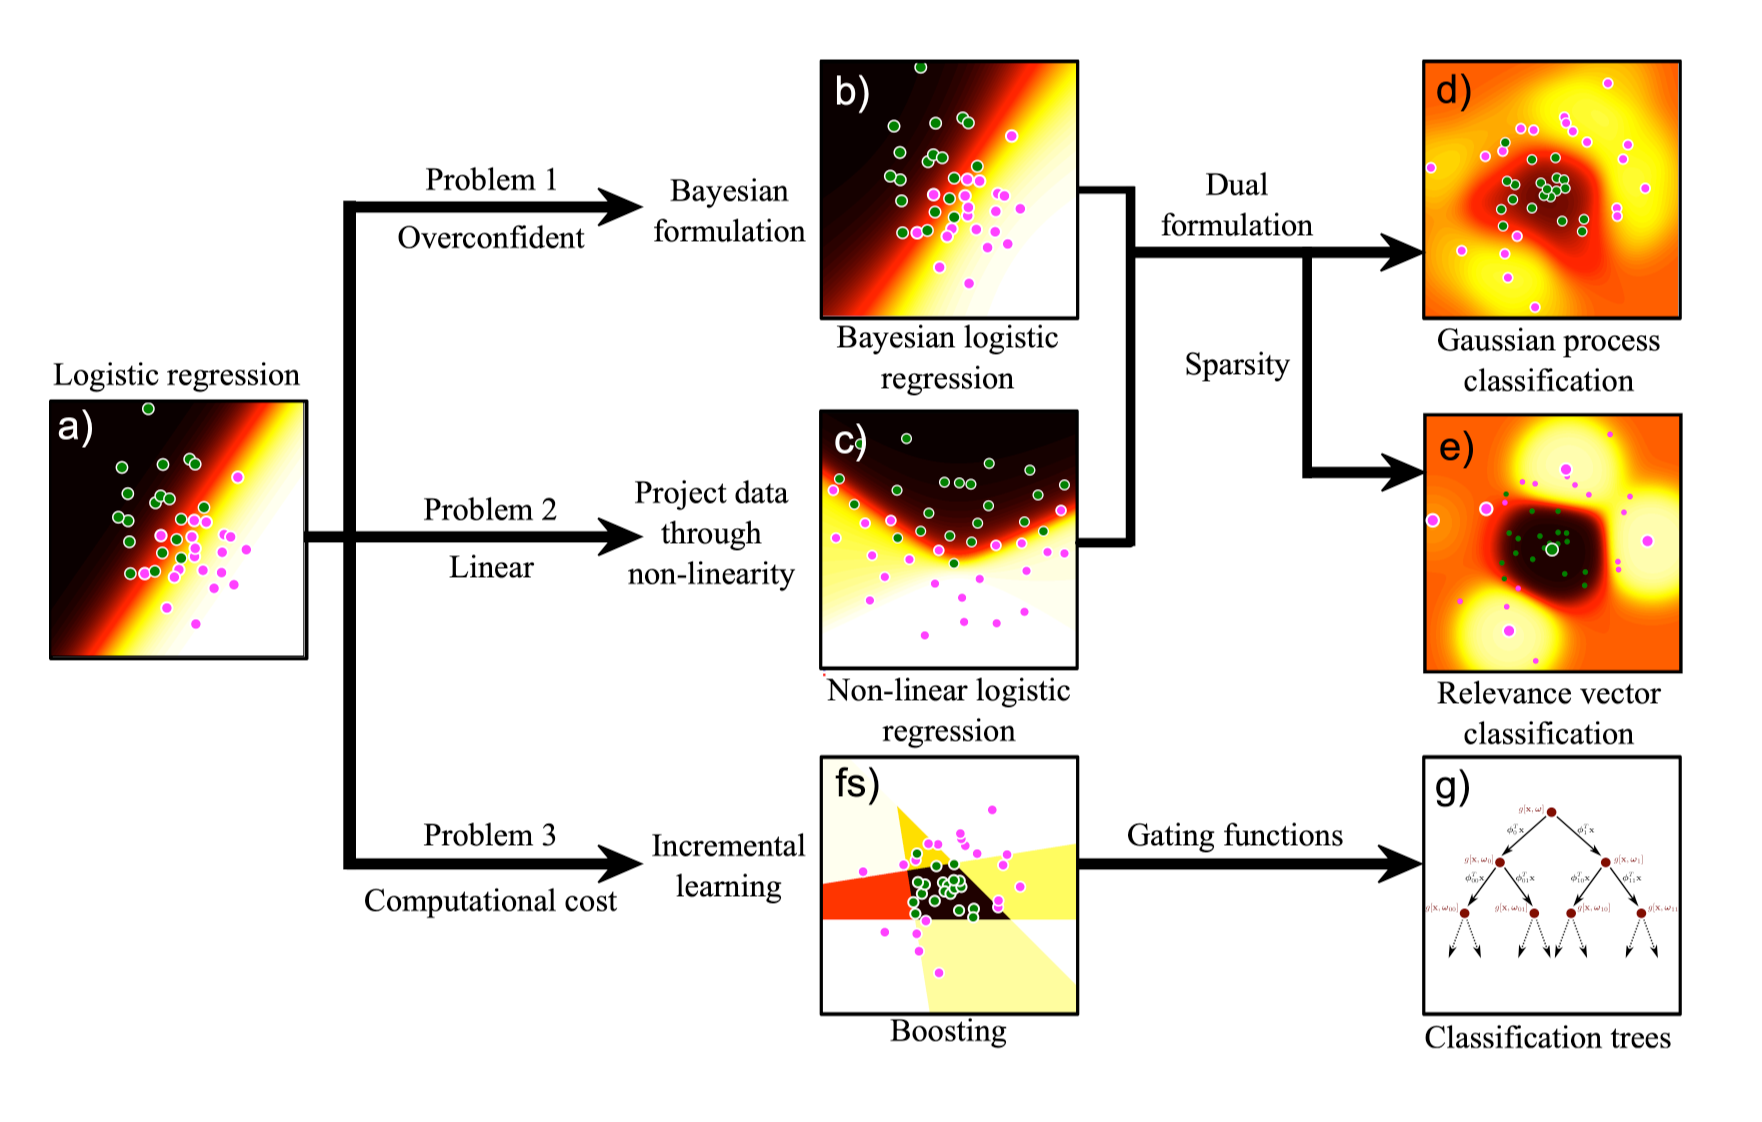
2. Bayesian Logistic Regression
在标准逻辑回归中,通常不把权重 \(\boldsymbol{\phi}\) 和偏置 \(\phi_0\) 的先验分布纳入训练过程。换句话说,逻辑回归通常以频率学派的观点实现:参数通过最大化似然函数(或等价地最小化交叉熵损失)来估计,而不是通过贝叶斯推断考虑参数的先验分布。
在贝叶斯逻辑回归中,可以引入参数的先验分布。不引入先验使模型更简单,但在某些情况下会限制其表达能力,特别是数据较少或参数正则化尤为重要的情况下。
我们要学习的是与训练数据兼容的参数值上的分布 \(\Pr(\boldsymbol{\phi}\mid\boldsymbol{X},\mathbf{w})\)。
学习
先验:\(\Pr(\boldsymbol{\phi})=\mathrm{Norm}_{\boldsymbol{\phi}}[\mathbf{0},\sigma_p^2\boldsymbol{I}]\)
为了计算参数 \(\boldsymbol{\phi}\) 的后验概率分布:
\[ \Pr(\boldsymbol{\phi}\mid\boldsymbol{X},\mathbf{w})=\frac{\Pr(\mathbf{w}\mid\boldsymbol{X},\boldsymbol{\phi})\Pr(\boldsymbol{\phi})}{\Pr(\mathbf{w}\mid\boldsymbol{X})} \]
其中
\[ \begin{aligned} \Pr(\mathbf{w}\mid\boldsymbol{X},\boldsymbol{\phi})&=\prod_{i=1}^I\lambda^{w_i}(1-\lambda)^{1-w_i}\\ &=\prod_{i=1}^I\left(\frac{1}{1+\exp[-\boldsymbol{\phi}^\mathrm{T}\mathbf{x}_i]}\right)^{w_i}\left(\frac{\exp[-\boldsymbol{\phi}^\mathrm{T}\mathbf{x}_i]}{1+\exp[-\boldsymbol{\phi}^\mathrm{T}\mathbf{x}_i]}\right)^{1-w_i} \end{aligned} \]
但这两者并不是共轭关系,所以没有闭式表达式,必须进行近似——拉普拉斯近似。
推理
在推理中,我们得到一组新的观测数据 \(\mathbf{x}^*\),并使用后验分布,通过 \(\boldsymbol{\phi}\) 的每一个可能取值加权得到 \(w^*\) 的预测。
3. Non-Linear Logistic Regression
计算观测数据的非线性变换 \(\mathbf{z}=f[\mathbf{x}]\):
\[ \Pr(w=1\mid \mathbf{x},\boldsymbol{\phi})=\mathrm{Bern}_w\big[\operatorname{sig}[\boldsymbol{\phi}^\mathrm{T}\mathbf{z}]\big]=\mathrm{Bern}_w\big[\operatorname{sig}[\boldsymbol{\phi}^\mathrm{T}f[\mathbf{x}]]\big] \]
4. Dual Logistic Regression
在原始线性模型中,对观测数据 \(\mathbf{x}\) 的每一个维度都有一个相对应的权重分量。对偶形式把权重写成数据的线性组合:
\[ \boldsymbol{\phi}=\boldsymbol{X}\boldsymbol{\psi} \]
\(\boldsymbol{\psi}\) 是一个 \(I\times1\) 的变量,其中每个元素都是一个观测数据样本的权值。如果 \(I\) 小于观测数据 \(\mathbf{x}\) 的维度,那么参数个数就减少了。
可得
\[ \Pr(\mathbf{w}\mid\boldsymbol{X},\boldsymbol{\psi})=\prod_{i=1}^I\mathrm{Bern}_{w_i}\big[\operatorname{sig}[a_i]\big]=\prod_{i=1}^I\mathrm{Bern}_{w_i}\big[\operatorname{sig}[\boldsymbol{\psi}^\mathrm{T}\boldsymbol{X}^\mathrm{T}\mathbf{x}_i]\big] \]
5. Kernel Logistic Regression
\[ k[\mathbf{x}_i,\mathbf{x}_j]=\mathbf{z}_i^\mathrm{T}\mathbf{z}_j \]
\[ \Pr(\mathbf{w}\mid\boldsymbol{X},\boldsymbol{\psi})=\prod_{i=1}^I\mathrm{Bern}_{w_i}\big[\operatorname{sig}[a_i]\big]=\prod_{i=1}^I\mathrm{Bern}_{w_i}\big[\operatorname{sig}[\boldsymbol{\psi}^\mathrm{T}K[\boldsymbol{X},\mathbf{x}_i]]\big] \]
- 可以用最大似然估计
- 核逻辑回归的贝叶斯形式,也就是我们所熟知的高斯过程分类
6. Relevance Vector Classification
核逻辑回归模型的贝叶斯方法非常有用,但由于需要计算变换空间中新数据样本和所有训练样本之间的点积,计算复杂度非常大。若模型只依赖于少量数据样本,效率就可以进一步提高:
\[ \Pr(\boldsymbol{\psi})=\prod_{i=1}^I\mathrm{Stud}_{\psi_i}[0,1,\nu] \]
把贝叶斯方法应用到关于参数 \(\boldsymbol{\psi}\) 的模型中,即是相关向量分类。
7. Incremental Fitting & Boosting
Incremental fitting
使用贪心算法,在模型中一次只添加一个参数;换句话说,添加参数是为了在每个阶段改善目标函数,然后就把该参数固定住。
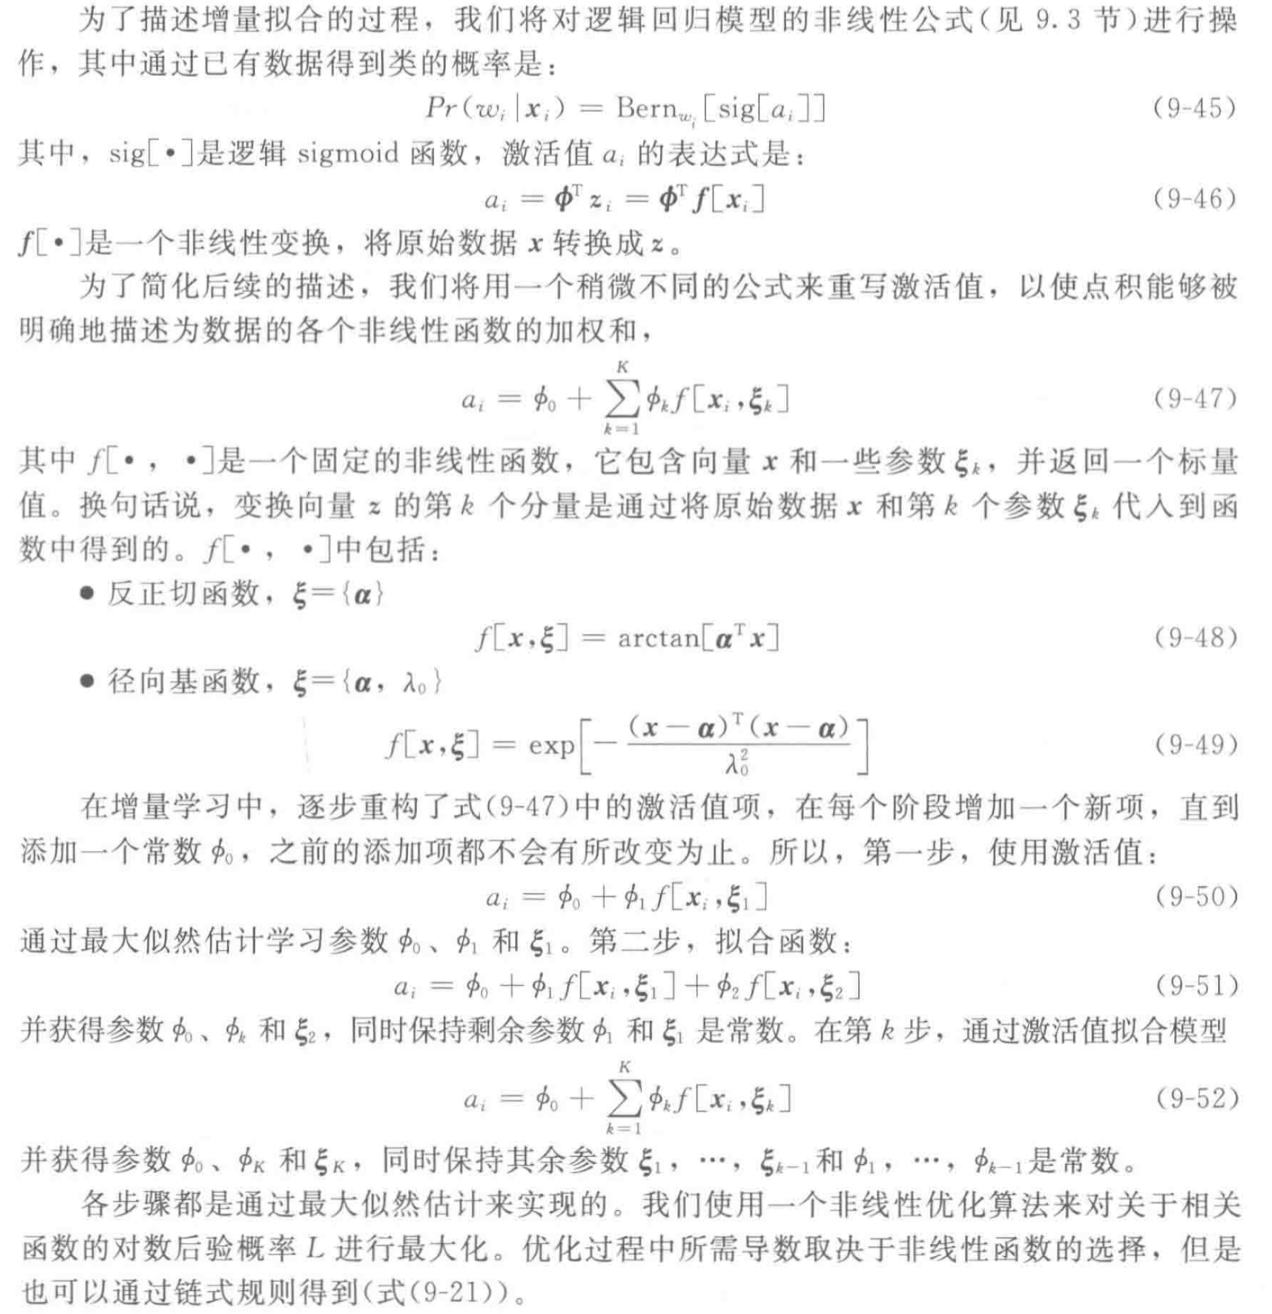
优点:
- 创建了稀疏模型
- 当数据是高维数据并且有大量训练样本时,它仍然适用
- 学习的复杂度相对较低,因为每个阶段只优化几个参数
Boosting
拟合非线性逻辑回归的增量方法有一个特例,常用于计算机视觉应用。考虑基于阶跃函数之和的逻辑回归模型:
\[ a_i=\phi_0+\sum_{k=1}^K\phi_k\operatorname{heaviside}\big[\boldsymbol{\alpha}_k^\mathrm{T}\mathbf{x}_i\big] \]
阶跃函数可以视为一种弱分类器:它根据 \(\mathbf{x}_i\) 的值返回 0 或 1。该模型结合这些弱分类器来计算最终的强分类器。这种把弱分类器组合起来的方式通常称为 boosting,而这种特殊的模型称为 logitboost。
缺点:因为模型由阶跃函数组成,所以最终的分类边界并不规则,并且在数据样本之间不能平滑地插值。
Graphical Models
1. Conditional Independence
\[ \Pr(x_1,x_2)=\Pr(x_1)\Pr(x_2) \]
本章探索概率分布的因子分解与条件独立两者之间的关系。基于图的表示方法将使这两个问题都更容易描述。
2. Directed Graphical Models
有向图模型(又称贝叶斯网络)把联合概率分布的因子分解表示为条件分布的乘积,其结构是一个有向无环图(directed acyclic graph, DAG):
\[ \Pr(x_{1\cdots N})=\prod_{n=1}^N\Pr\big(x_n\mid x_{\mathrm{pa}[n]}\big) \]
其中 \(\{x_n\}_{n=1}^N\) 表示联合分布中的随机变量,函数 \(\mathrm{pa}[n]\) 返回变量 \(x_n\) 父节点的索引值。
一个变量的马尔可夫覆盖(Markov blanket)由它的父节点、子节点,以及这些子节点的其他父节点组成。
3. Undirected Graphical Models
无向图模型利用势函数 \(\phi[x_{1\cdots N}]\) 的乘积来表示变量 \(\{x_n\}_{n=1}^N\) 的概率分布:
\[ \Pr(x_{1\cdots N})=\frac{1}{Z}\prod_{c=1}^C\phi_c\big[x_{1\cdots N}\big] \]
配分函数 \(Z\) 用来归一化这些正势函数的乘积,以满足概率和为 1 的条件:
\[ Z=\sum_{x_1}\sum_{x_2}\cdots\sum_{x_N}\prod_{c=1}^C\phi_c\big[x_{1\cdots N}\big] \]
上面的无向图模型公式等同于
\[ \Pr(x_{1\cdots N})=\frac{1}{Z}\exp\bigg[-\sum_{c=1}^C\psi_c\big[x_{1\cdots N}\big]\bigg] \]
其中 \(\psi_c[x_{1\cdots N}]=-\log\big[\phi_c[x_{1\cdots N}]\big]\)。这种形式下的概率分布叫做吉布斯分布。
如果每个势函数 \(\phi[\cdot]\)(或相应的成本函数 \(\psi[\cdot]\))都包含 \(x_{1\cdots N}\) 中所有的变量,那么该无向图模型称为专家乘积(Product of Experts)系统。
然而在计算机视觉领域更常见的情况是,每个势函数操作的对象仅仅是原变量 \(x_{1\cdots N}\) 的一个子集 \(\mathcal{S}, \mathcal{S}\subset \{x_n\}_{n=1}^N\)。这些子集称作团(clique),同时条件独立关系可由这些对应的团来表示。把第 \(c\) 个团记作 \(\mathcal{S}_c\),则上式可以表示为
\[ \Pr(x_{1\cdots N})=\frac{1}{Z}\prod_{c=1}^C\phi_c[\mathcal{S}_c] \]
概率分布被因子分解为若干项的积,每项仅依赖于变量的一个子集。一般称这样的模型为马尔可夫随机场。
最大团(maximal clique):团中的每个节点都是全连接的(即团中每个节点与其余节点都相连),并且一旦向这个团中增加任何另外的节点,就不可能再保持所有节点相互连接。
4. 有向模型与无向模型的比较
两类模型都把联合分布因子分解,但表达的独立性结构不同:
- 有向模型用条件分布的乘积,天然是归一化的(不需要配分函数 \(Z\)),适合表达因果/生成过程;但它会引入 explaining away(共同父节点的两个子节点在观测到子节点后变得相关),这种依赖无法用无向图表示。
- 无向模型用势函数的乘积,需要配分函数 \(Z\) 归一化,因此学习时更困难;但它适合表达对称的、相互的约束(例如相邻像素倾向于取相同标签),这种「无方向偏好」的依赖用有向图表示会很别扭。
- 两者的表达能力并不互相包含:存在有向图能表达而无向图不能的独立性结构(如 explaining away),也存在无向图能表达而有向图不能的(如四节点环)。
5. Graphical Models in Computer Vision
视觉中的常见图模型结构:
- 链(chain):时序问题,如跟踪、手势识别。有向版本即 HMM,无向版本即链式 MRF。
- 树(tree):关节物体,如人体姿态的 pictorial structures。
- 网格(grid):像素级标注问题,如分割、去噪、立体匹配。每个像素一个节点,相邻像素之间有边,编码「相邻像素标签倾向一致」的平滑先验。
- KL 结构与非树结构:一般图上的精确推理是 NP 难的,因此需要下节的近似方法(采样、图割、循环置信传播)。
6. Inference in Models with Many Unknowns
1. 求最大后验概率的解
\[ \begin{aligned} \hat{w}_{1\cdots N}&=\operatorname*{argmax}_{w_{1\cdots N}}\big[\Pr(w_{1\cdots N}\mid x_{1\cdots N})\big]\\ &=\operatorname*{argmax}_{w_{1\cdots N}}\big[\Pr(x_{1\cdots N}\mid w_{1\cdots N})\Pr(w_{1\cdots N})\big] \end{aligned} \]
2. 求后验概率分布的边缘分布
\[ \Pr(w_{n}\mid x_{1\cdots N})=\int\!\!\int \Pr(w_{1\cdots N}\mid x_{1\cdots N})\,\mathrm{d}w_{1\cdots n-1}\,\mathrm{d}w_{n+1\cdots N} \]
3. 最大化边缘
\[ \hat{w}_n=\operatorname*{argmax}_{w_n}\big[\Pr(w_n\mid x_{1\cdots N})\big] \]
4. 后验分布的采样
7. Sampling
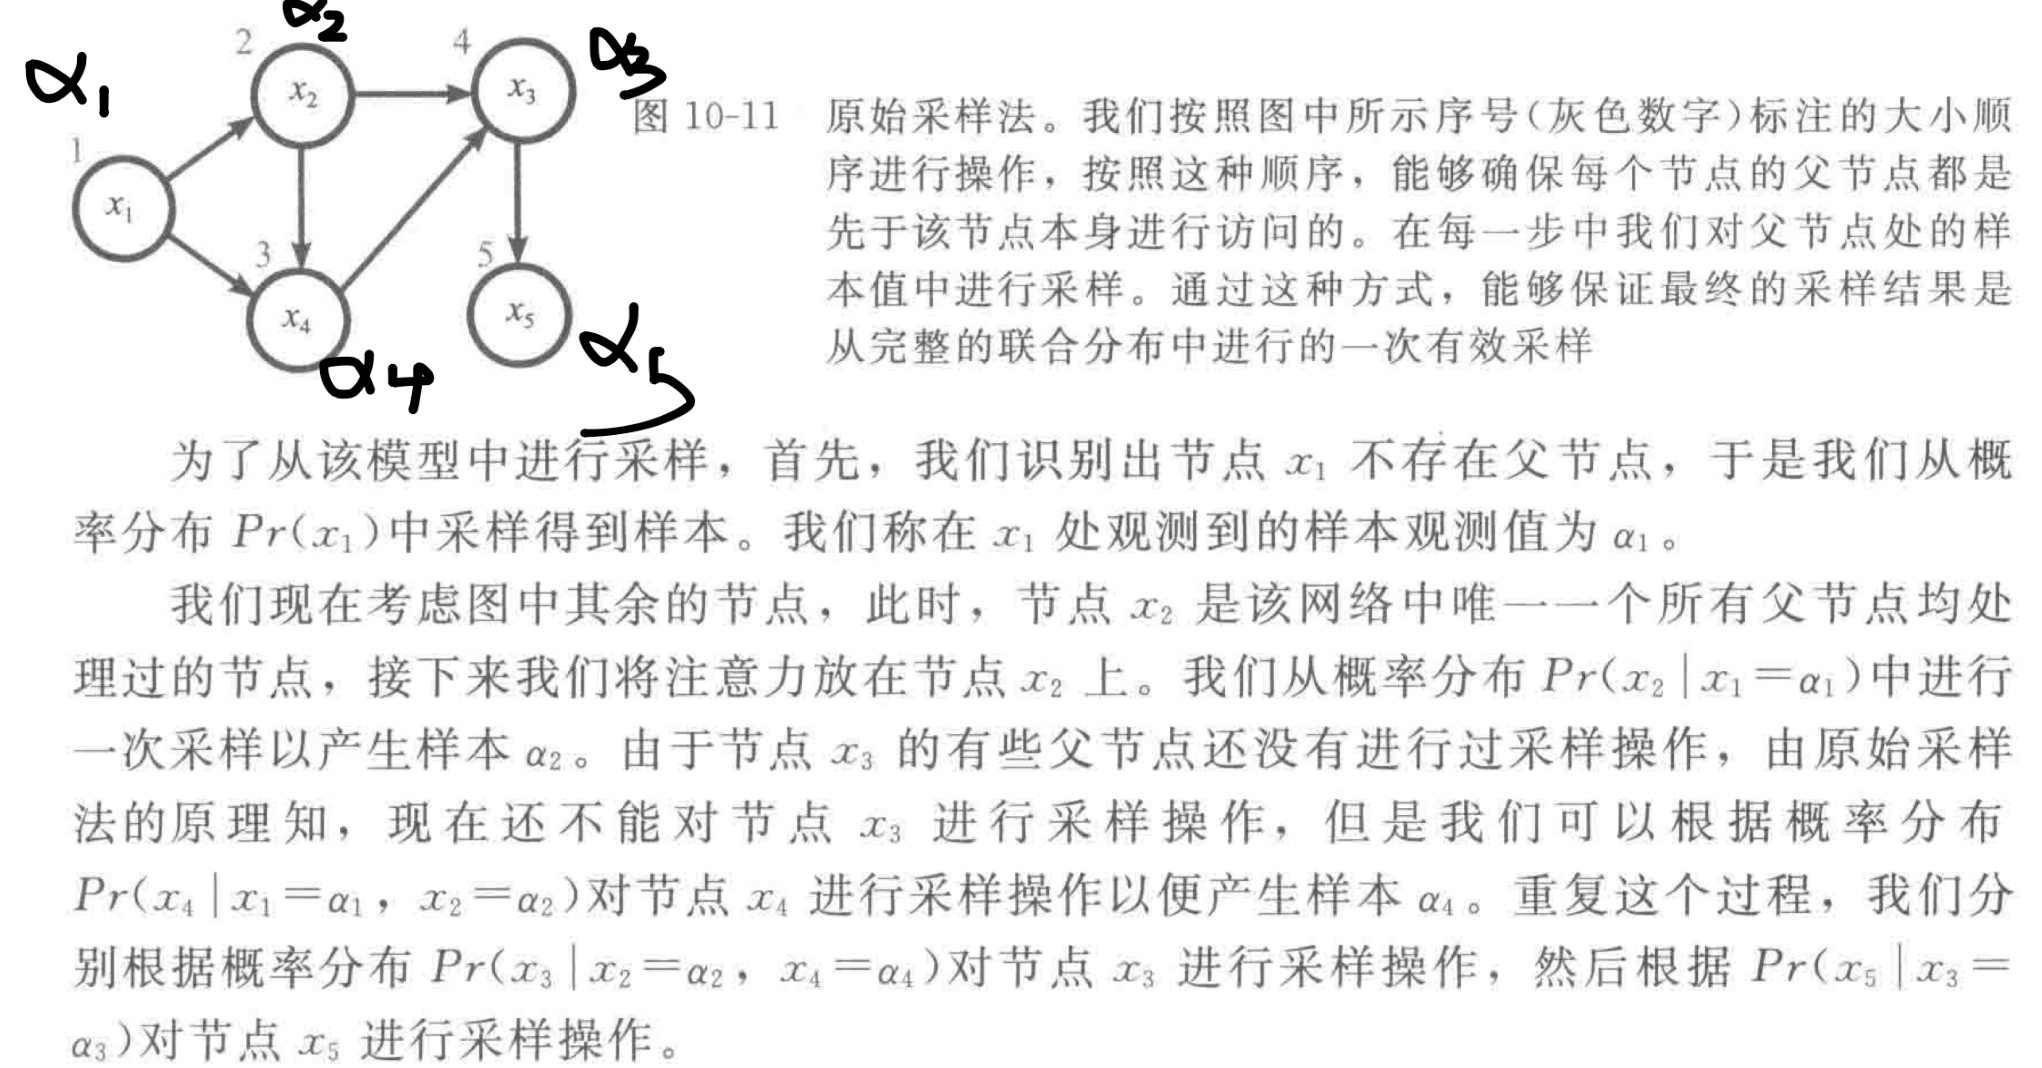
有向图模型的采样
有向图模型的代数表达式:
\[ \Pr(x_{1\cdots N})=\prod_{n=1}^N\Pr\big(x_n\mid x_{\mathrm{pa}[n]}\big) \]
使用原始采样法(ancestral sampling):在有向图网络中轮流对每个变量采样,只需确保某节点对应的所有父节点都先于该节点被采样。对于每个节点,我们观察其父节点的采样值,再从对应的条件分布中采样。
无向图模型的采样
一种可行的方法是使用马尔可夫链蒙特卡洛(MCMC)方法。该方法的原理是从分布中产生一系列样本,每个采样样本都直接依赖于先前的采样样本(即「马尔可夫」),同时样本的产生并非完全确定(即「蒙特卡洛」)。
最简单的 MCMC 方法之一是吉布斯采样。
8. Learning
有向模型中的学习
一个序列的概率由条件概率的乘积给出:
\[ \Pr(x_{1\cdots N}) = \prod_{n=1}^N \Pr\big(x_n \mid x_{\mathrm{pa}[n]}\big) \]
为了找到最优参数,使用标准的最大似然(ML)形式:
\[ \hat{\theta} = \operatorname*{argmax}_{\theta} \prod_{i=1}^I \prod_{n=1}^N \Pr\big(x_{i,n} \mid x_{i,\mathrm{pa}[n]}, \theta\big) \]
也可以写成
\[ \hat{\theta} = \operatorname*{argmax}_{\theta} \sum_{i=1}^I \sum_{n=1}^N \log\big[\Pr(x_{i,n} \mid x_{i,\mathrm{pa}[n]}, \theta)\big] \]
其中 \(x_{i,n}\) 是第 \(i\) 个训练样本的第 \(n\) 个维度。
无向模型中的学习
写成吉布斯分布的形式:
\[ \Pr(x) = \frac{1}{Z(\theta)} \exp\left(- \sum_{c=1}^C \psi_c\big[x_{1\cdots N}, \theta\big]\right) \]
用最大似然估计求最优参数:
\[ \hat{\theta} = \operatorname*{argmax}_{\theta} \frac{1}{Z(\theta)^I} \exp\left(- \sum_{i=1}^I \sum_{c=1}^C \psi_c(x_i, \theta) \right) \]
取对数后可以化简为
\[ \hat{\theta} = \operatorname*{argmax}_{\theta} \left[-I \log\big[Z(\theta)\big] - \sum_{i=1}^I \sum_{c=1}^C \psi_c(x_i, \theta)\right] \]
难点在于 \(Z(\theta)\) 依赖于参数,且是对所有状态组合求和,通常无法计算。
Models for Chains and Trees
1. Models for Chains
Directed model for chains
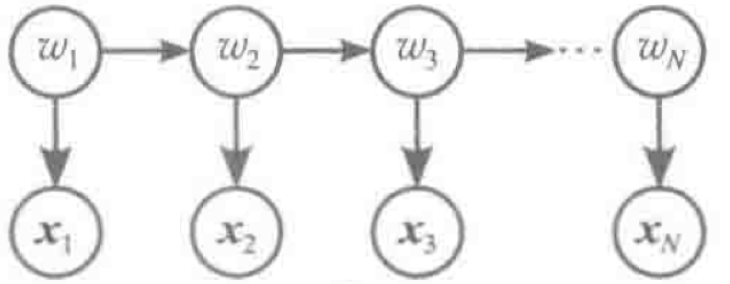
\[ \Pr(x_{1\cdots N},w_{1\cdots N})=\left(\prod_{n=1}^N\Pr(x_n\mid w_n)\right)\left(\prod_{n=2}^N\Pr(w_n\mid w_{n-1})\right) \]
这就是所谓的隐马尔可夫模型(HMM),隐状态是 \(w_i\)。
Undirected model for chains
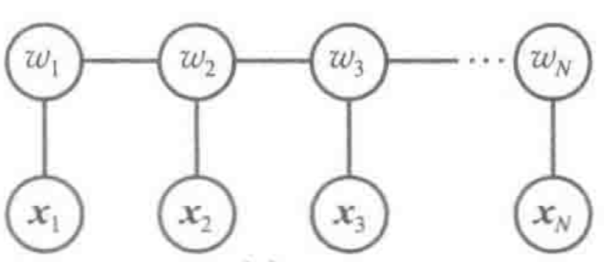
- 测量值与取确定值的数据之间的相容程度,被编码在一个势函数 \(\phi[x_n,w_n]\) 中:当测量状态和全局状态更兼容时,这个函数返回更大的正值。
- 相邻状态取相容值的倾向被编码在第二个势函数 \(\zeta[w_n, w_{n-1}]\) 中:当相邻状态更兼容时,这个函数返回更大的值。
\[ \Pr(x_{1\cdots N},w_{1\cdots N})=\frac{1}{Z}\left(\prod_{n=1}^{N}\phi\big[x_{n},w_{n}\big]\right)\left(\prod_{n=2}^{N}\zeta\big[w_{n},w_{n-1}\big]\right) \]
模型的等价性
如果在有向图链式模型中令
\[ \Pr(x_n\mid w_n)=\frac{1}{z_n}\phi[x_n,w_n], \qquad \Pr(w_n\mid w_{n-1})=\frac{1}{z_n^{\prime}}\zeta[w_n,w_{n-1}] \]
且 \(Z=\left(\prod_{n=1}^N z_n\right)\left(\prod_{n=2}^N z_n'\right)\),则有向图链式模型与无向图链式模型是等价的。
马尔可夫随机场中节点之间的关系是相互的,而不是单向影响;但在隐马尔可夫模型中,节点之间的关系不是相互的,是单向影响。这个区别体现在前者是无向图、后者是有向图。
在 HMM 中,状态变量被称为隐状态,因为它们不被直接观测,而是通过观测状态间接推断。在 MRF 中,状态变量可能是可观测的或不可观测的,通常不特指为隐状态,因为 MRF 关注的是节点之间的相互依赖性,无论这些节点是观测的还是隐含的。
2. MAP Inference in Chain Models
\[ \begin{aligned} \hat{w}_{1\cdots N}& =\operatorname*{argmax}_{w_{1\cdots N}}\big[\Pr(w_{1\cdots N}\mid x_{1\cdots N})\big] \\ &=\operatorname*{argmax}_{w_{1\cdots N}}\big[\Pr(x_{1\cdots N},w_{1\cdots N})\big] \\ &=\operatorname*{argmin}_{w_{1\cdots N}}\big[-\log[\Pr(x_{1\cdots N},w_{1\cdots N})]\big] \end{aligned} \]
代入有向图公式:
\[ \hat{w}_{1\cdots N}=\operatorname*{argmin}_{w_{1\cdots N}}\bigg[-\sum_{n=1}^{N}\log\big[\Pr(x_{n}\mid w_{n})\big]-\sum_{n=2}^{N}\log\big[\Pr(w_{n}\mid w_{n-1})\big]\bigg] \]
\[ \Downarrow \]
\[ \hat{w}_{1\cdots N}=\operatorname*{argmin}_{w_{1\cdots N}}\bigg[\sum_{n=1}^N U_n(w_n)+\sum_{n=2}^N P_n(w_n,w_{n-1})\bigg] \]
其中 \(U_n\) 是一个一元项,只依赖于单个变量 \(w_n\);而 \(P_n\) 是二元项,取决于两个变量 \(w_n\) 和 \(w_{n-1}\):
\[ U_n(w_n)=-\log\big[\Pr(x_n\mid w_n)\big], \qquad P_n(w_n,w_{n-1})=-\log\big[\Pr(w_n\mid w_{n-1})\big] \]
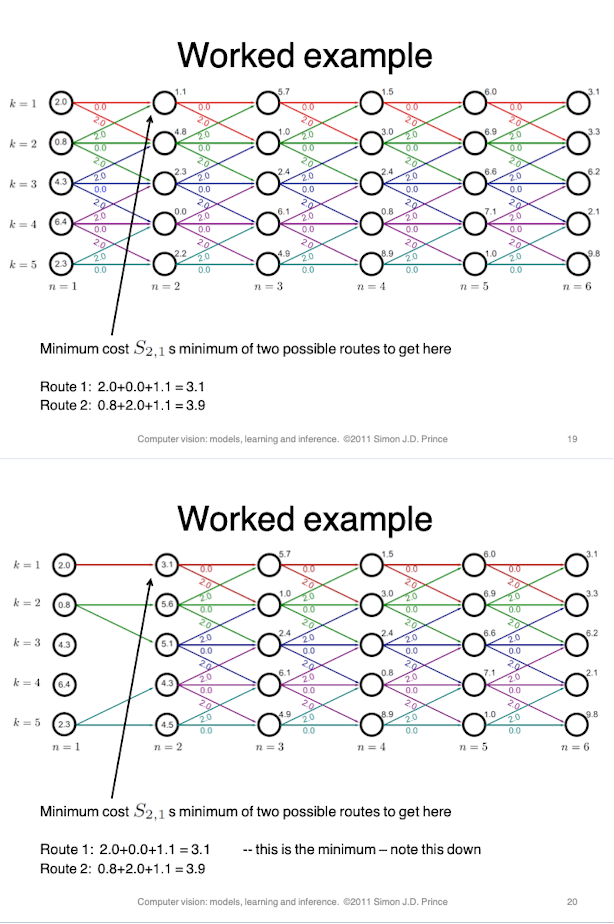
上面这个链式 MAP 问题可以在多项式时间内用维特比算法解决,该算法是动态规划的一个例子。
Viterbi Algorithm
目标是求出到达顶点 \(V_{n,k}\) 的最小可能累积代价 \(S_{n,k}\):
\[ S_{n,k}=U_n(w_n=k)+\min_l\big[S_{n-1,l}+P_n(w_n=k,\ w_{n-1}=l)\big] \]
3. MAP Inference in Tree Models
树上的 MAP 推理同样可以用动态规划精确求解,做法是把维特比算法推广为从叶节点向根节点的消息传递:
- 任选一个节点作为根,把树定向。
- 从叶节点开始,每个节点 \(n\) 向其父节点 \(m\) 传递一条消息,内容是「在 \(w_m\) 取每个可能值的条件下,以 \(n\) 为根的整棵子树所能达到的最小代价」:
\[ S_{n\to m}(w_m)=\min_{w_n}\bigg[U_n(w_n)+P_{nm}(w_n,w_m)+\sum_{c\in \mathrm{ch}[n]}S_{c\to n}(w_n)\bigg] \]
- 根节点收到所有子节点的消息后,取 \(\hat{w}_{\text{root}}=\operatorname{argmin}\big[U_{\text{root}}(w)+\sum_c S_{c\to \text{root}}(w)\big]\)。
- 再从根向叶回溯,逐层取回使各条消息达到最小值的取值。
链是树的特例(每个节点最多一个子节点),此时上式就退化为前面的维特比递推。关键在于树没有环,因此每条消息只需计算一次,总复杂度为 \(O(NK^2)\)。
4. Maximum Marginals in Chain Models
\[ \Pr(w_{N}\mid x_{1\cdots N})=\frac{\Pr(w_{N},x_{1\cdots N})}{\Pr(x_{1\cdots N})}\propto \Pr(w_{N},x_{1\cdots N}) \]
\[ \begin{aligned} \Pr(w_{N},x_{1\cdots N})& \propto\sum_{w_1}\sum_{w_2}\cdots\sum_{w_{N-1}}\Pr(w_{1\cdots N},x_{1\cdots N}) \\ &\propto\sum_{w_1}\sum_{w_2}\cdots\sum_{w_{N-1}}\left(\prod_{n=1}^N\Pr(x_n\mid w_n)\right)\Pr(w_1)\left(\prod_{n=2}^N\Pr(w_n\mid w_{n-1})\right) \end{aligned} \]
求解边缘分布
\[ \Pr(w_N\mid x_{1\cdots N})\propto \Pr(x_{N}\mid w_{N})\sum_{w_{N-1}}\cdots\sum_{w_{2}}\Pr(w_{3}\mid w_{2})\Pr(x_{2}\mid w_{2})\sum_{w_1}\Pr(w_{2}\mid w_{1})\Pr(x_{1}\mid w_{1})\Pr(w_{1}) \]
这种方法叫做消元法:
\[ \begin{aligned} &f_1[w_1]=\Pr(x_1\mid w_1)\Pr(w_1)\\ &f_n[w_n]=\Pr(x_n\mid w_n)\sum_{w_{n-1}}\Pr(w_n\mid w_{n-1})f_{n-1}[w_{n-1}] \end{aligned} \]
前向后向算法
本节的目标是开发一个方法,能够利用前向后向算法同时且高效地计算所有变量的边缘后验概率:
\[ \begin{aligned} \Pr(w_{n}\mid x_{1\cdots N})& \propto \Pr(w_n,x_{1\cdots N}) \\ &=\Pr(w_n,x_{1\cdots n})\Pr(x_{n+1\cdots N}\mid w_n,x_{1\cdots n}) \\ &=\Pr(w_n,x_{1\cdots n})\Pr(x_{n+1\cdots N}\mid w_n) \end{aligned} \]
前向递归
\[ \begin{aligned} \Pr(w_{n},\mathbf{x}_{1\cdots n}) &=\sum_{w_{n-1}}\Pr(w_n,w_{n-1},\mathbf{x}_{1\cdots n}) \\ &=\sum_{w_{n-1}}\Pr(w_n,\mathbf{x}_n\mid w_{n-1},\mathbf{x}_{1\cdots n-1})\Pr(w_{n-1},\mathbf{x}_{1\cdots n-1}) \\ &=\sum_{w_{n-1}}\Pr(\mathbf{x}_n\mid w_n,w_{n-1},\mathbf{x}_{1\cdots n-1})\Pr(w_n\mid w_{n-1},\mathbf{x}_{1\cdots n-1})\Pr(w_{n-1},\mathbf{x}_{1\cdots n-1}) \\ &=\sum_{w_{n-1}}\Pr(\mathbf{x}_n\mid w_n)\Pr(w_n\mid w_{n-1})\Pr(w_{n-1},\mathbf{x}_{1\cdots n-1}) \end{aligned} \]
\[ \Downarrow \]
\[ f_n[w_n]=\Pr(\mathbf{x}_n\mid w_n)\sum_{w_{n-1}}\Pr(w_n\mid w_{n-1})\,f_{n-1}[w_{n-1}] \]
后向递归
\[ \begin{aligned} \Pr(x_{n\cdots N}\mid w_{n-1})& =\sum_{w_n}\Pr(x_{n\cdots N},w_n\mid w_{n-1}) \\ &=\sum_{w_n}\Pr(x_{n\cdots N}\mid w_n,w_{n-1})\Pr(w_n\mid w_{n-1}) \\ &=\sum_{w_n}\Pr(x_{n+1\cdots N}\mid x_n,w_n,w_{n-1})\Pr(x_n\mid w_n,w_{n-1})\Pr(w_n\mid w_{n-1}) \\ &=\sum_{w_n}\Pr(x_{n+1\cdots N}\mid w_n)\Pr(x_n\mid w_n)\Pr(w_n\mid w_{n-1}) \end{aligned} \]
\[ \Downarrow \]
\[ b_{n-1}[w_{n-1}]=\sum_{w_n}\Pr(x_n\mid w_n)\Pr(w_n\mid w_{n-1})\,b_n[w_n] \]
前向后向算法
\[ \Pr(w_n\mid x_{1\cdots N})\propto \Pr(w_n,x_{1\cdots n})\Pr(x_{n+1\cdots N}\mid w_n)=f_n[w_n]\,b_n[w_n] \]
置信传播
前向后向算法可以看作置信传播技术的一个特例。这里描述的是称为和积算法的置信传播版本。
5. Maximum Marginals in Tree Models
为了计算树形结构模型中的边缘值,只需把和积算法应用到新的图结构上:每个节点向邻居传递的消息,是对自身取值求和(而不是取最小)的结果。
Models for Shape
1. Shape and Its Representation
形状是在去除位置、缩放和旋转等几何效应之后,图像中所残留的几何信息。
2. Snakes
作为基础模型,可以考虑参数轮廓模型,这些模型有时也称为活动轮廓模型或 snake 模型。
设有 \(N\) 个未知的二维标志点集合 \(\boldsymbol{W}=[\mathbf{w}_1,\mathbf{w}_2,\ldots,\mathbf{w}_N]\)。当标志点 \(\boldsymbol{W}\) 位于或接近图像边缘时,给定 \(\boldsymbol{W}\) 的 RGB 图像数据 \(\mathbf{x}\) 的概率 \(\Pr(\mathbf{x}\mid\boldsymbol{W})\) 应该较高;当标志点位于一个平坦区域时,\(\Pr(\mathbf{x}\mid\boldsymbol{W})\) 较低:
\[ \Pr(\mathbf{x}\mid\boldsymbol{W})\propto\prod_{n=1}^N\exp\big[\operatorname{sobel}[\mathbf{x},\mathbf{w}_n]\big] \]
或者使用 Canny:
\[ \Pr(\mathbf{x}\mid\boldsymbol{W})\propto\prod_{n=1}^N\exp\left[-\big(\operatorname{dist}[\mathbf{x},\mathbf{w}_n]\big)^2\right] \]
推理
\[ \begin{aligned} \hat{\boldsymbol{W}}&=\operatorname*{argmax}_{\boldsymbol{W}}\big[\Pr(\boldsymbol{W}\mid \mathbf{x})\big]=\operatorname*{argmax}_{\boldsymbol{W}}\big[\Pr(\mathbf{x}\mid \boldsymbol{W})\Pr(\boldsymbol{W})\big]\\ &=\operatorname*{argmax}_{\boldsymbol{W}}\big[\log[\Pr(\mathbf{x}\mid \boldsymbol{W})]+\log[\Pr(\boldsymbol{W})]\big] \end{aligned} \]
Temporal Models
1. Temporal Estimation Framework
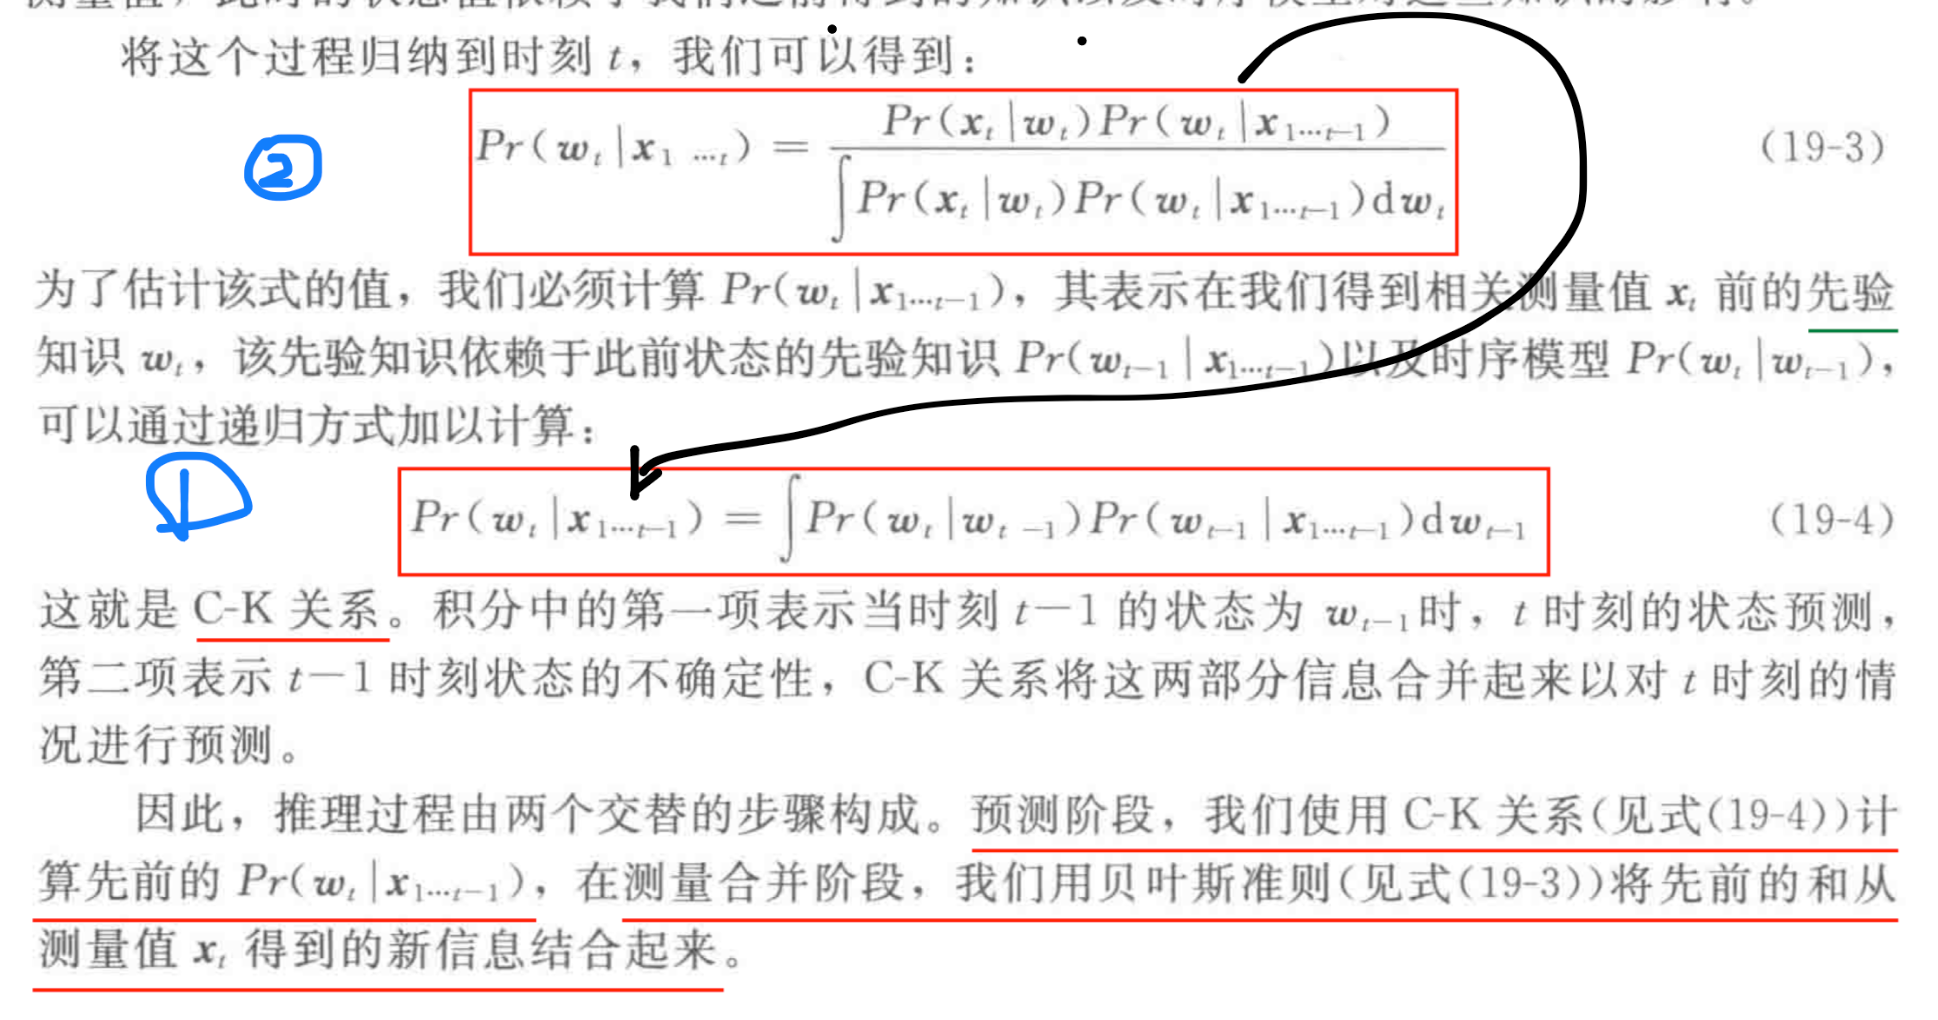
2. Kalman Filter
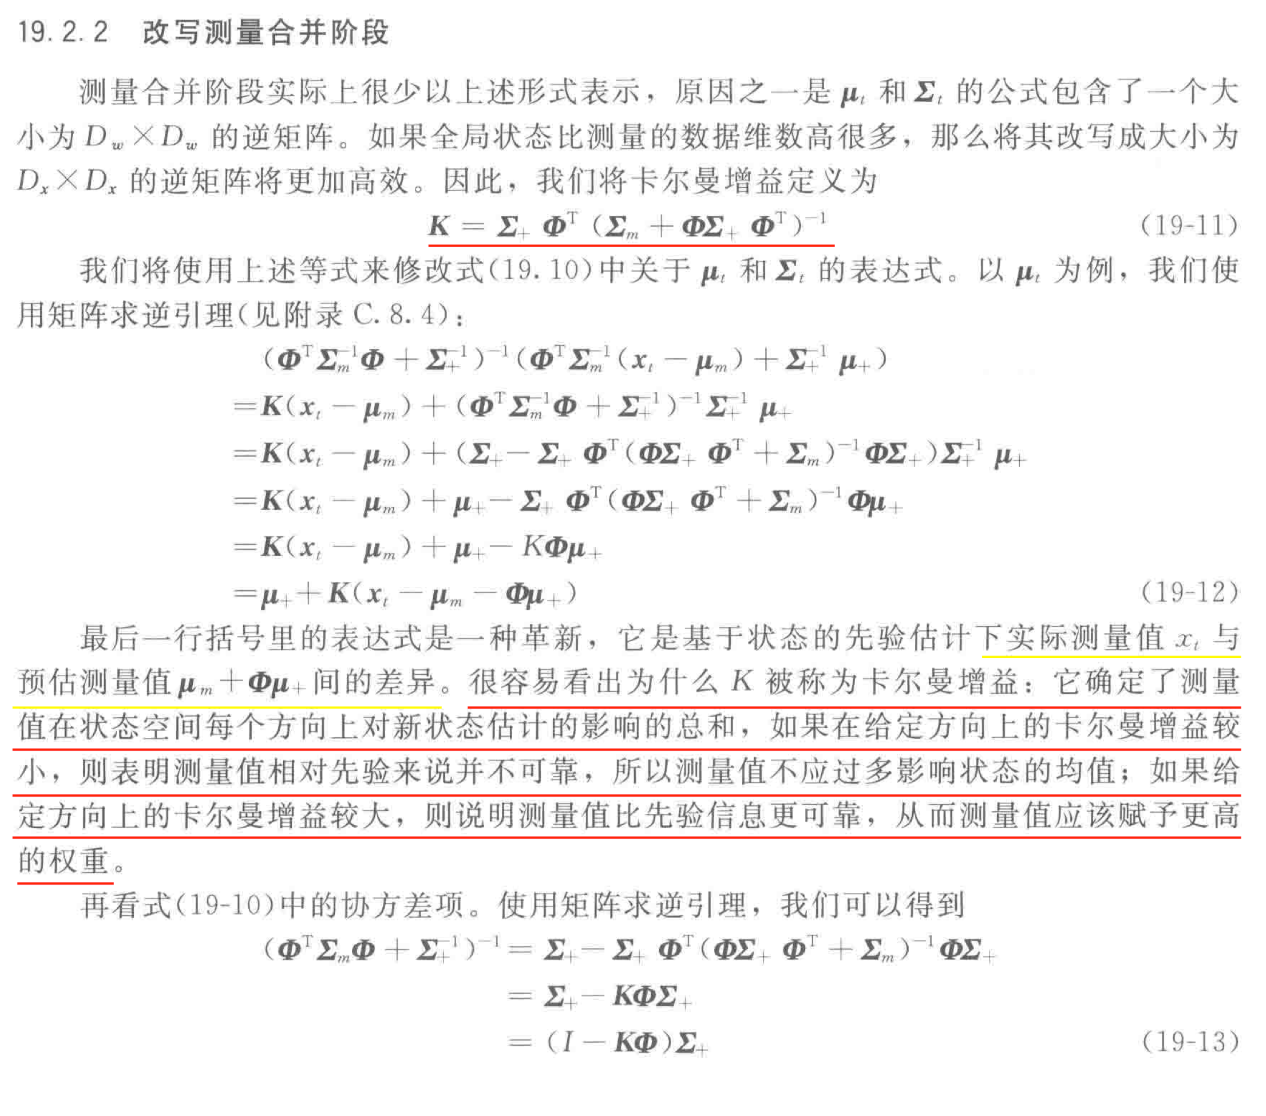
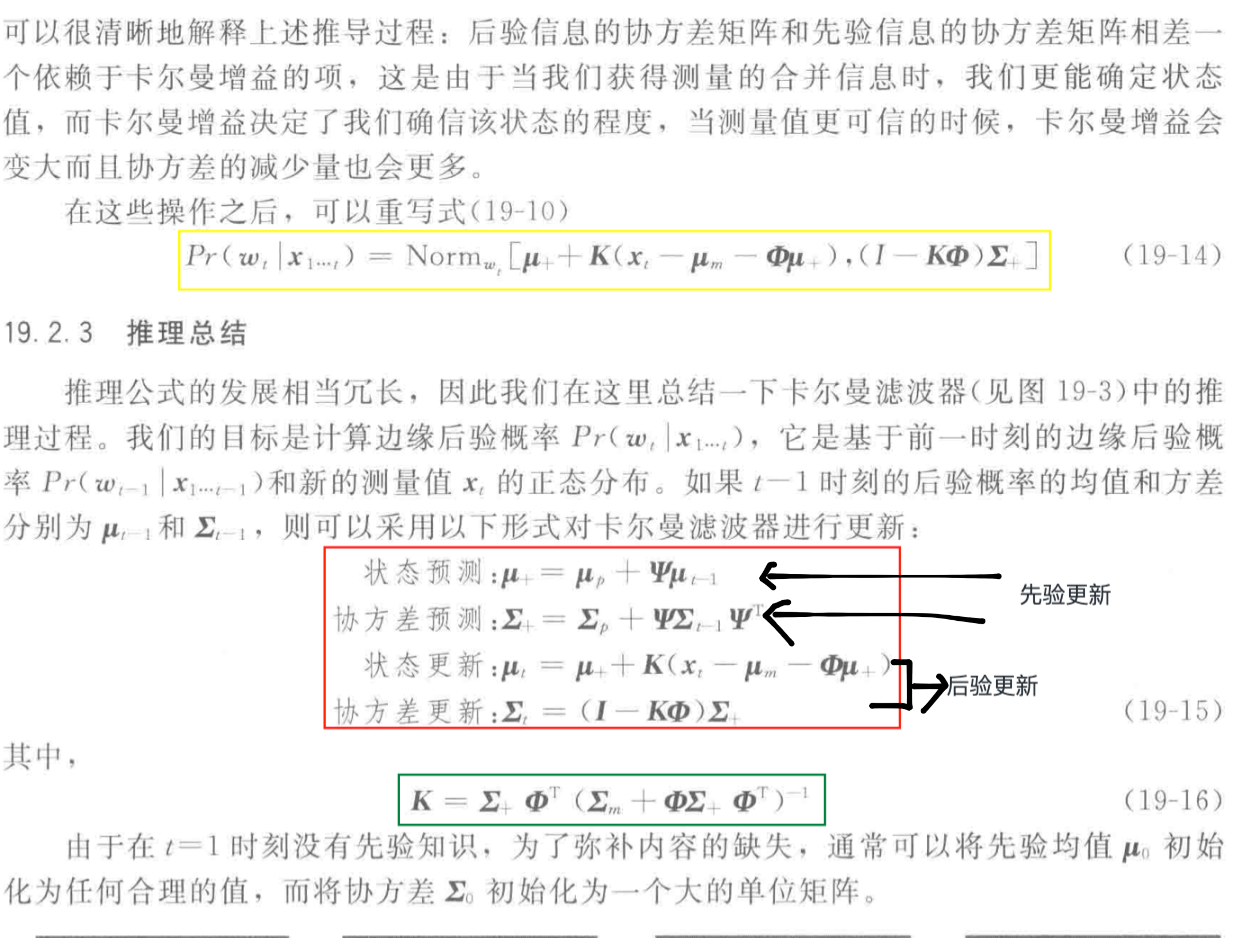
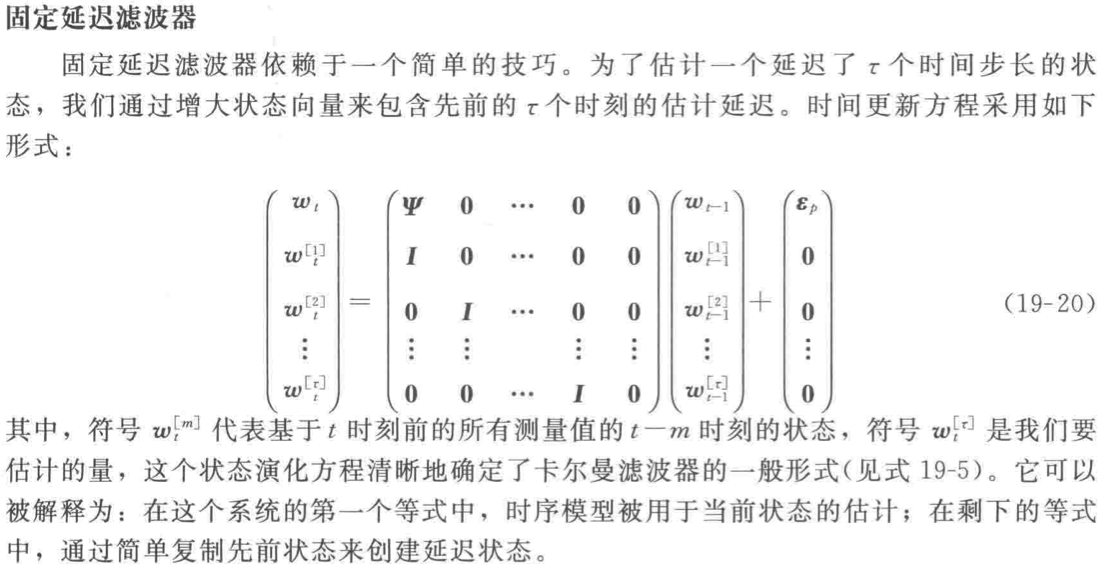
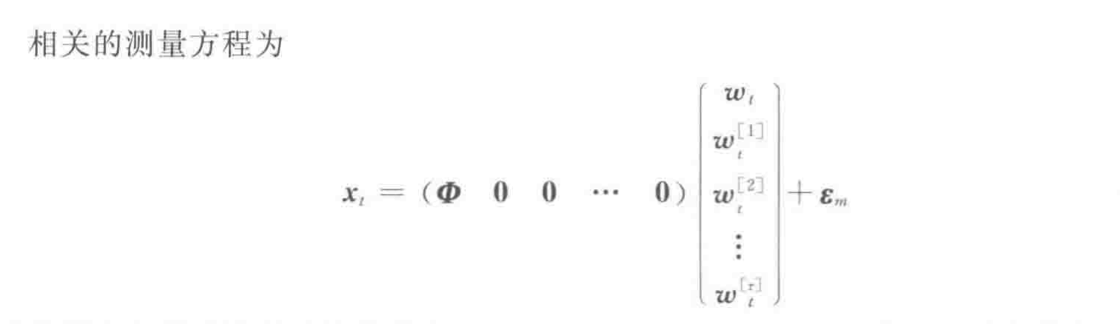
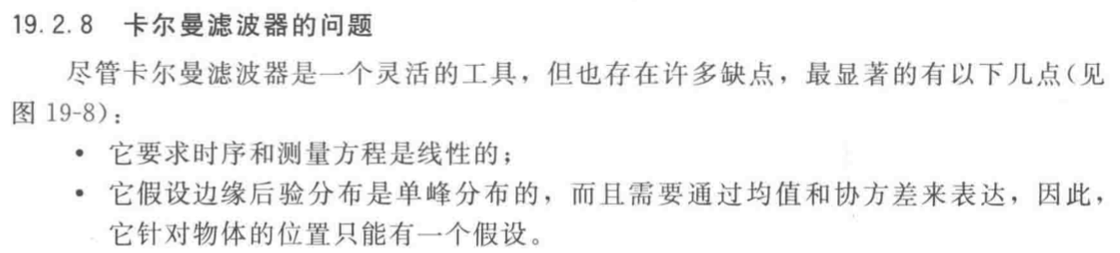
3. Extended Kalman Filter
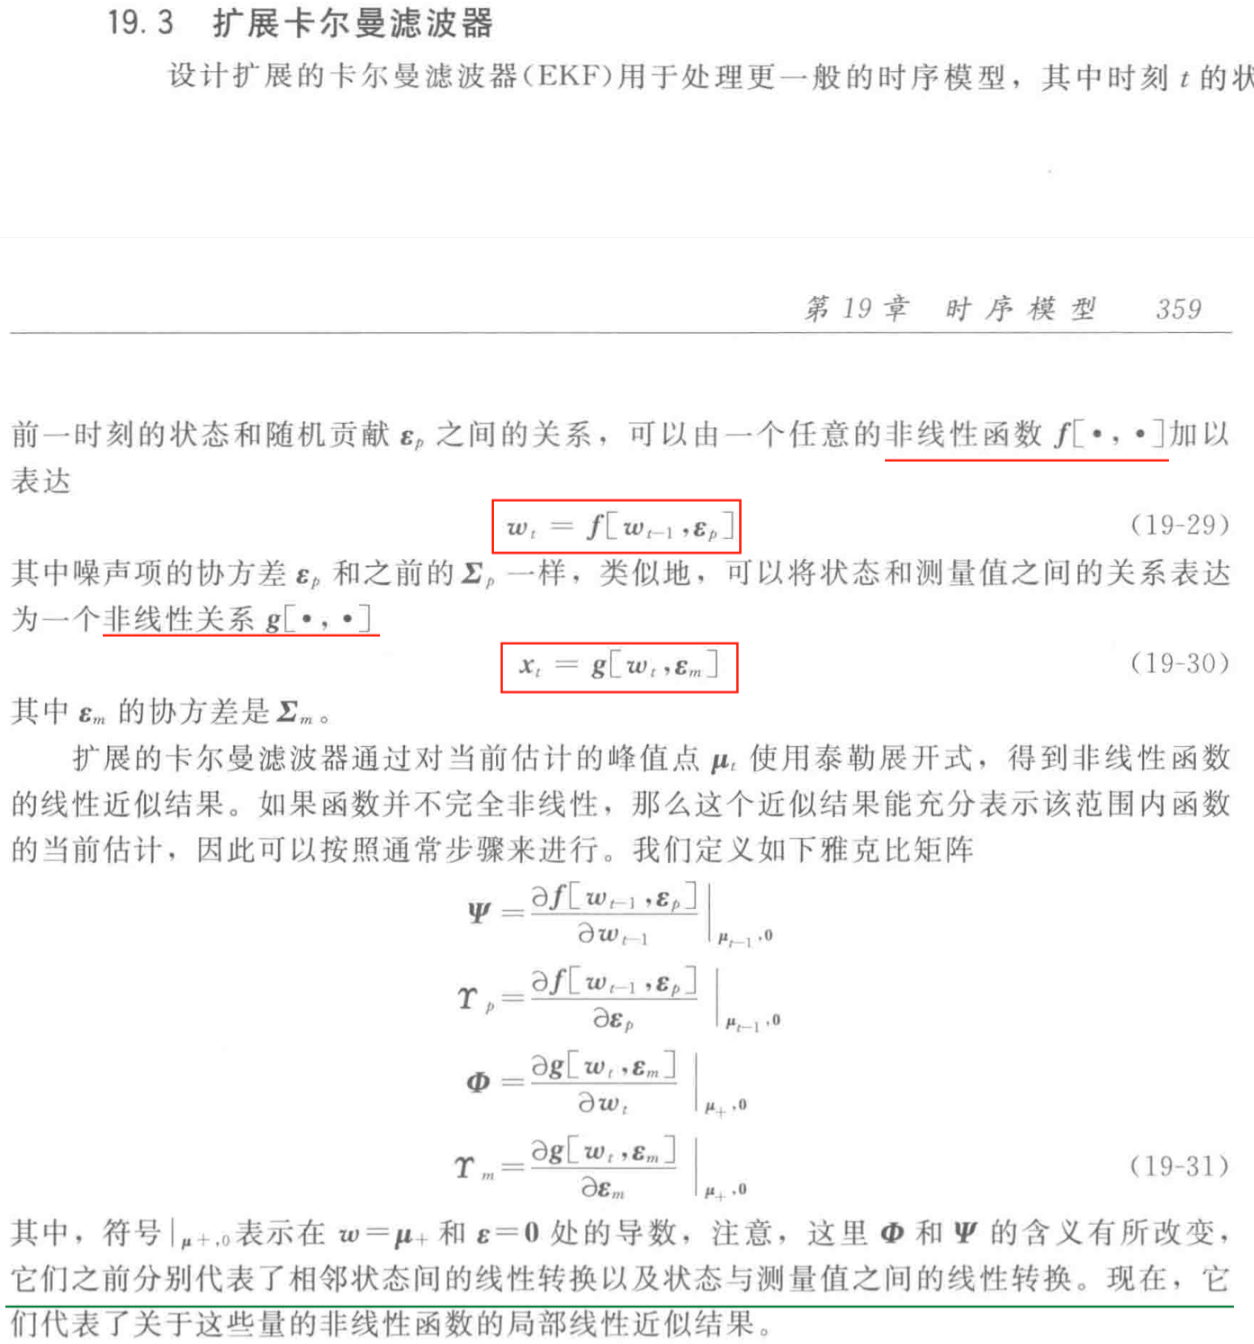
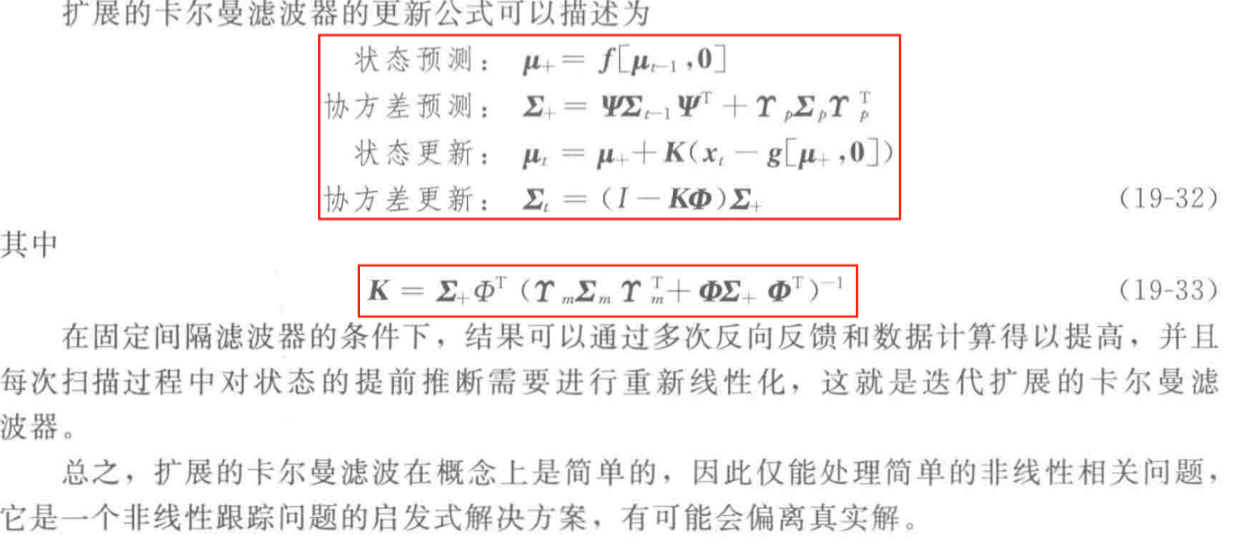
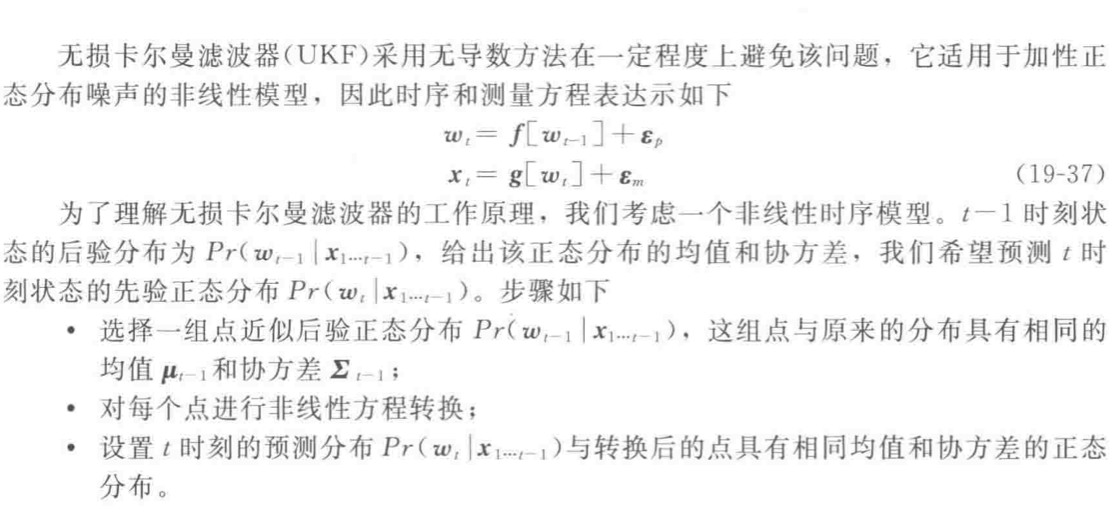
4. Unscented Kalman Filter
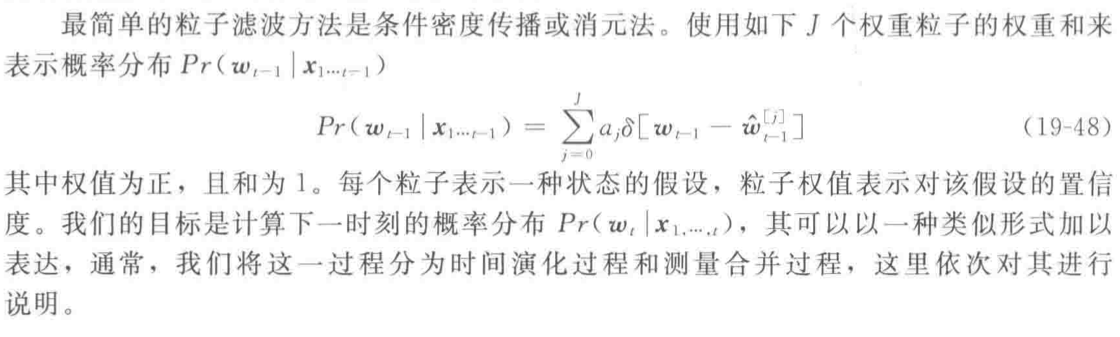
5. Particle Filtering