Reference:深蓝学院《NeRF 基础与常见算法解析》。以下按课程顺序整理。
NeRF
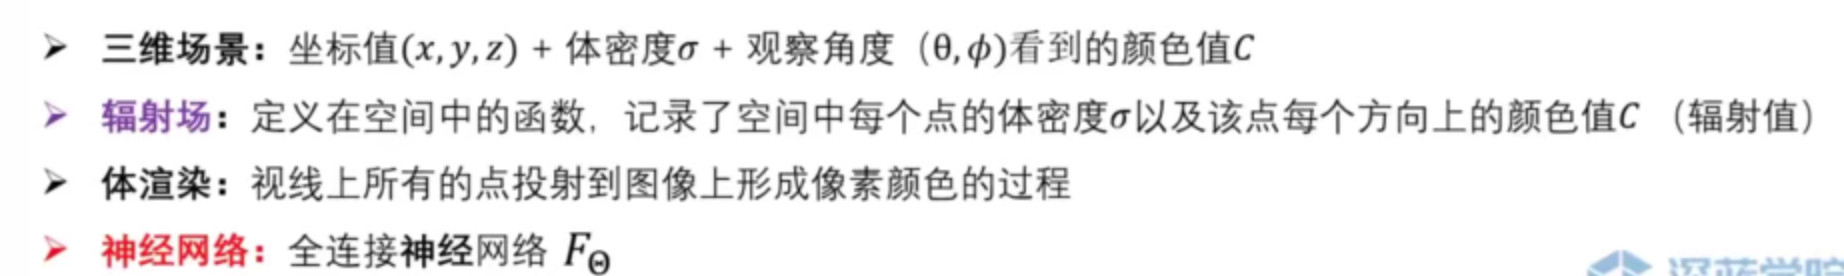
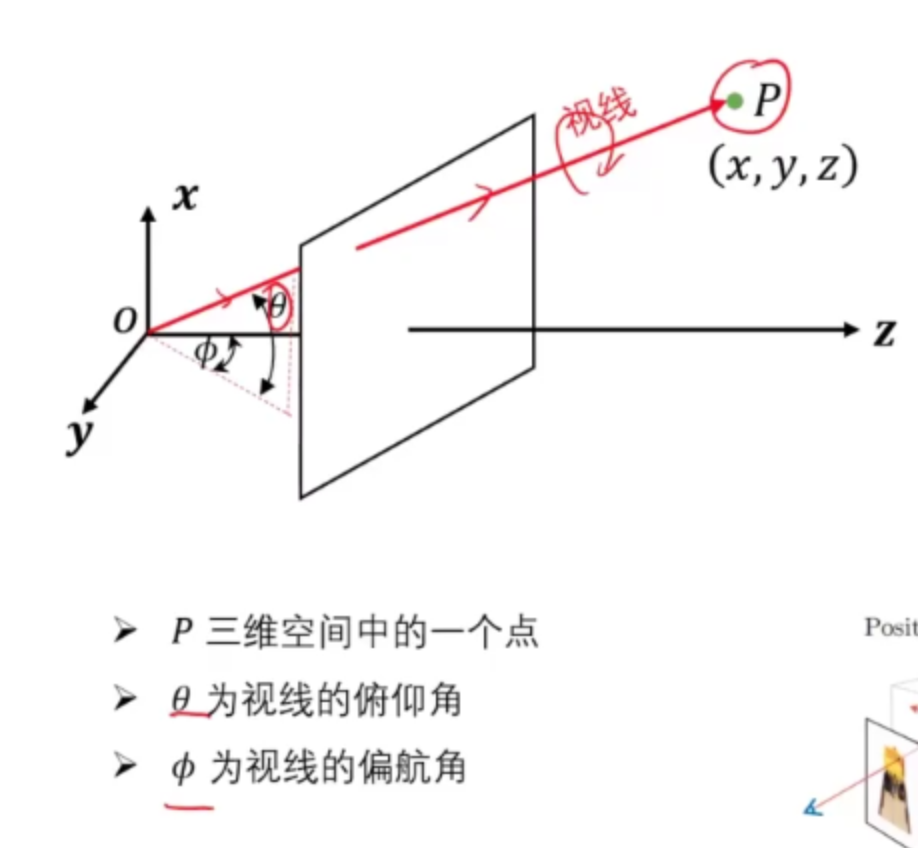
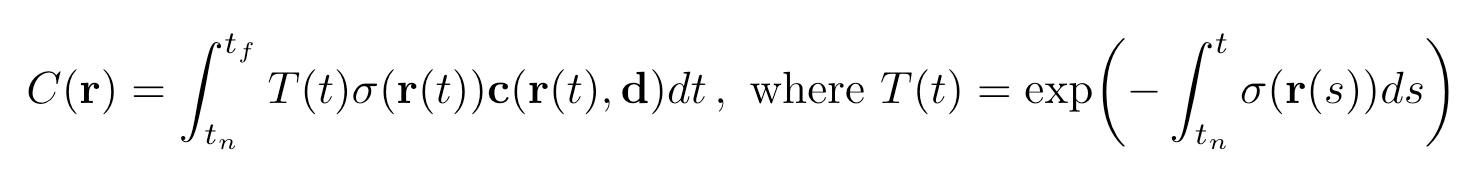
可以看出:\(\sigma(r(t))\) 说明 \(\sigma\) 只和 \(r\) 有关,而 \(c(r(t),d)\) 说明 \(c\) 和 \(r,d\) 都有关,也就是说想要学习的是不同视角下的不同颜色,包含了 reflection 等效应;但 \(\sigma\) 代表材质,代表某个位置的物理材质吸收光线的能力,所以只和三维点坐标有关。
\(T(t)\) 是从 \(t_n\) 到 \(t\) 的体密度求和后取负再取 \(\exp\),可以类比为光强的概念。光强越强、且该点 \(\sigma\) 值越大,则该点对像素颜色的贡献越大。
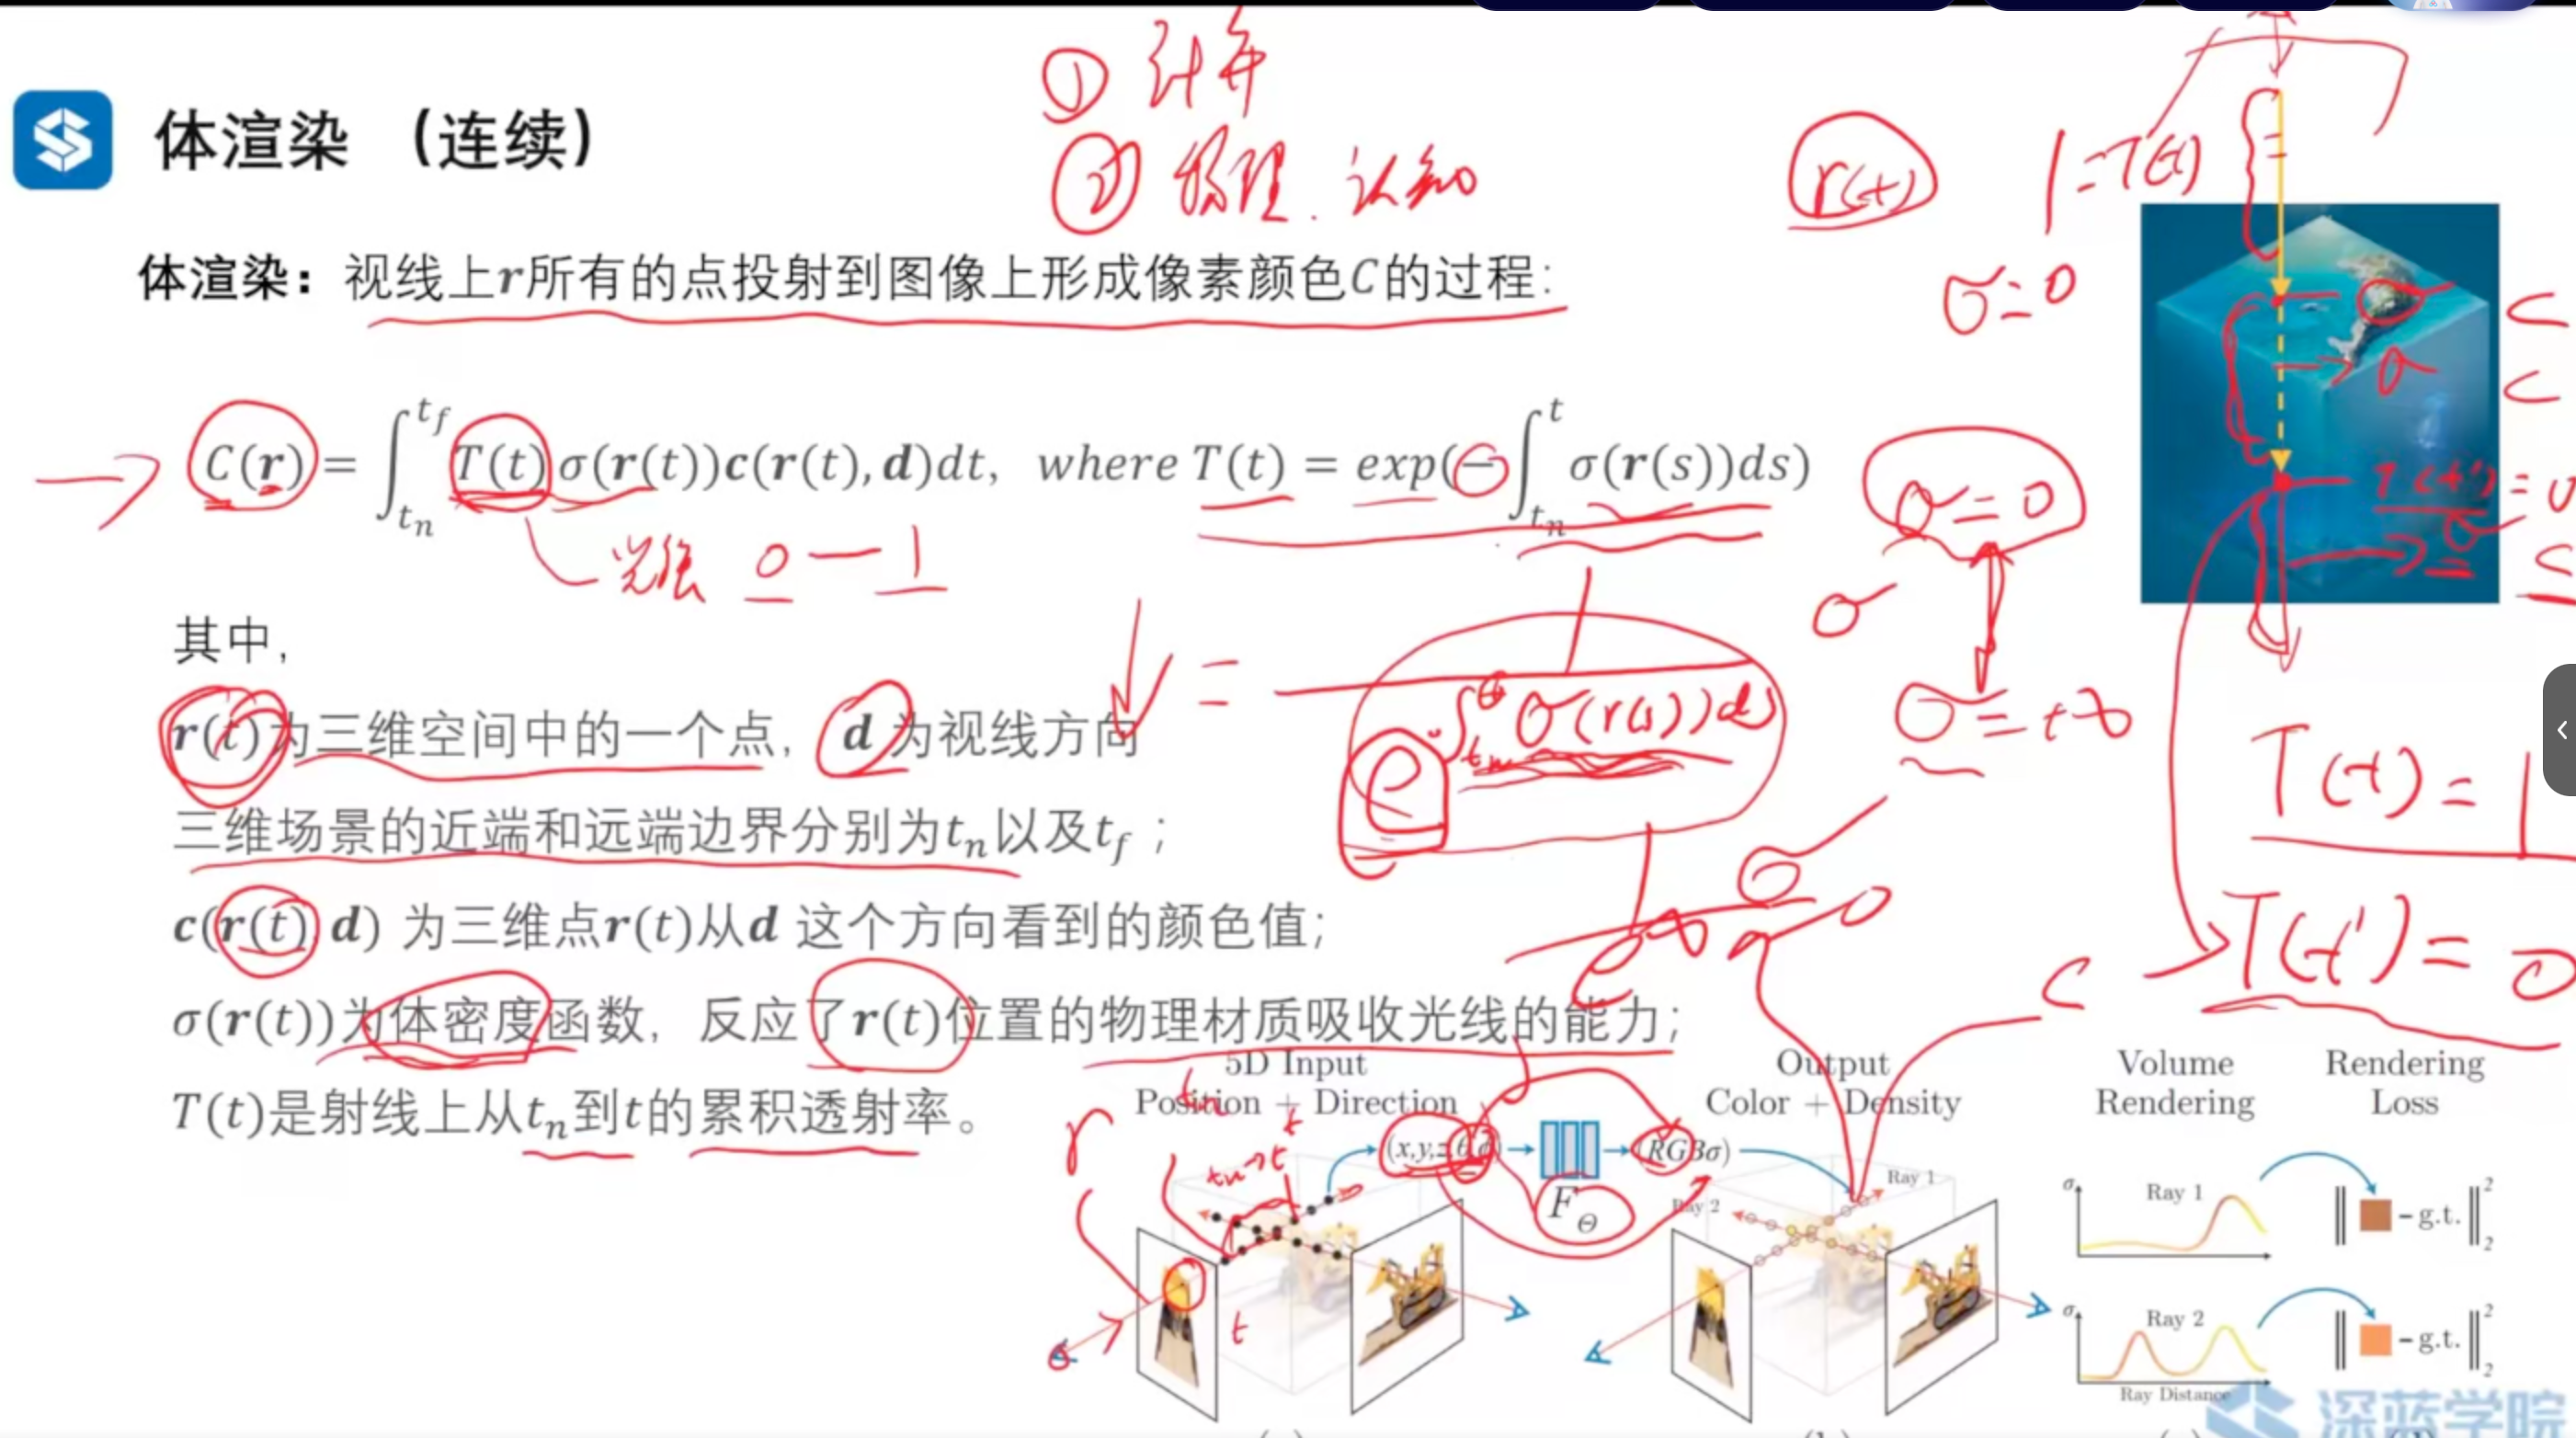
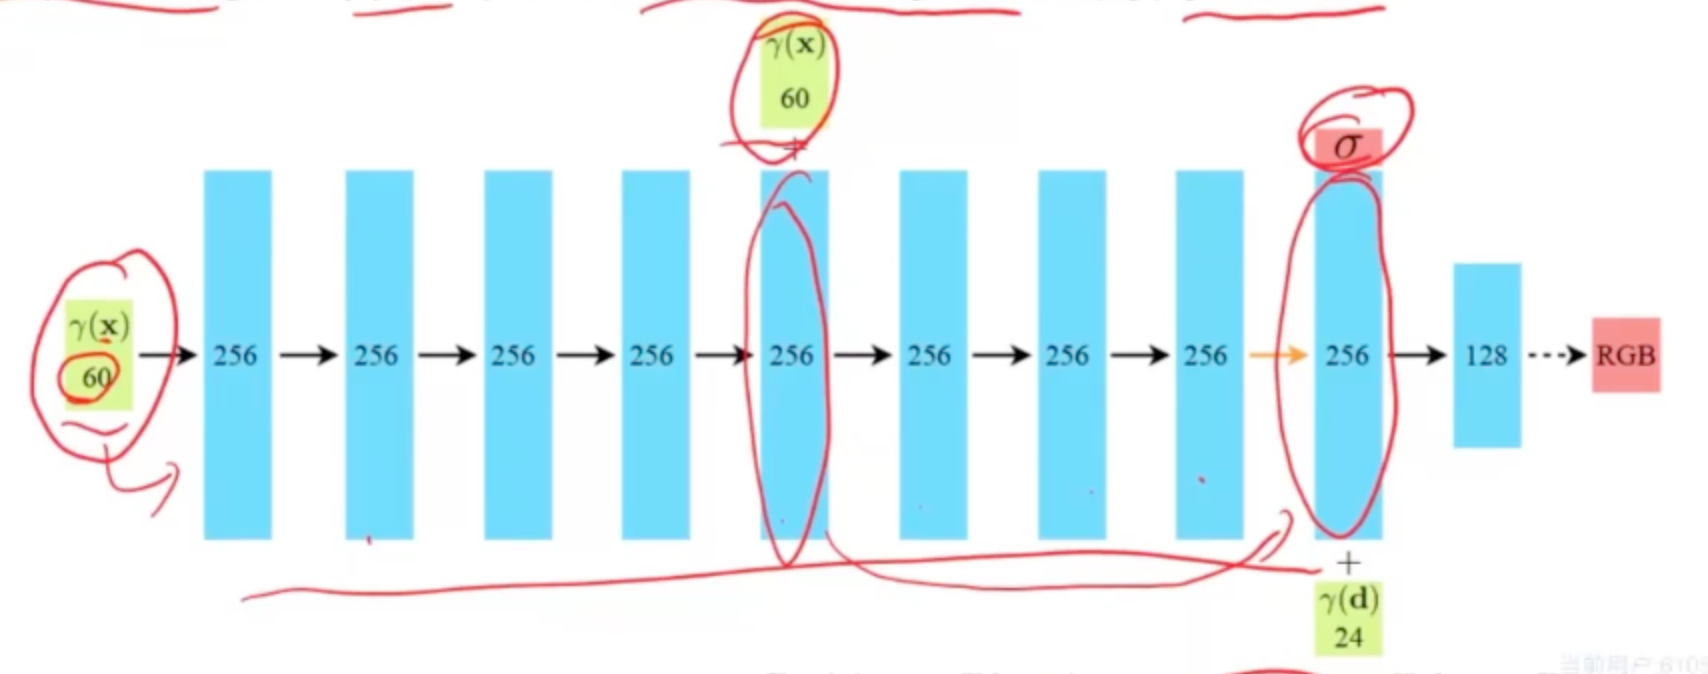
从这张图也可以看出,\(\sigma\) 的值只跟位置有关,跟方向无关。
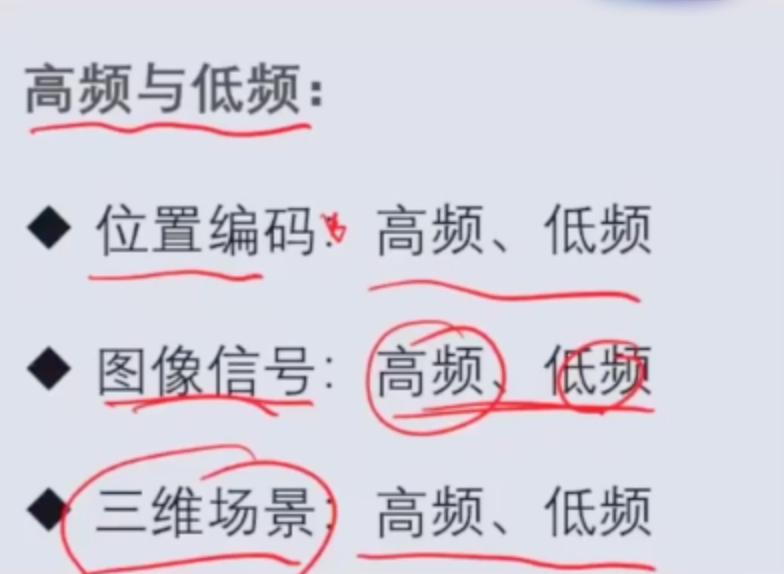
位置编码与高低频
- 位置编码高低频
- 图像信号高低频:导致纹理细节丢失
- 高频:颜色变化的地方
- 低频:颜色几乎不变的地方
- 三维场景高低频:导致几何细节丢失
- 高频:\(\sigma\) 变化的地方
- 低频:\(\sigma\) 几乎不变的地方
因为在样本中,平滑的样本(颜色不出现阶跃、\(\sigma\) 也不出现阶跃)占大多数,所以不加位置编码时神经网络会更倾向于学习平滑的信息,而学不到边缘之类的细节。加入位置编码升维之后,前面的维度上两点之间的差距仍然很小,但后面的维度上两点之间的差距会被放大,从而让神经网络自己决定关注哪一部分。
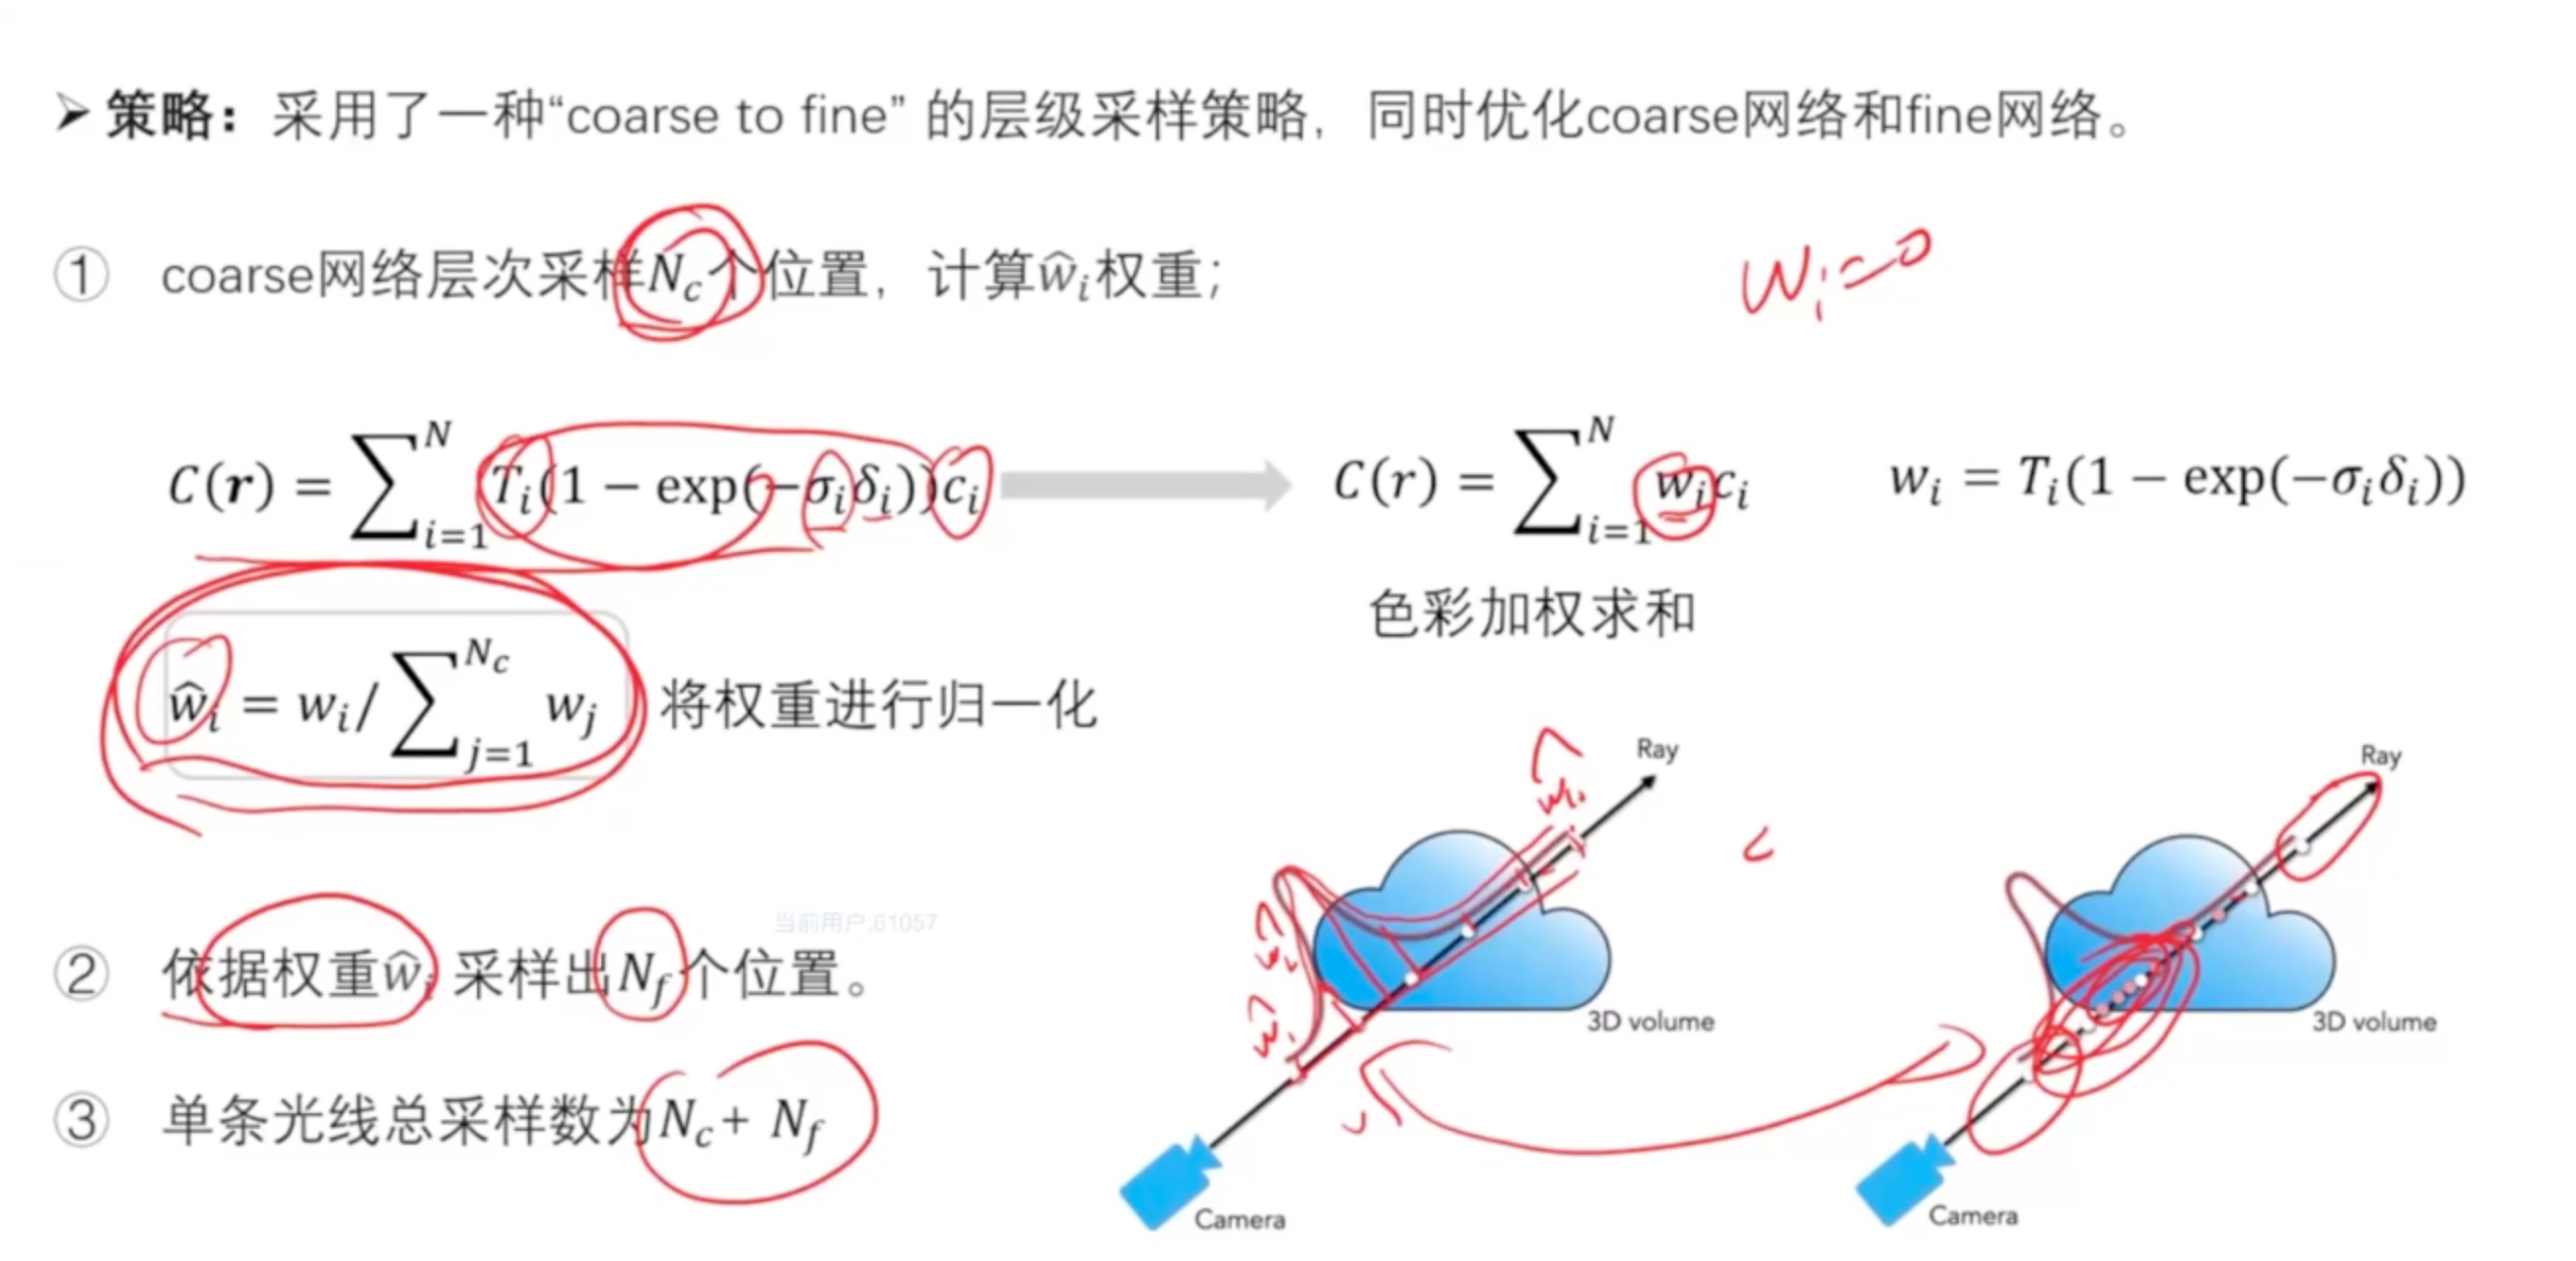
coarse-to-fine:

Mip-NeRF
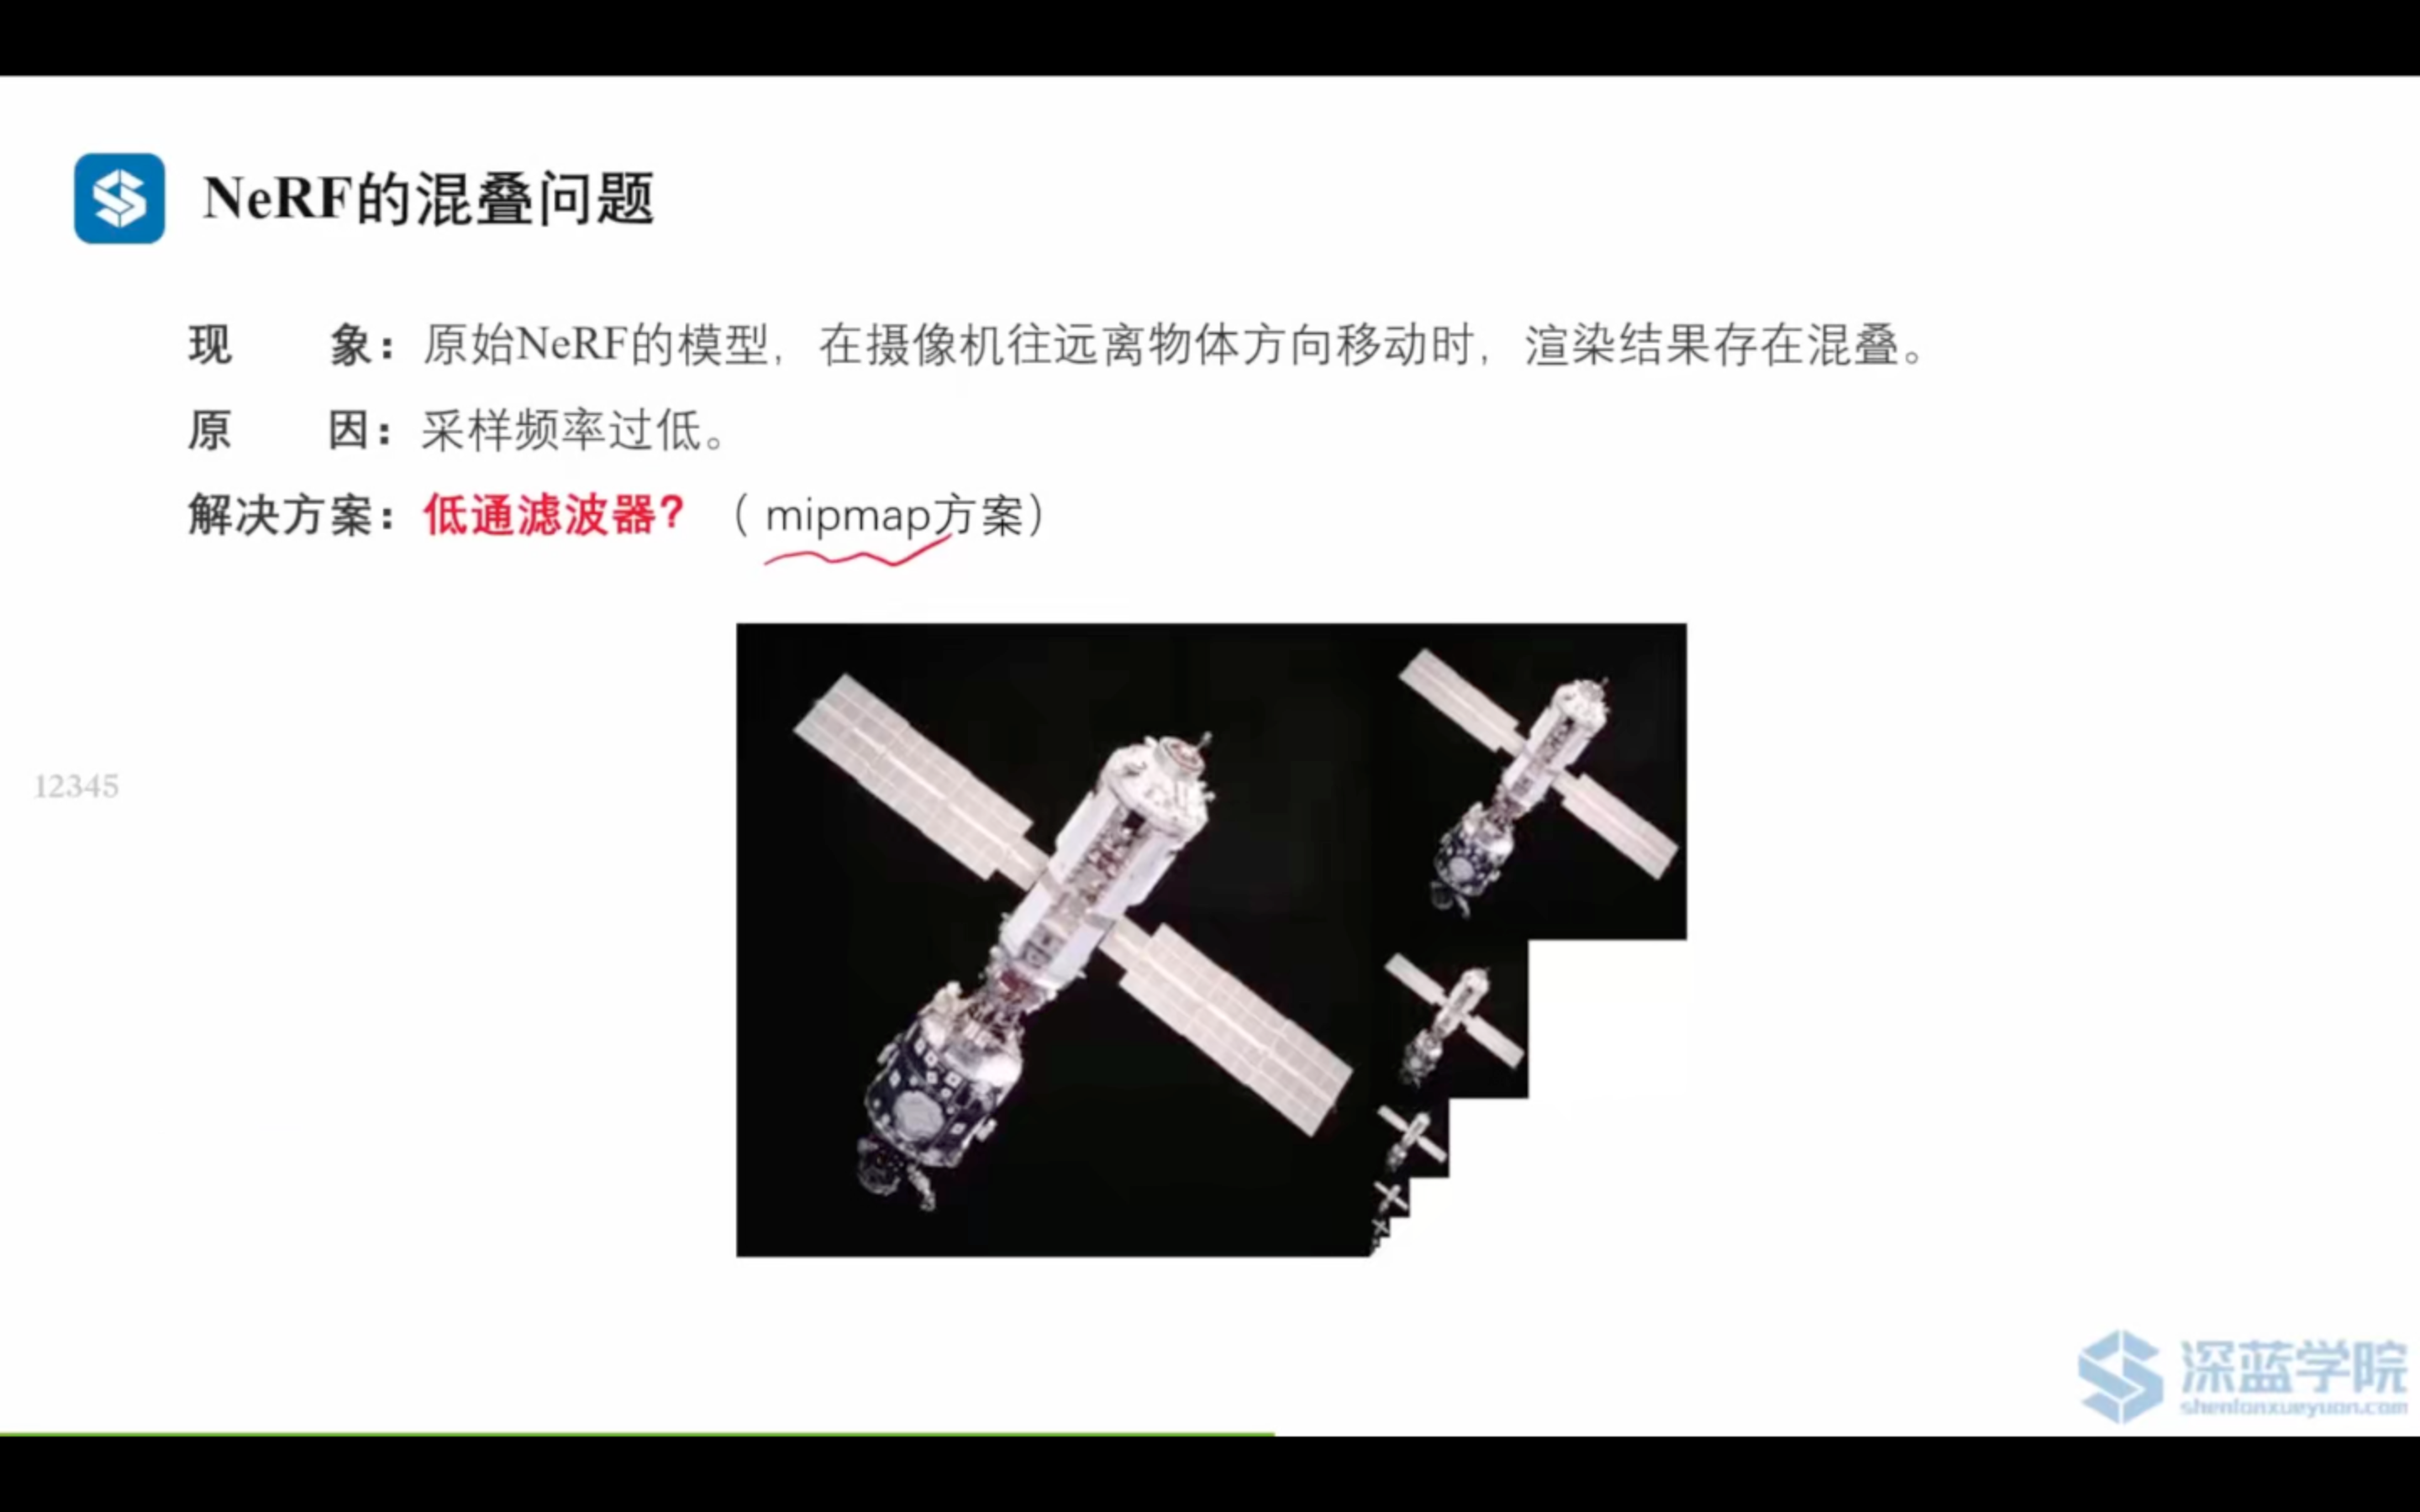
Blur 是一种特定的 Filter;在远处细节密集的场景中进行超采样,可能更有助于减少摩尔纹效应。
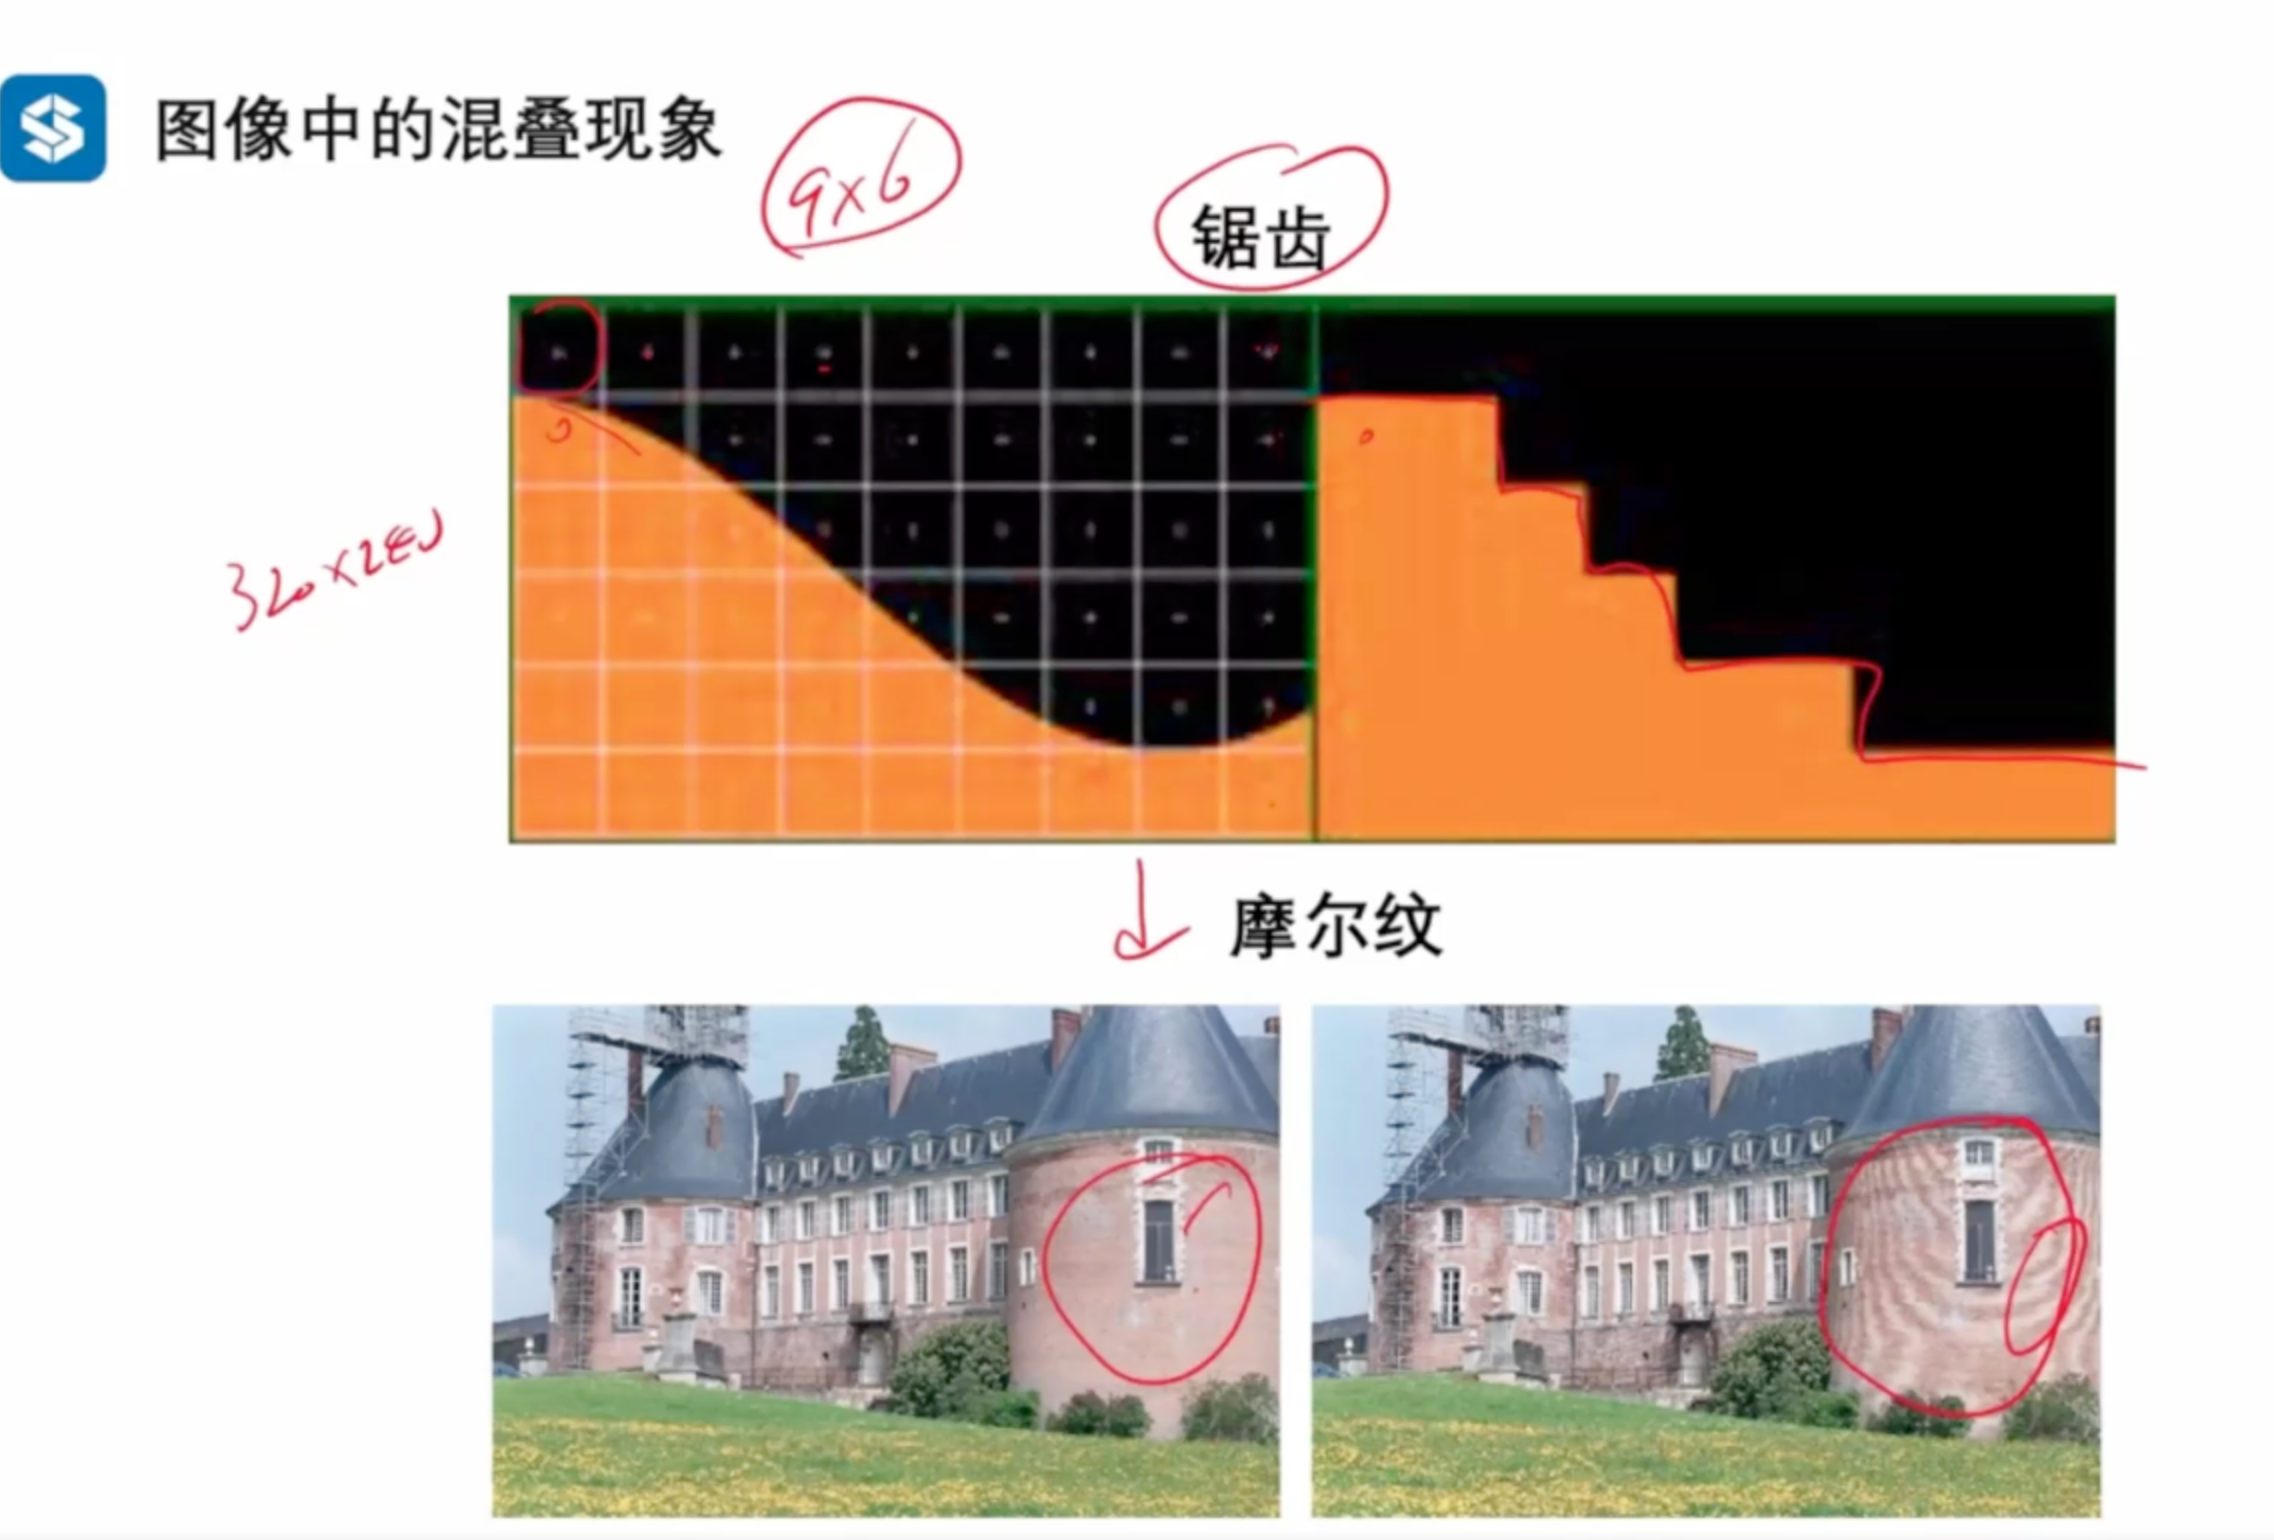
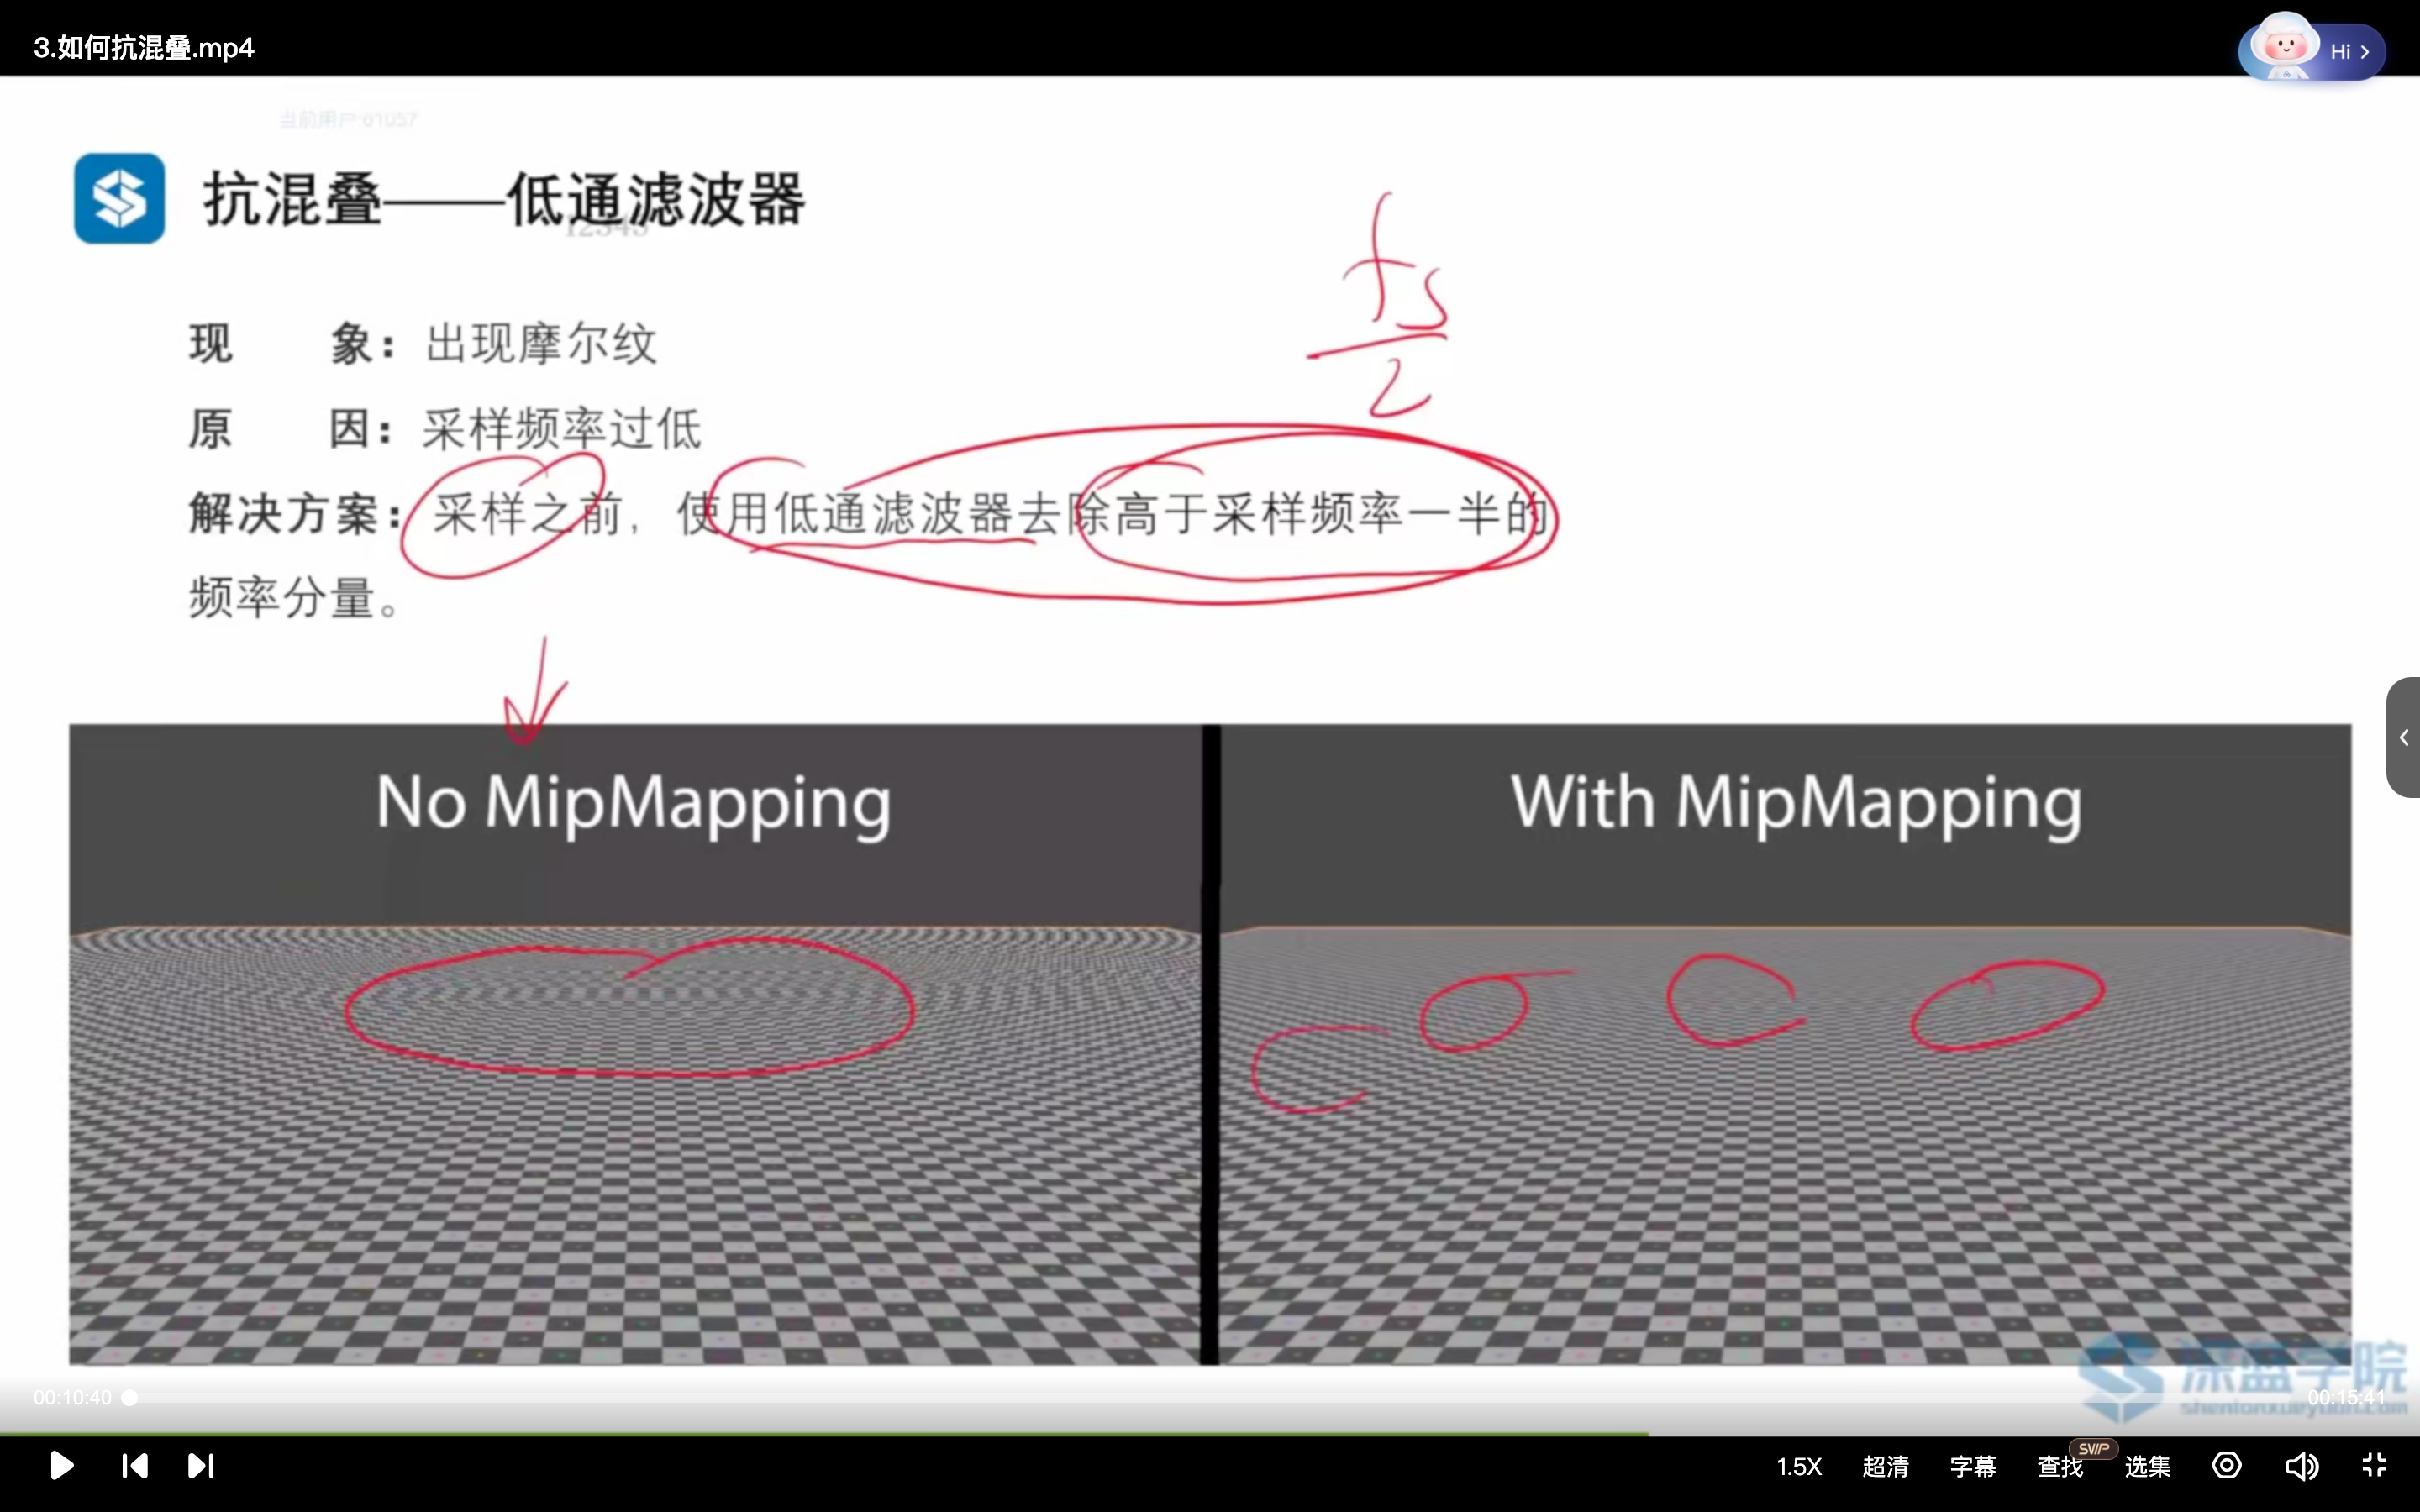
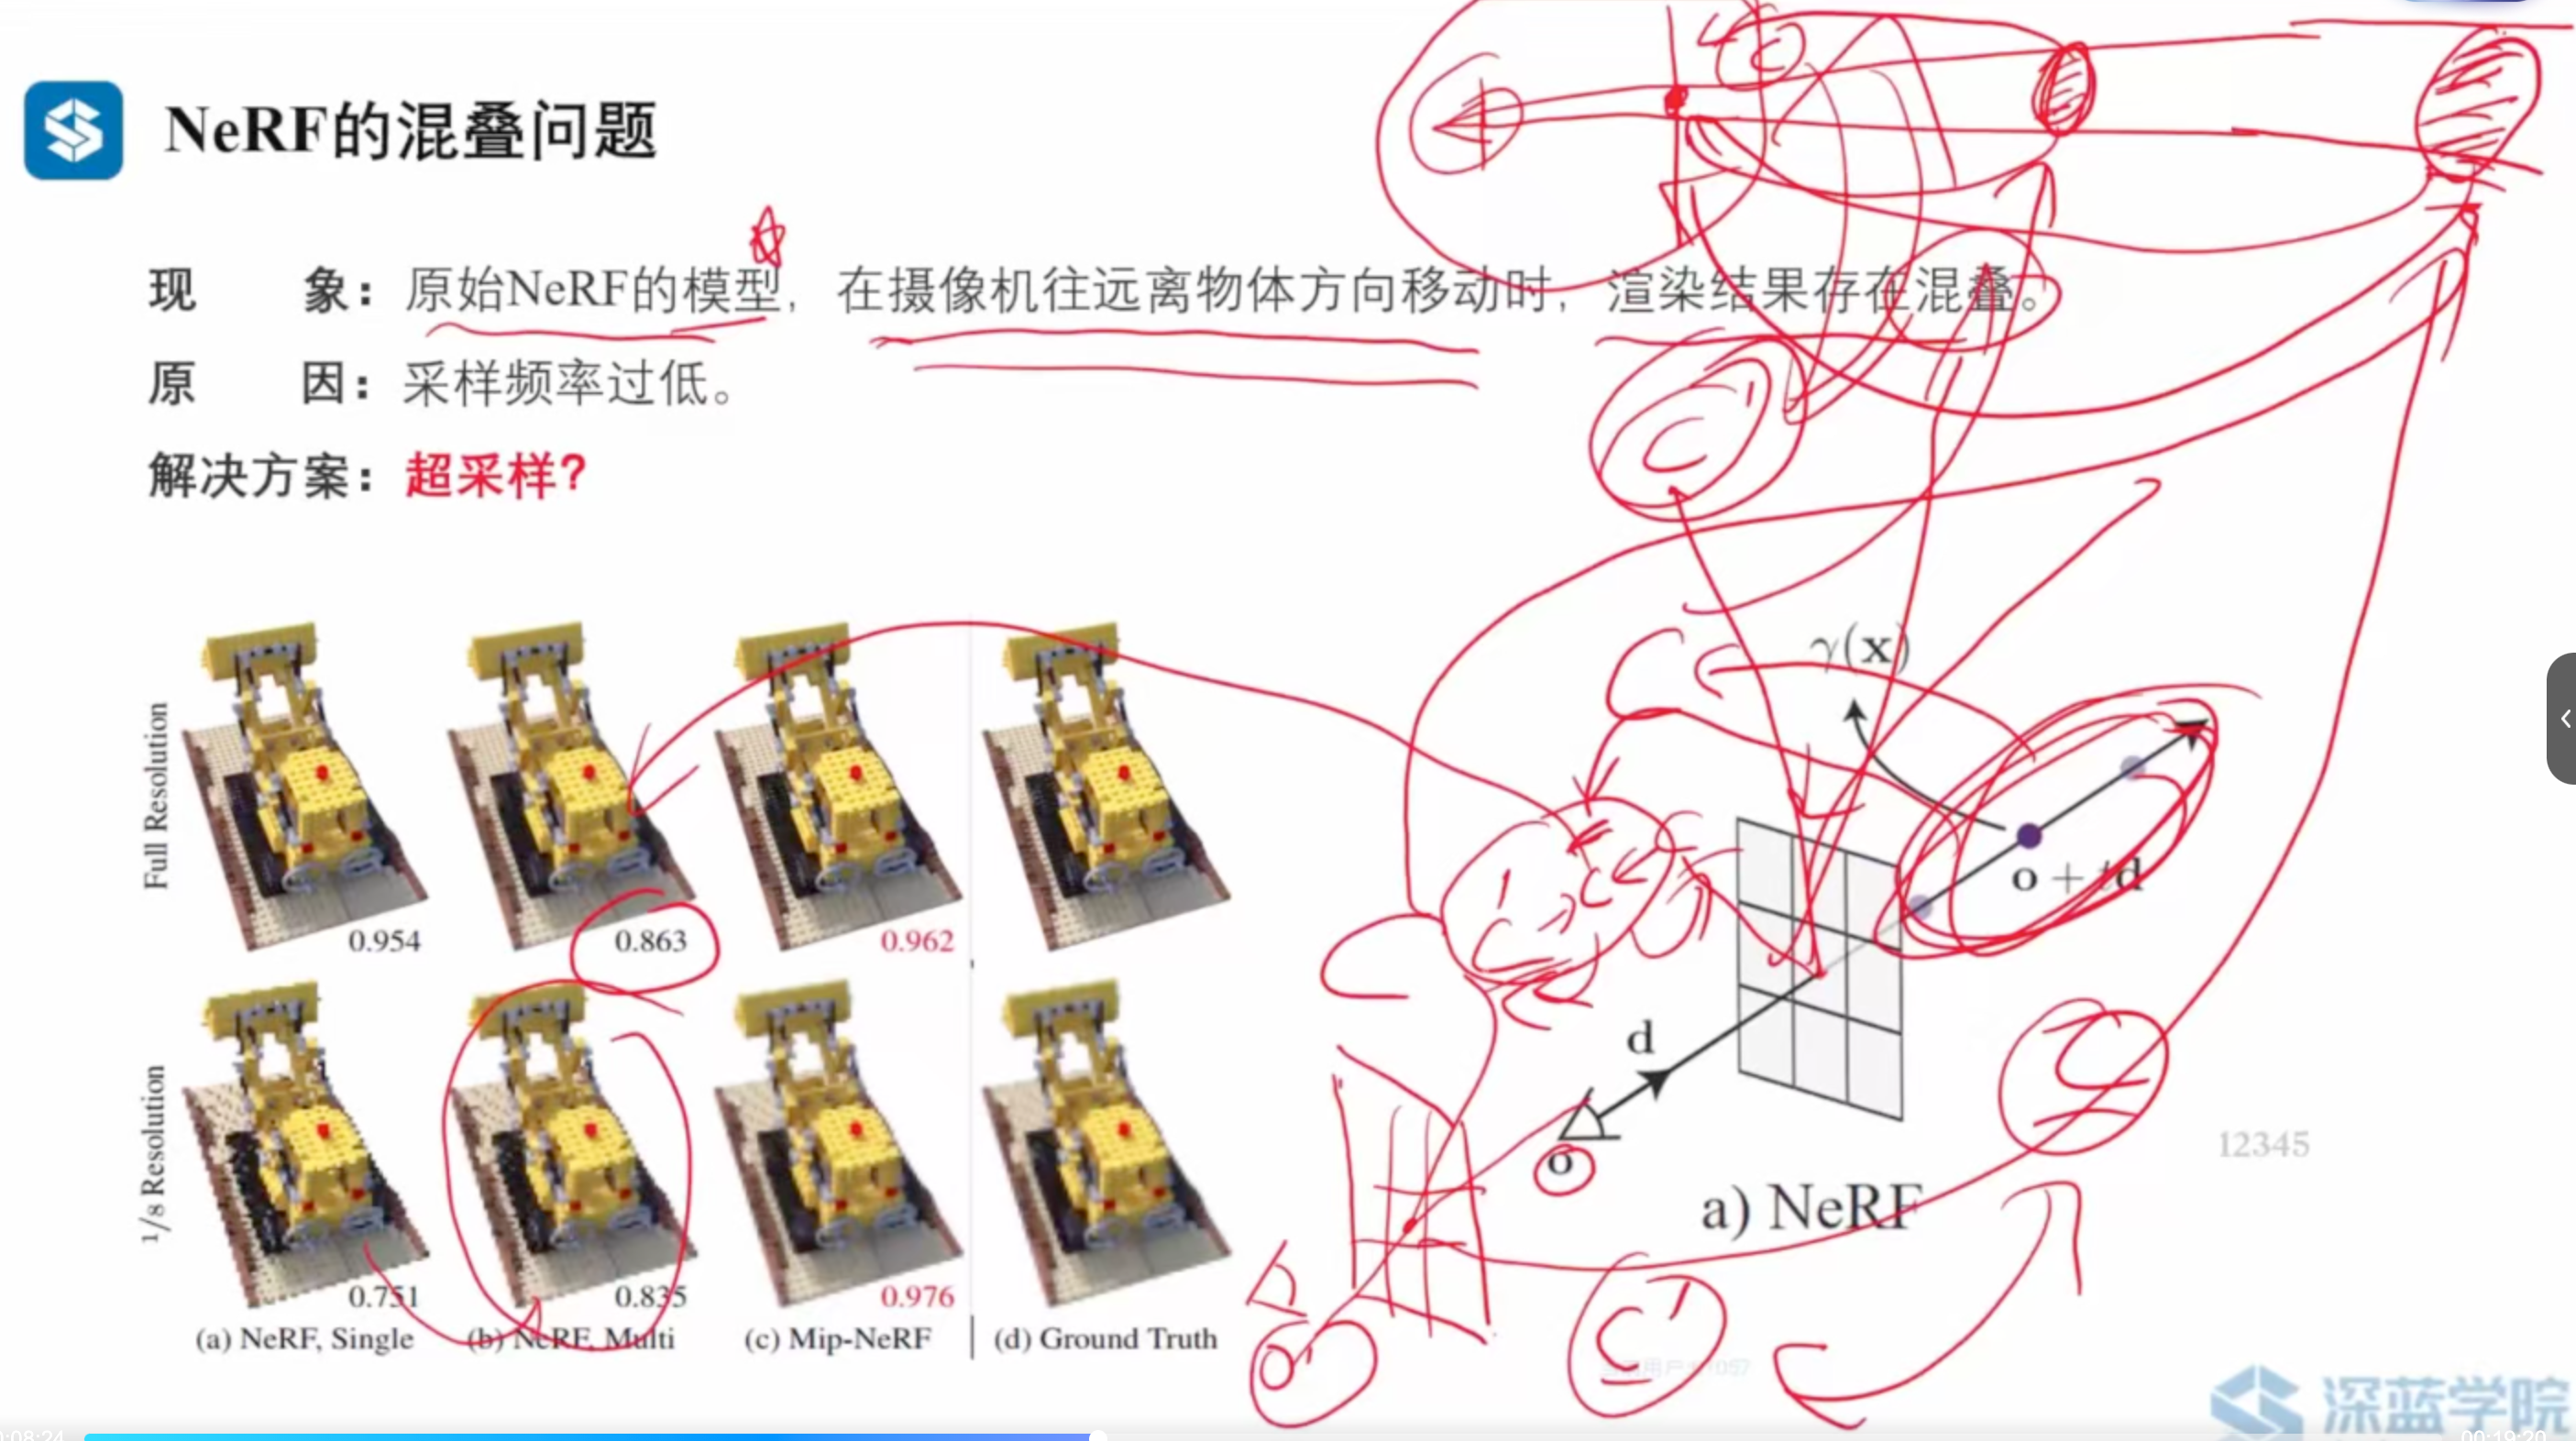
为什么增加不同分辨率的图片不能解决走样问题:
因为这样只会让网络学到一个 \(\bar{c}\),让它同时接近 \(c'\) 和 \(c\)。对于近距离的值会降低(因为考虑到了远距离的值),对于远距离的值会上升,但总体效果依然不会提升。
用超采样也不行,因为本来已经很慢了,如果对每个像素点采样多条光线,速度会更慢。
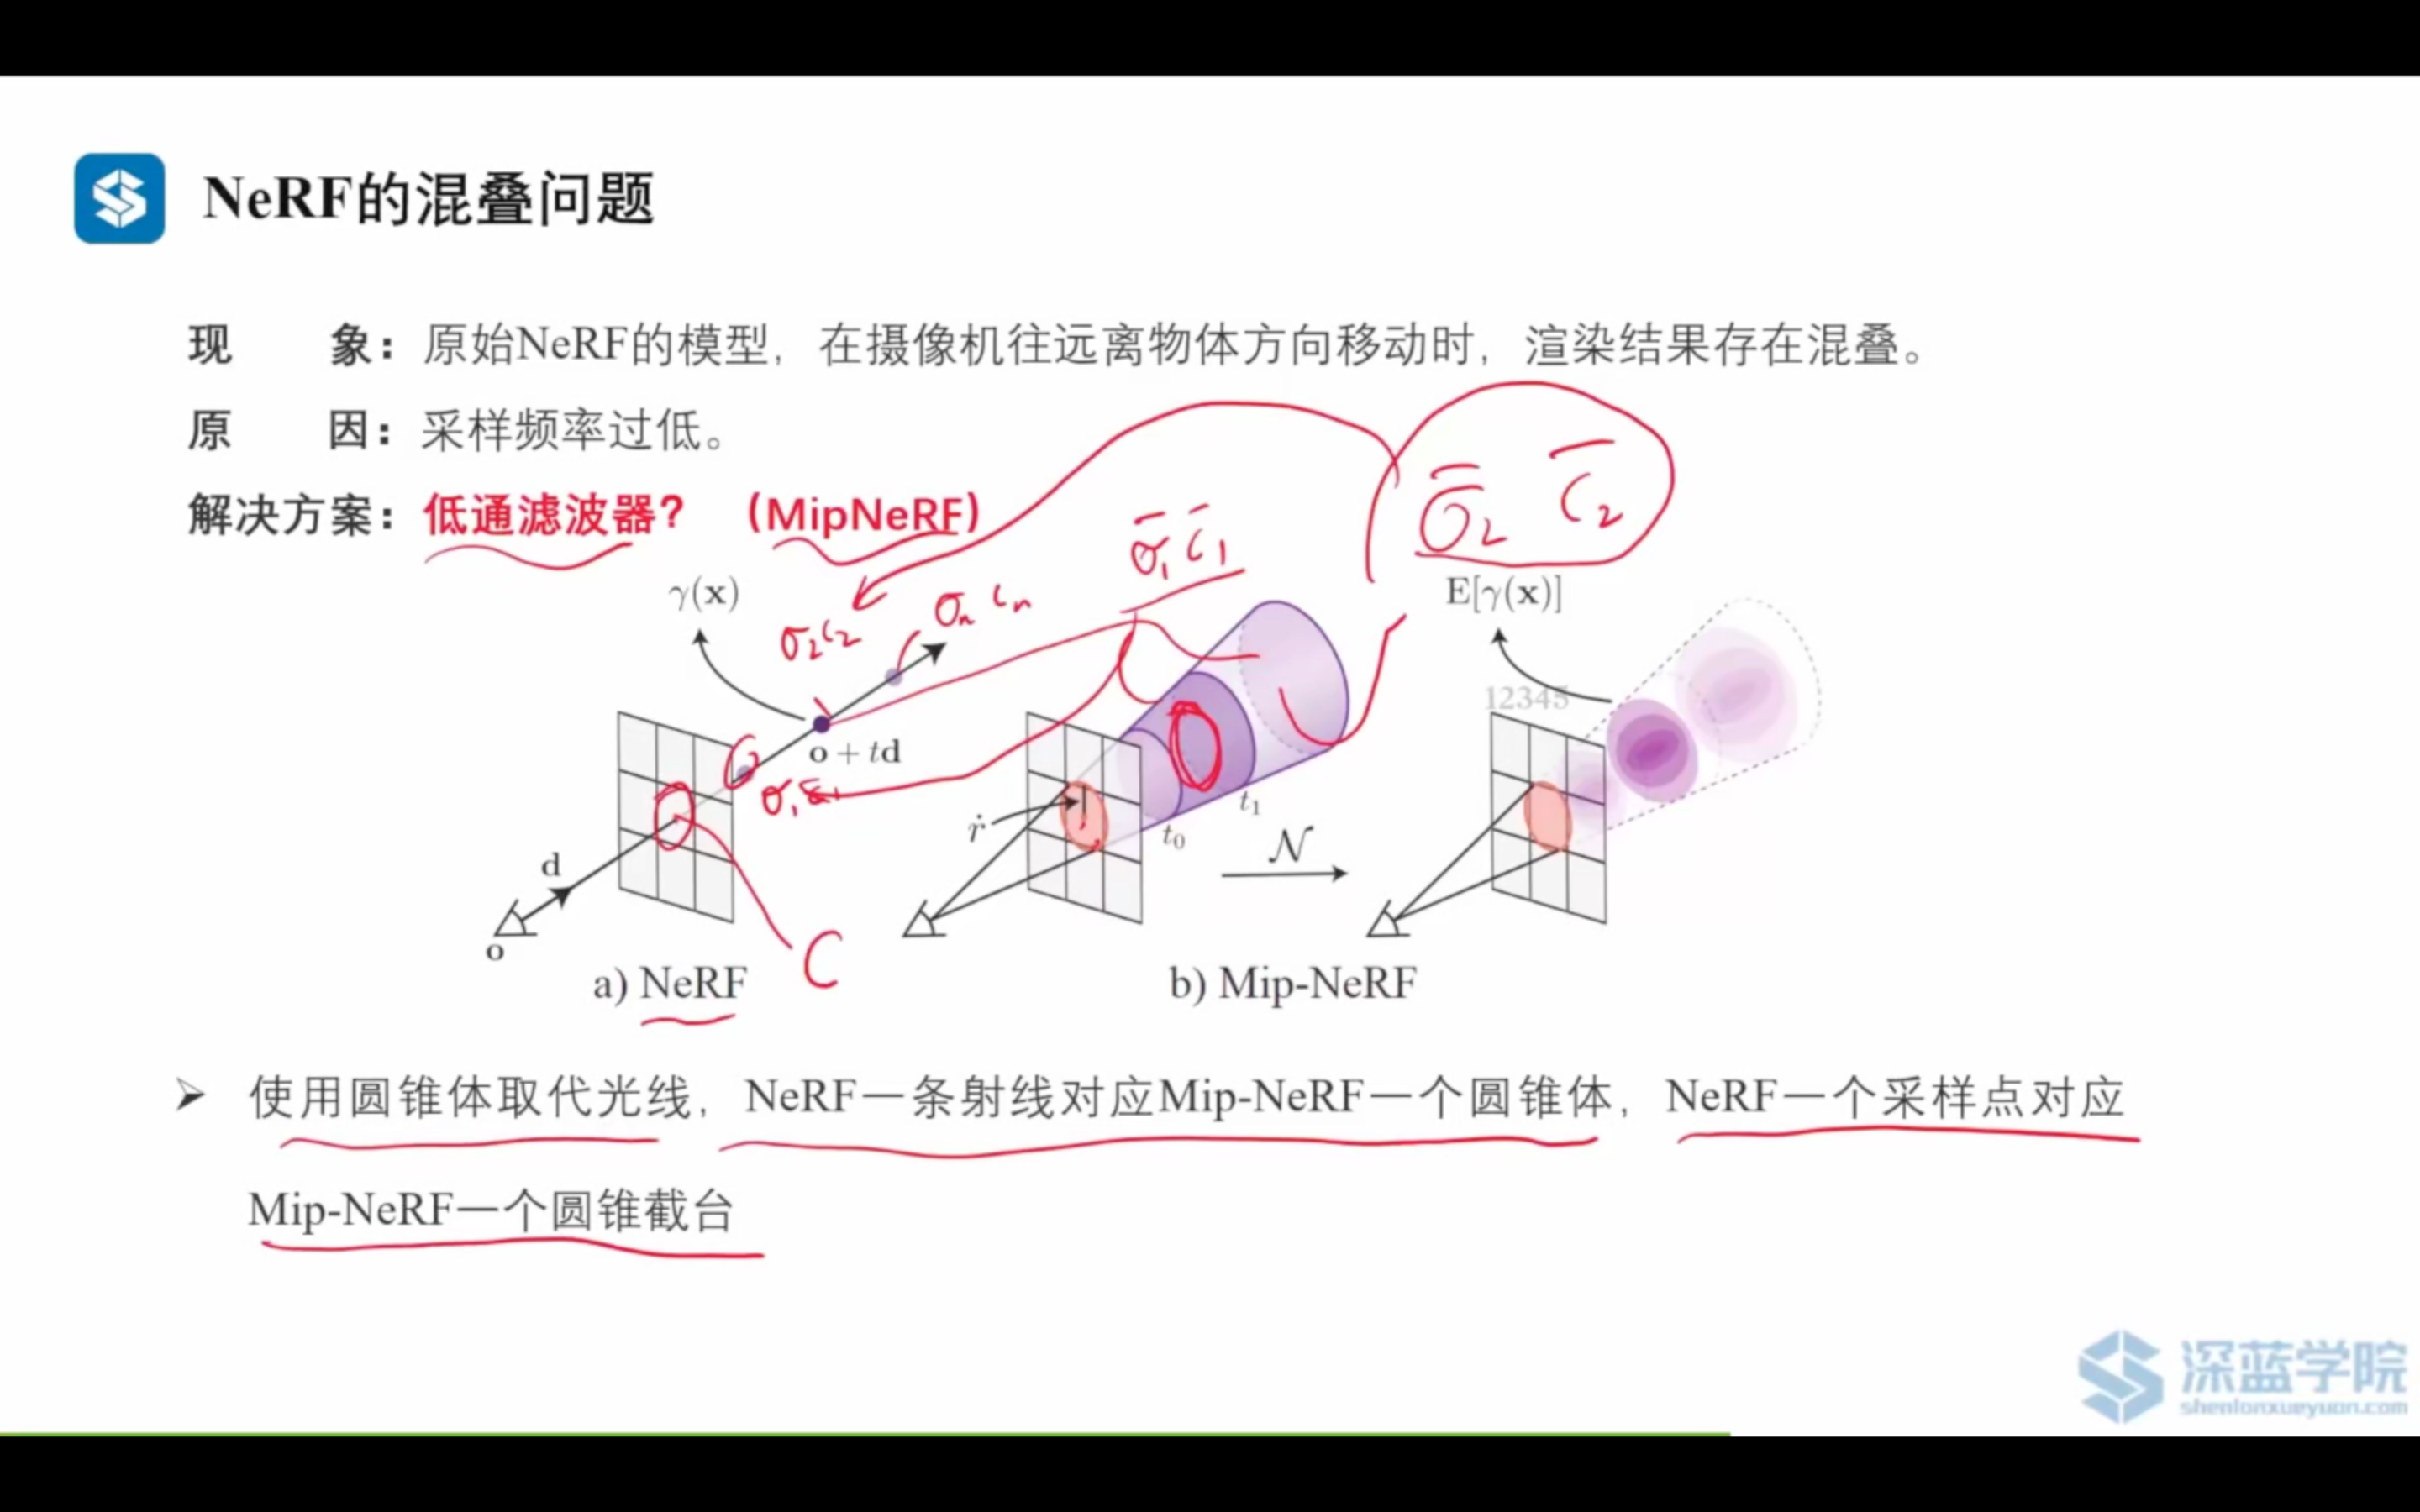
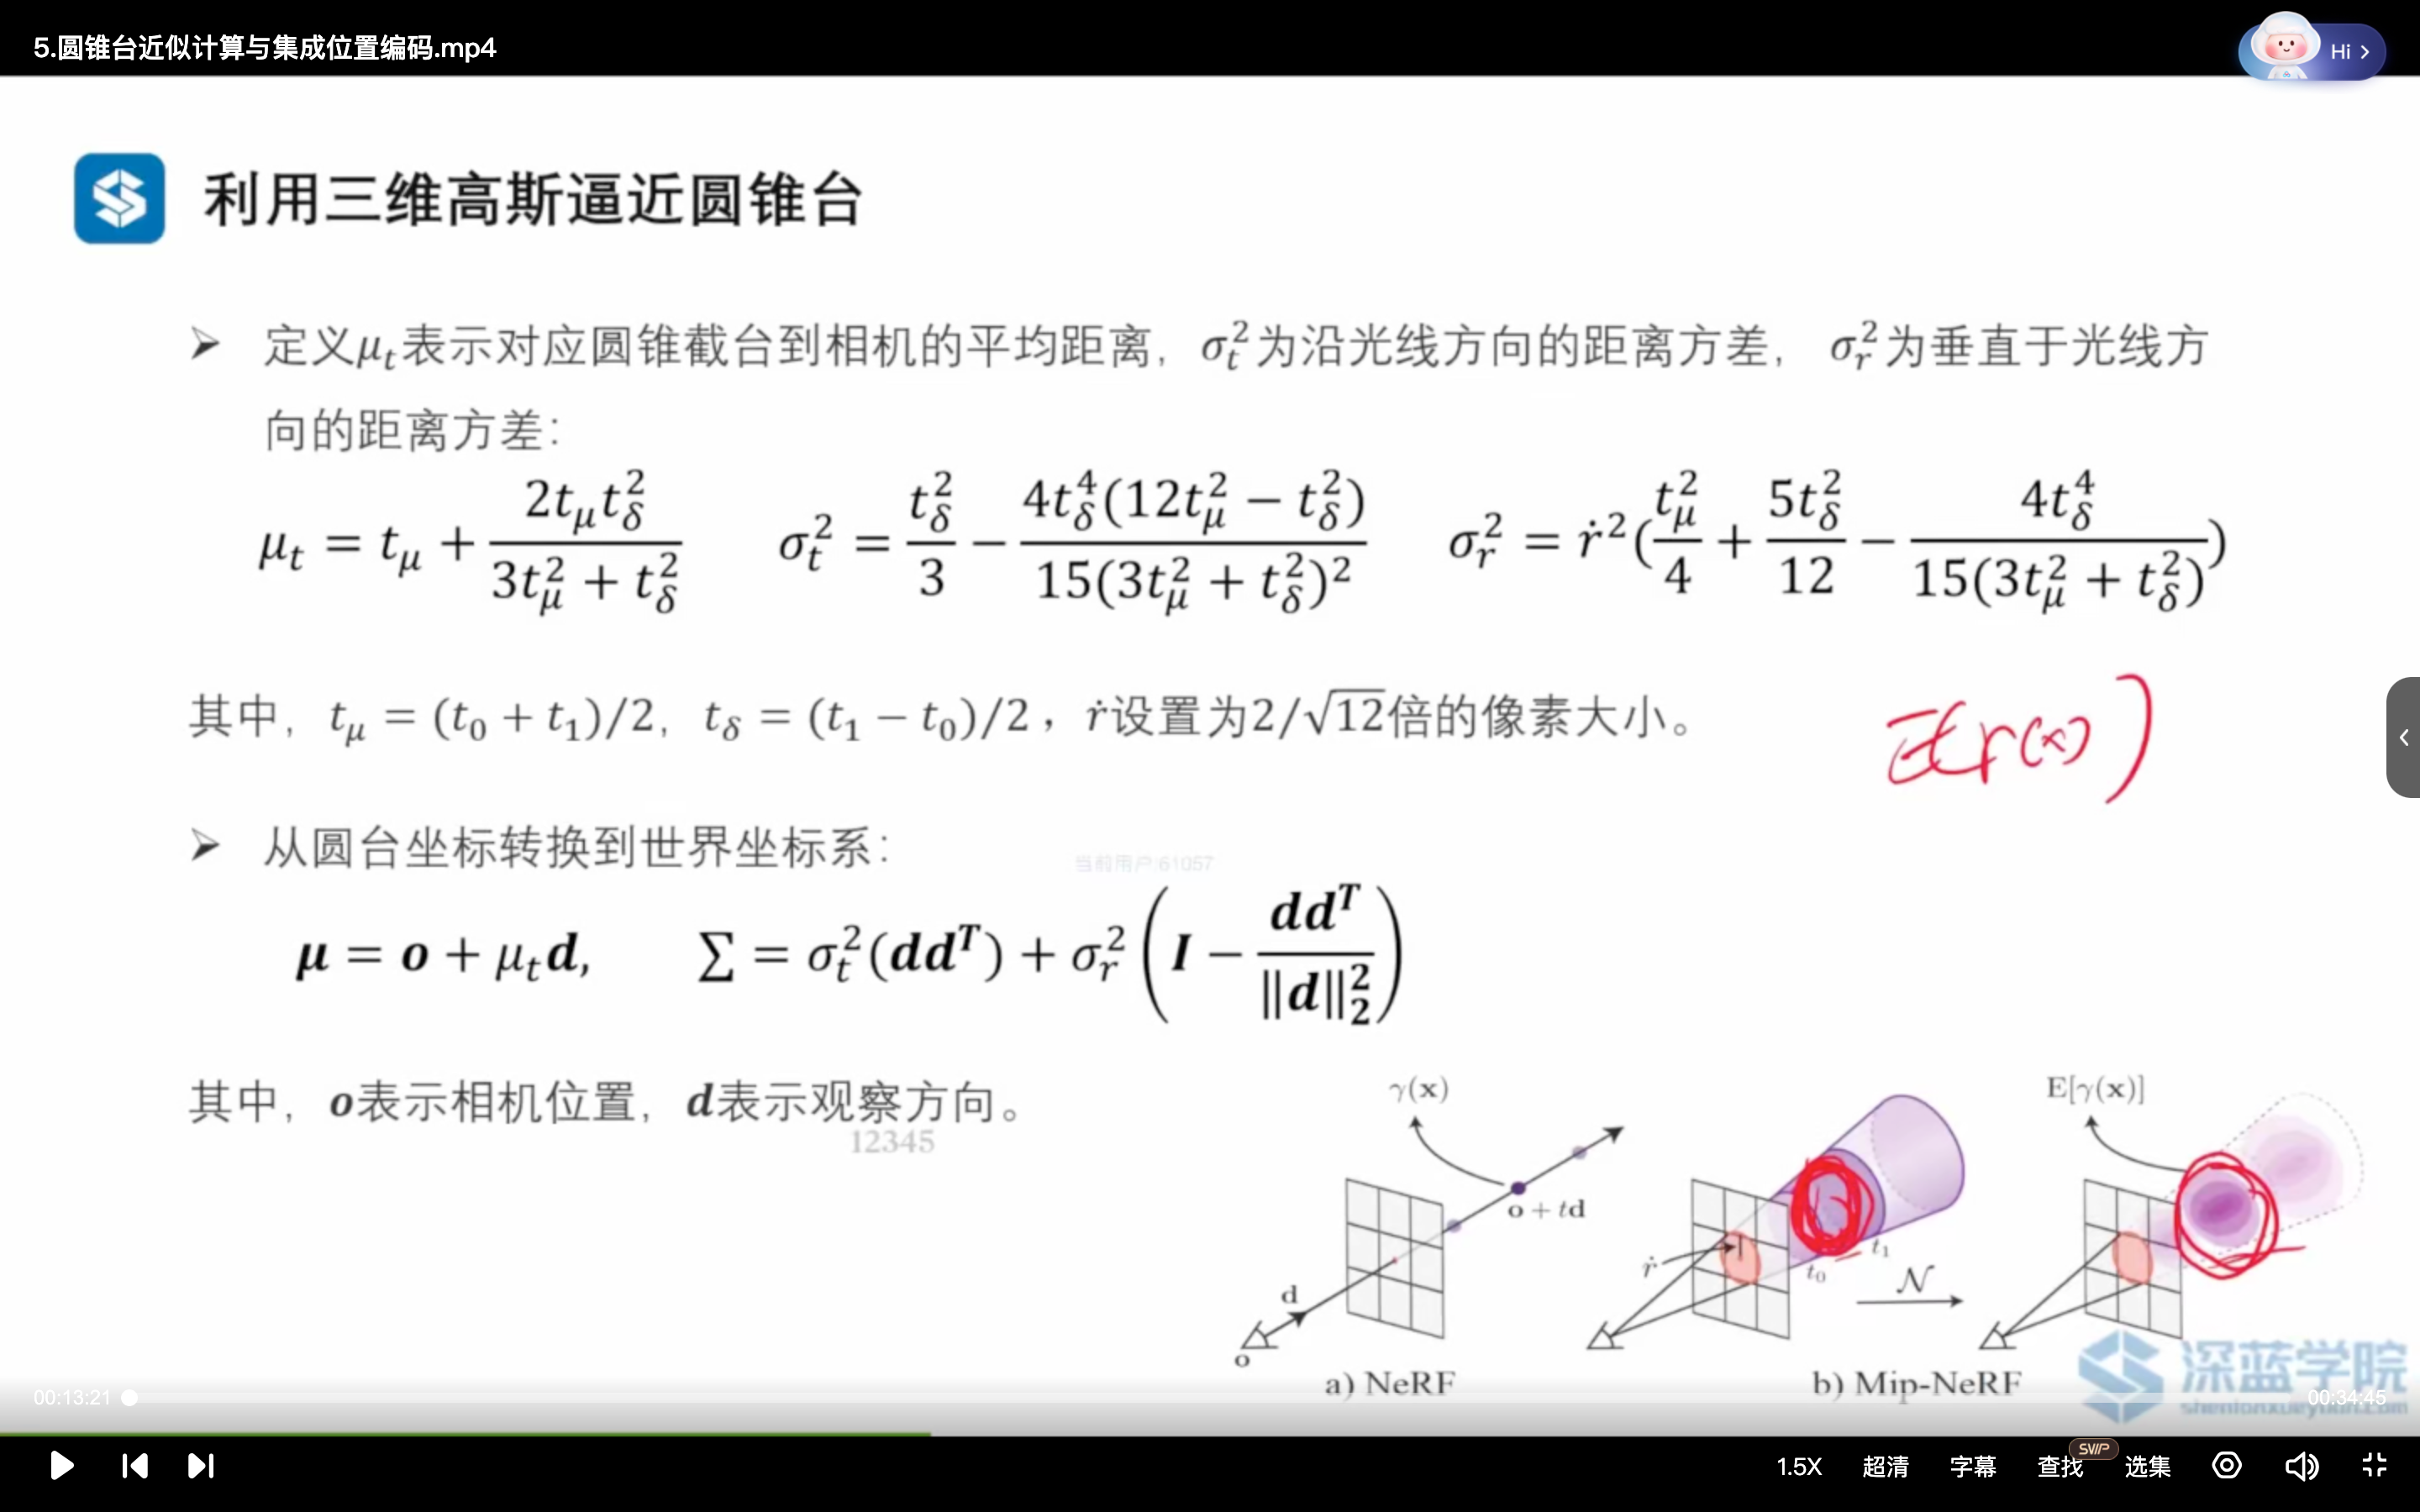
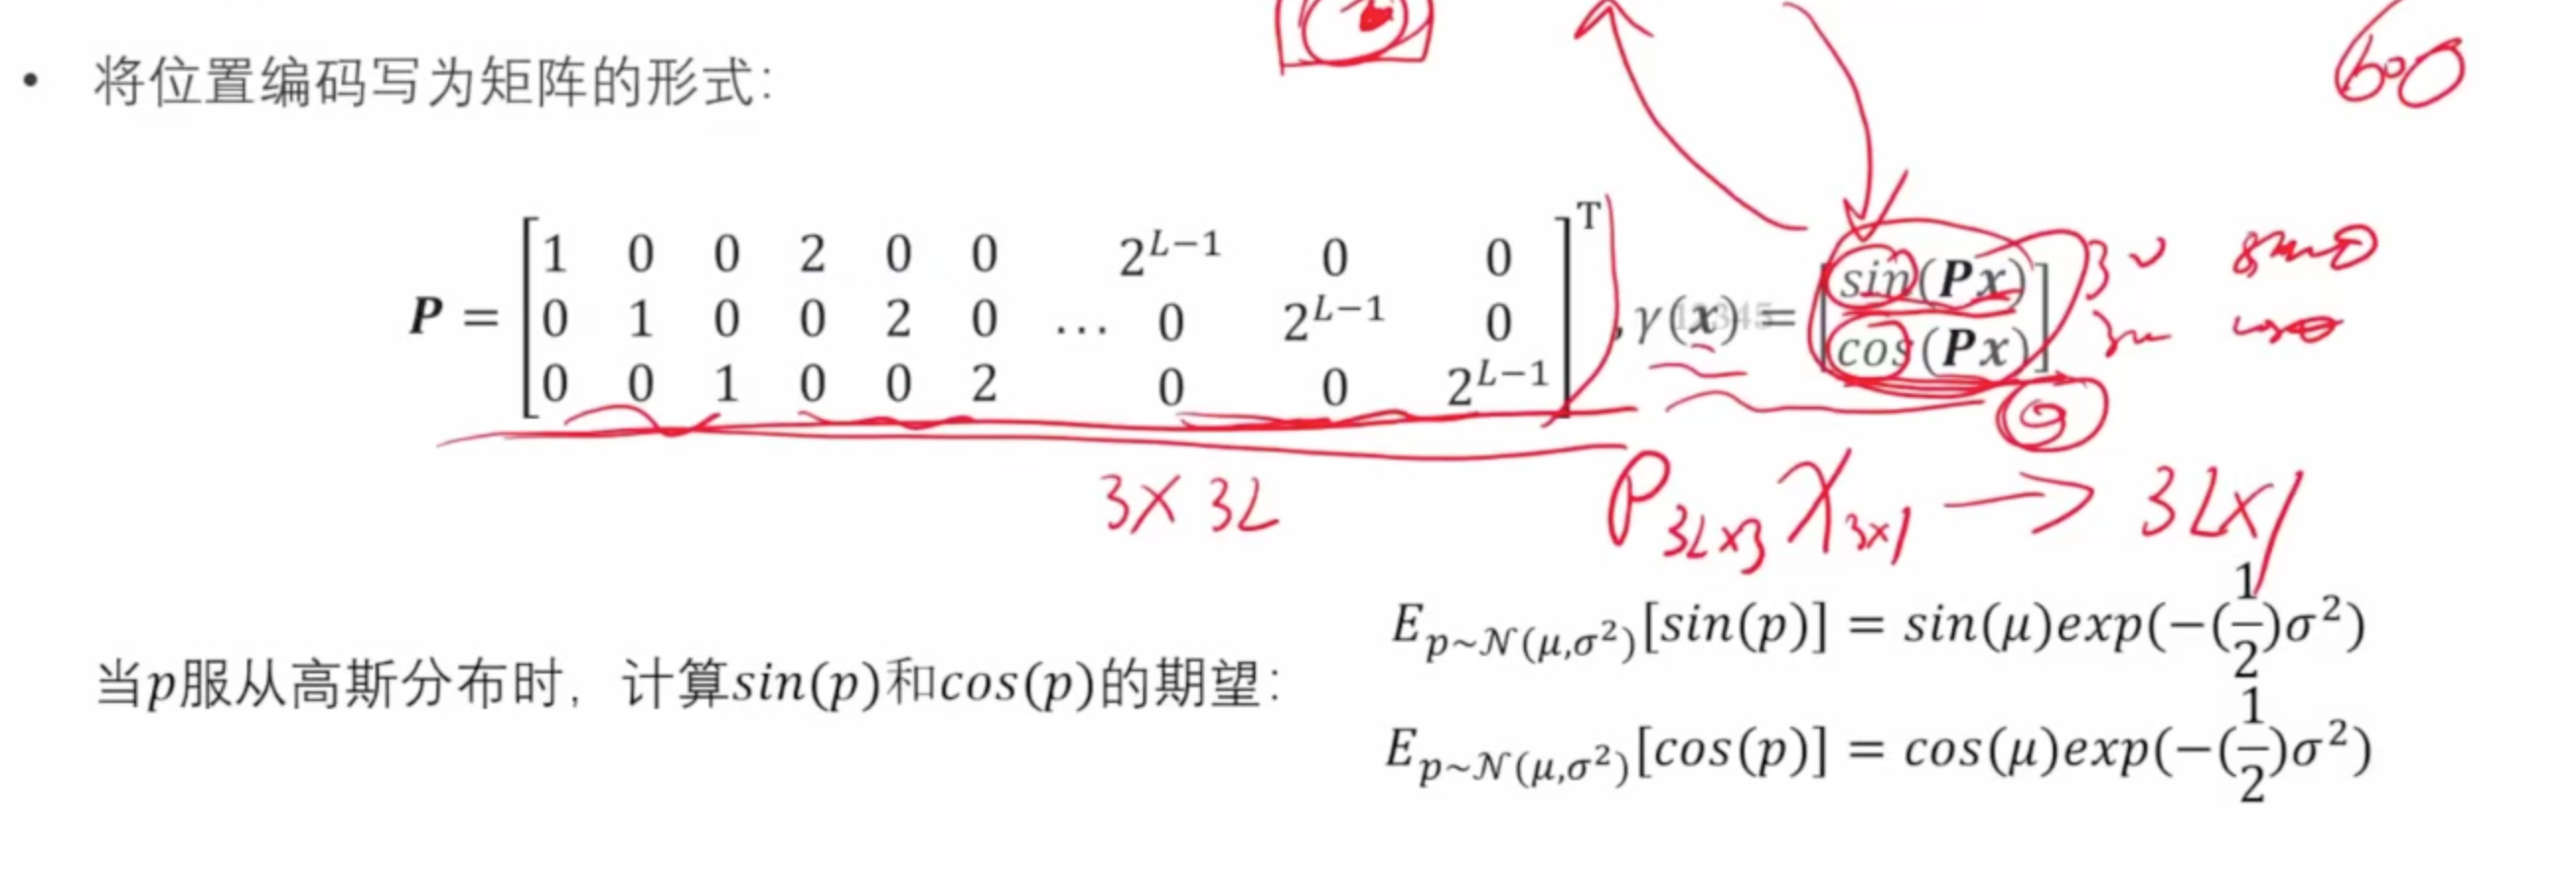
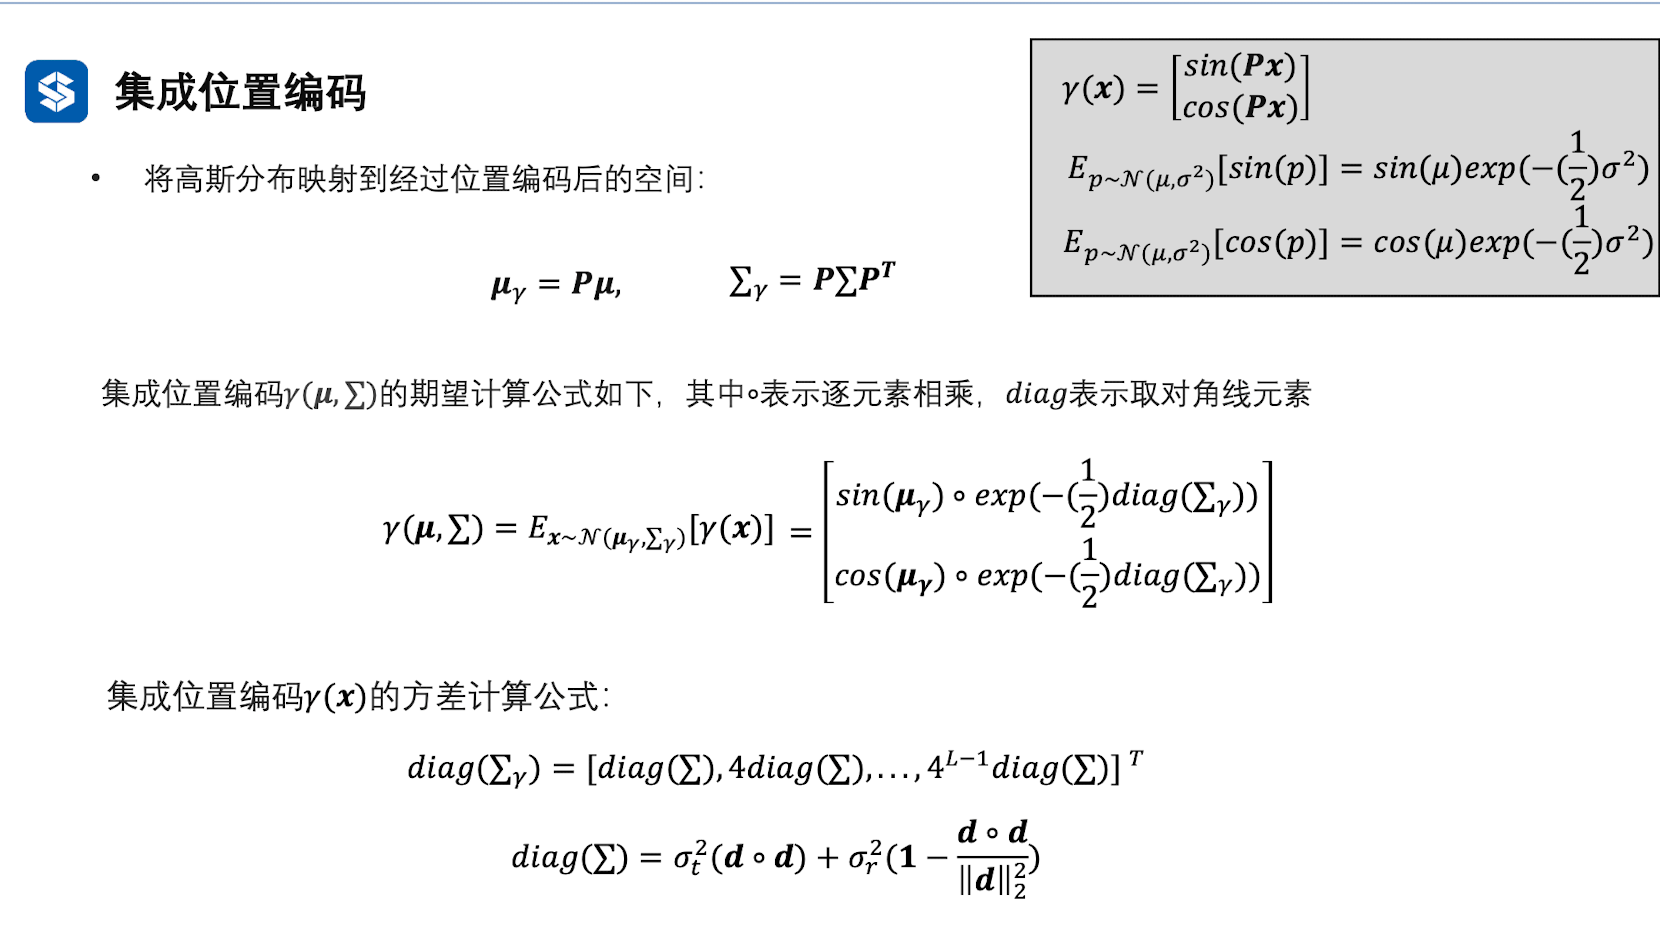
Mip-NeRF 是对所有的 \(\gamma(x)\) 做平均,而不是对 \(x\) 做平均,也就是对位置编码后的光锥进行采样。
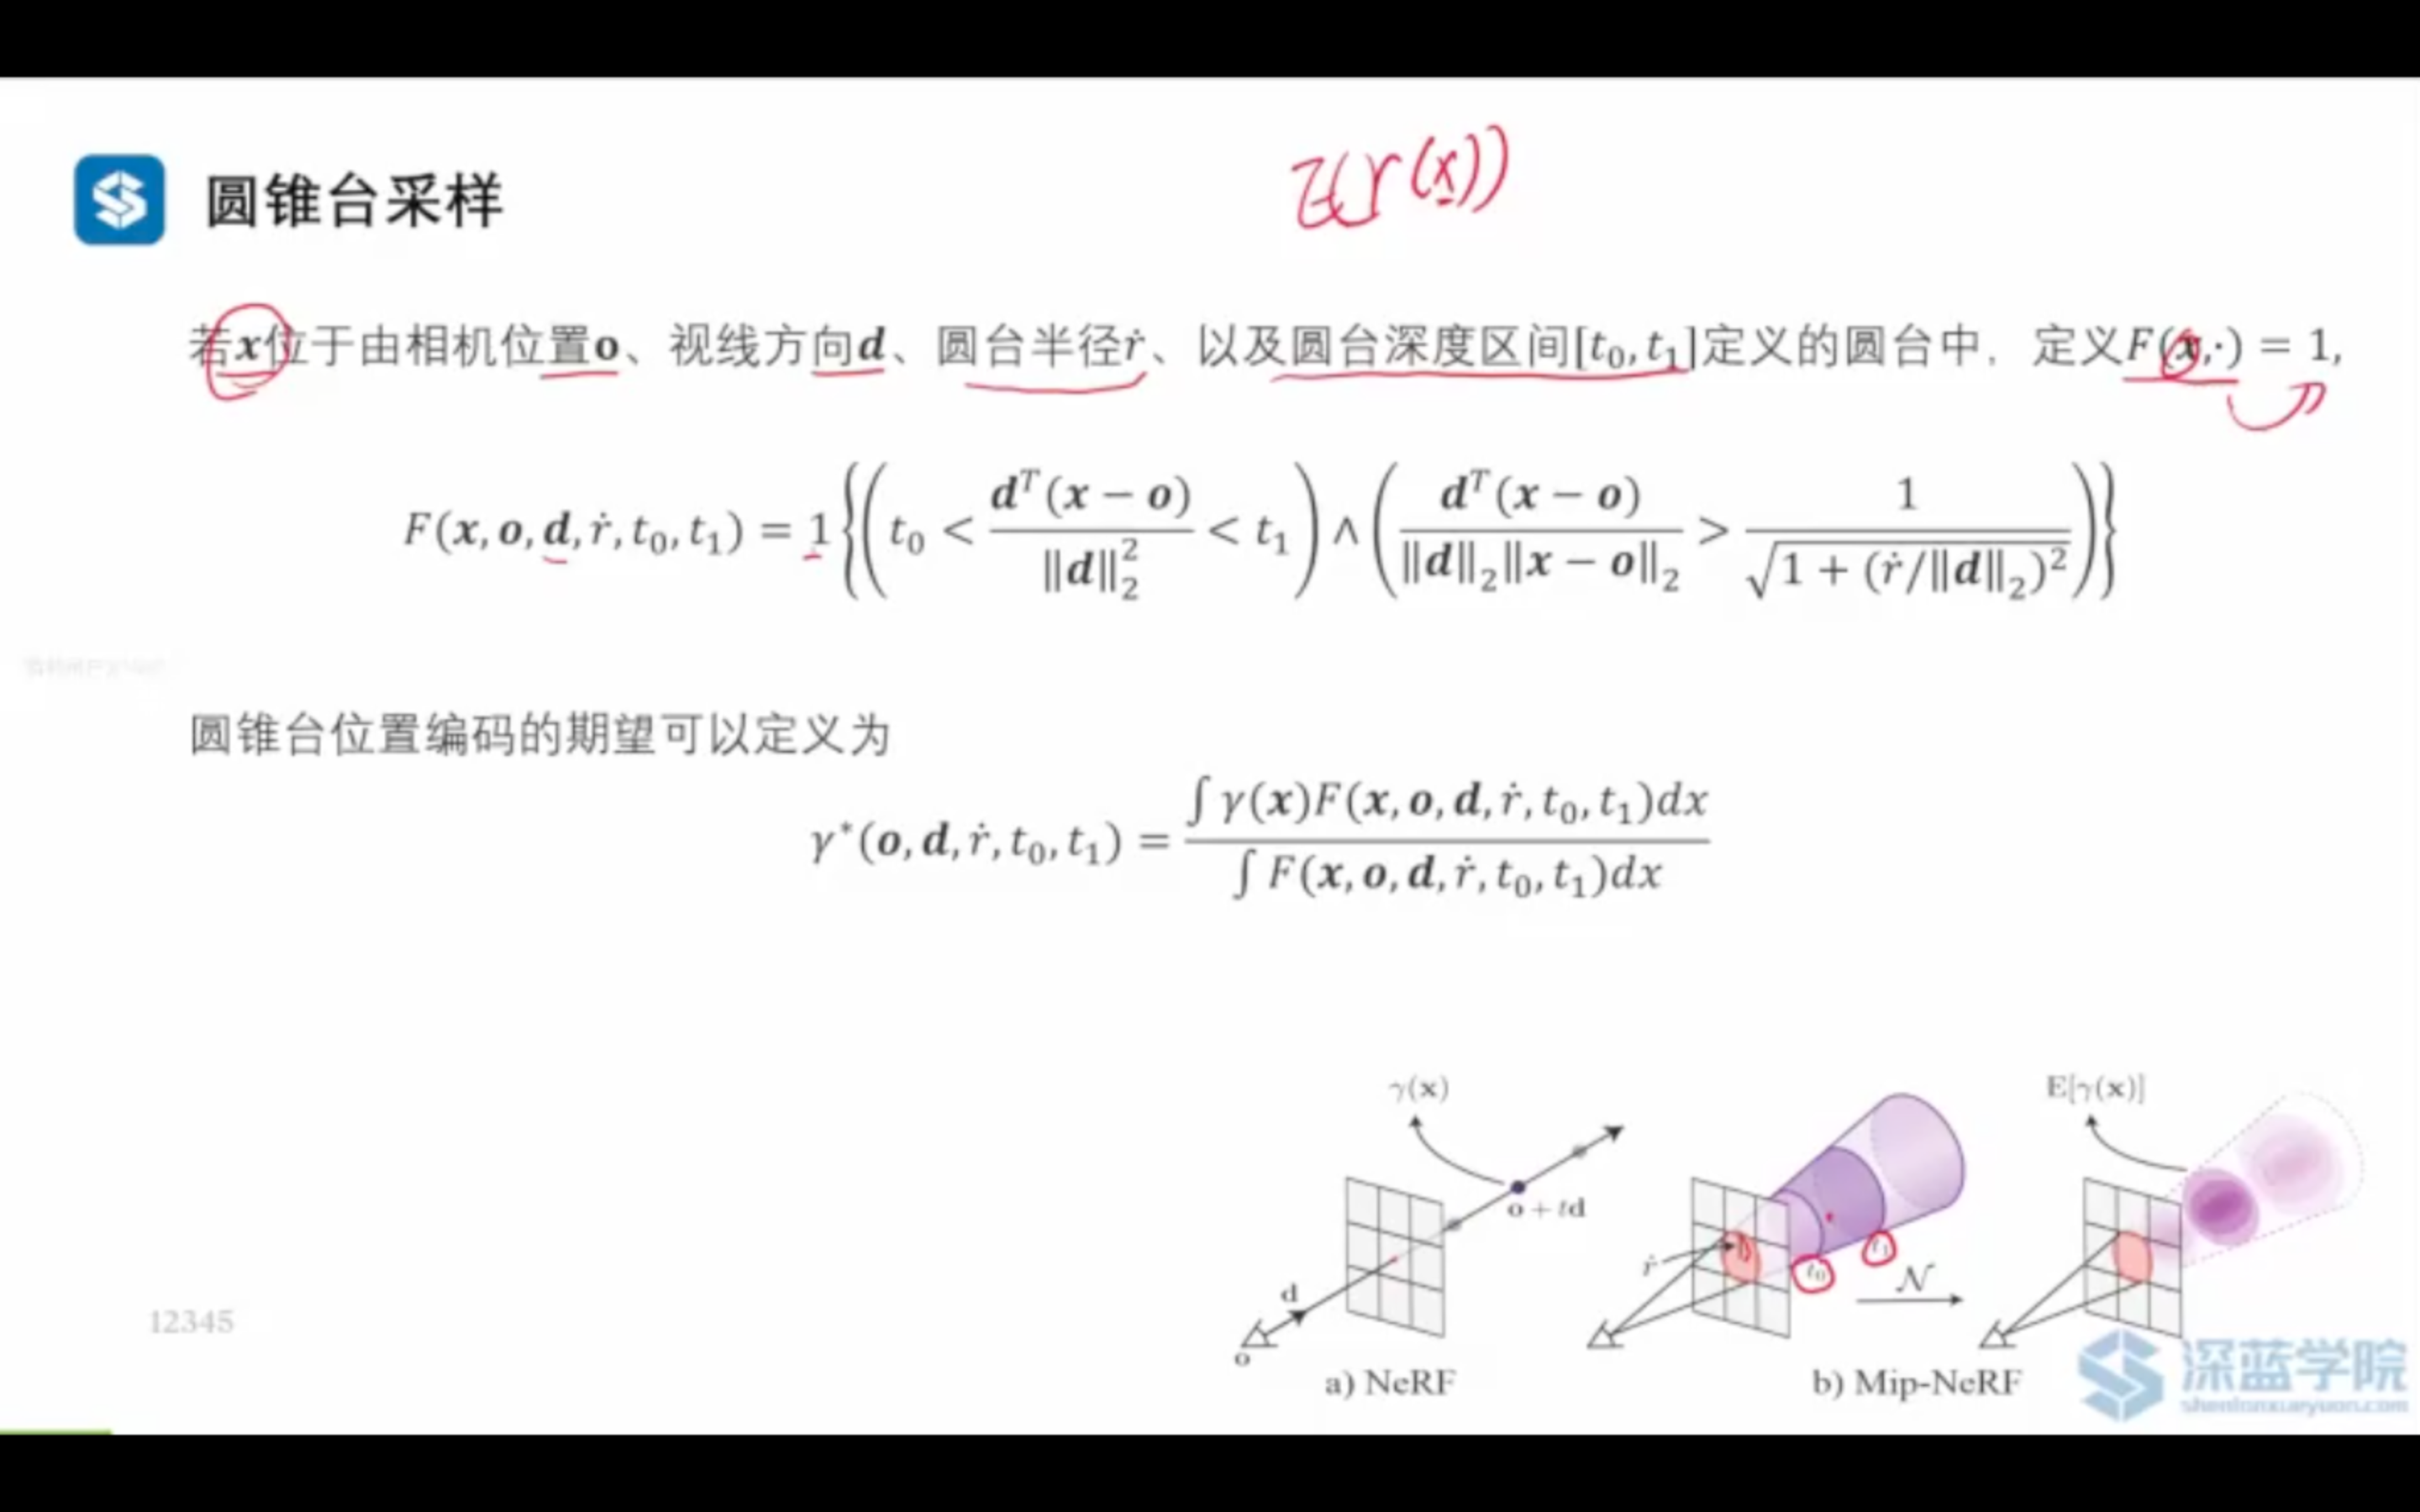
\(F\) 前面的不等式代表 \(t'\) 应该在 \(t_0,t_1\) 之间,后面的不等式代表夹角 \(\theta\) 应该在 FOV 内。
Instant-NGP
\[ C(\theta,\phi)=\sum_{j=0}^{\infty}\sum_{m=-j}^{j}c_j^m Y_j^m(\theta,\phi) \]
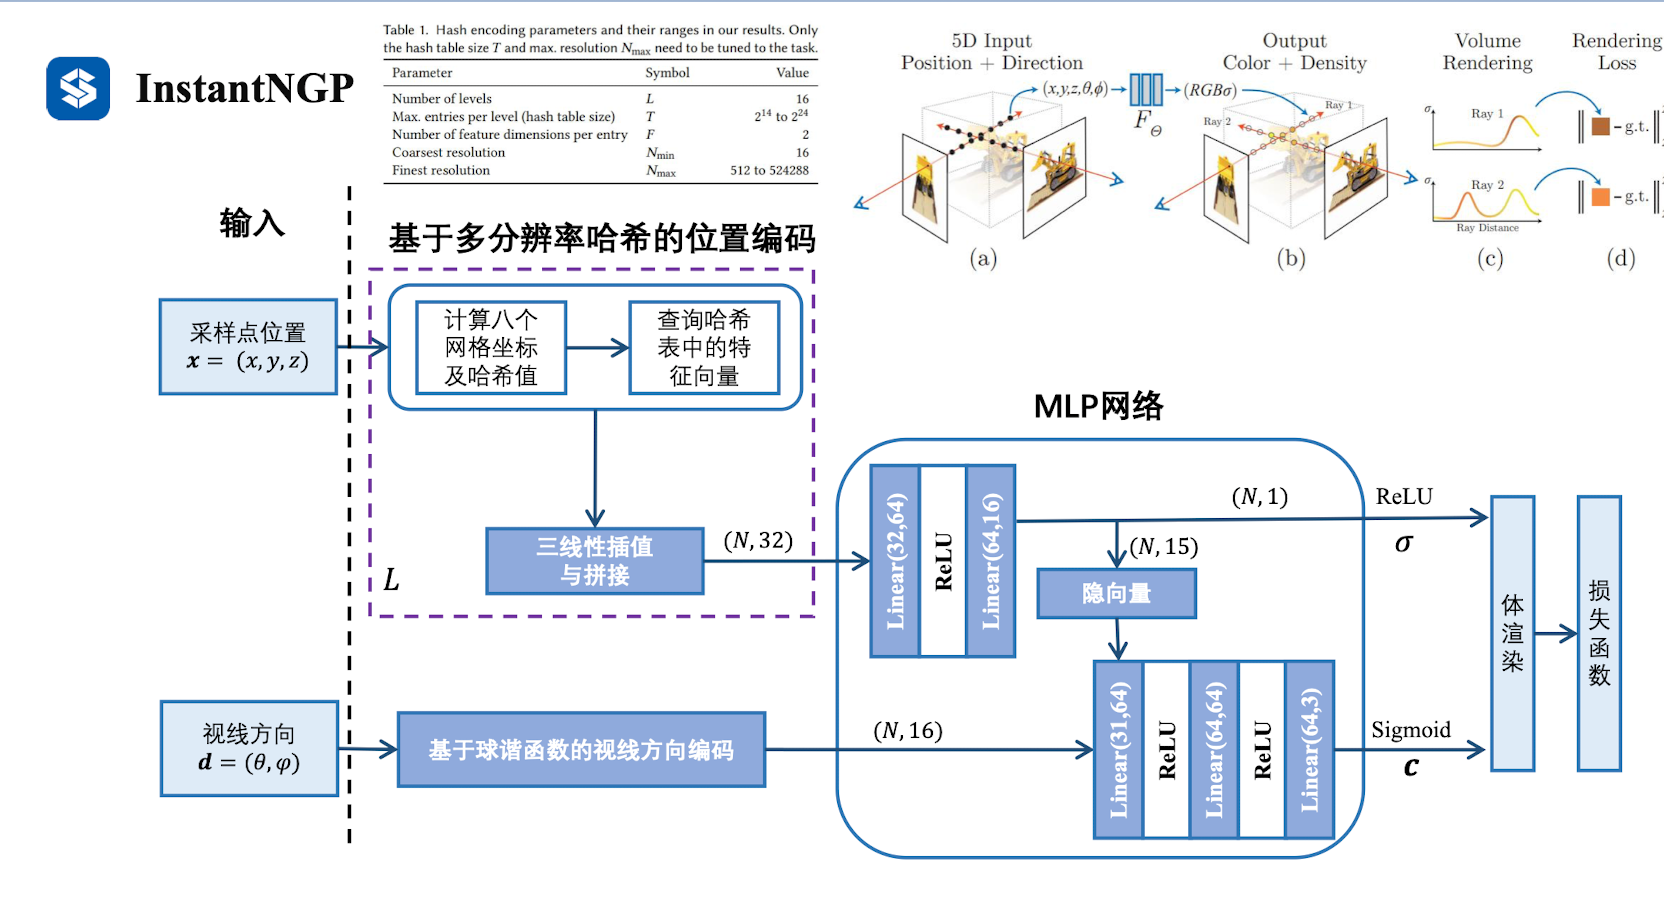
在 Instant-NGP 中,用球谐函数对观测方向 \(\mathbf{d}\) 做编码。原来的 \(\gamma\) 位置编码和不同视角下的颜色并没有什么关系,只是单纯的位置编码;而球谐函数编码本身就和不同视角下的颜色有关。
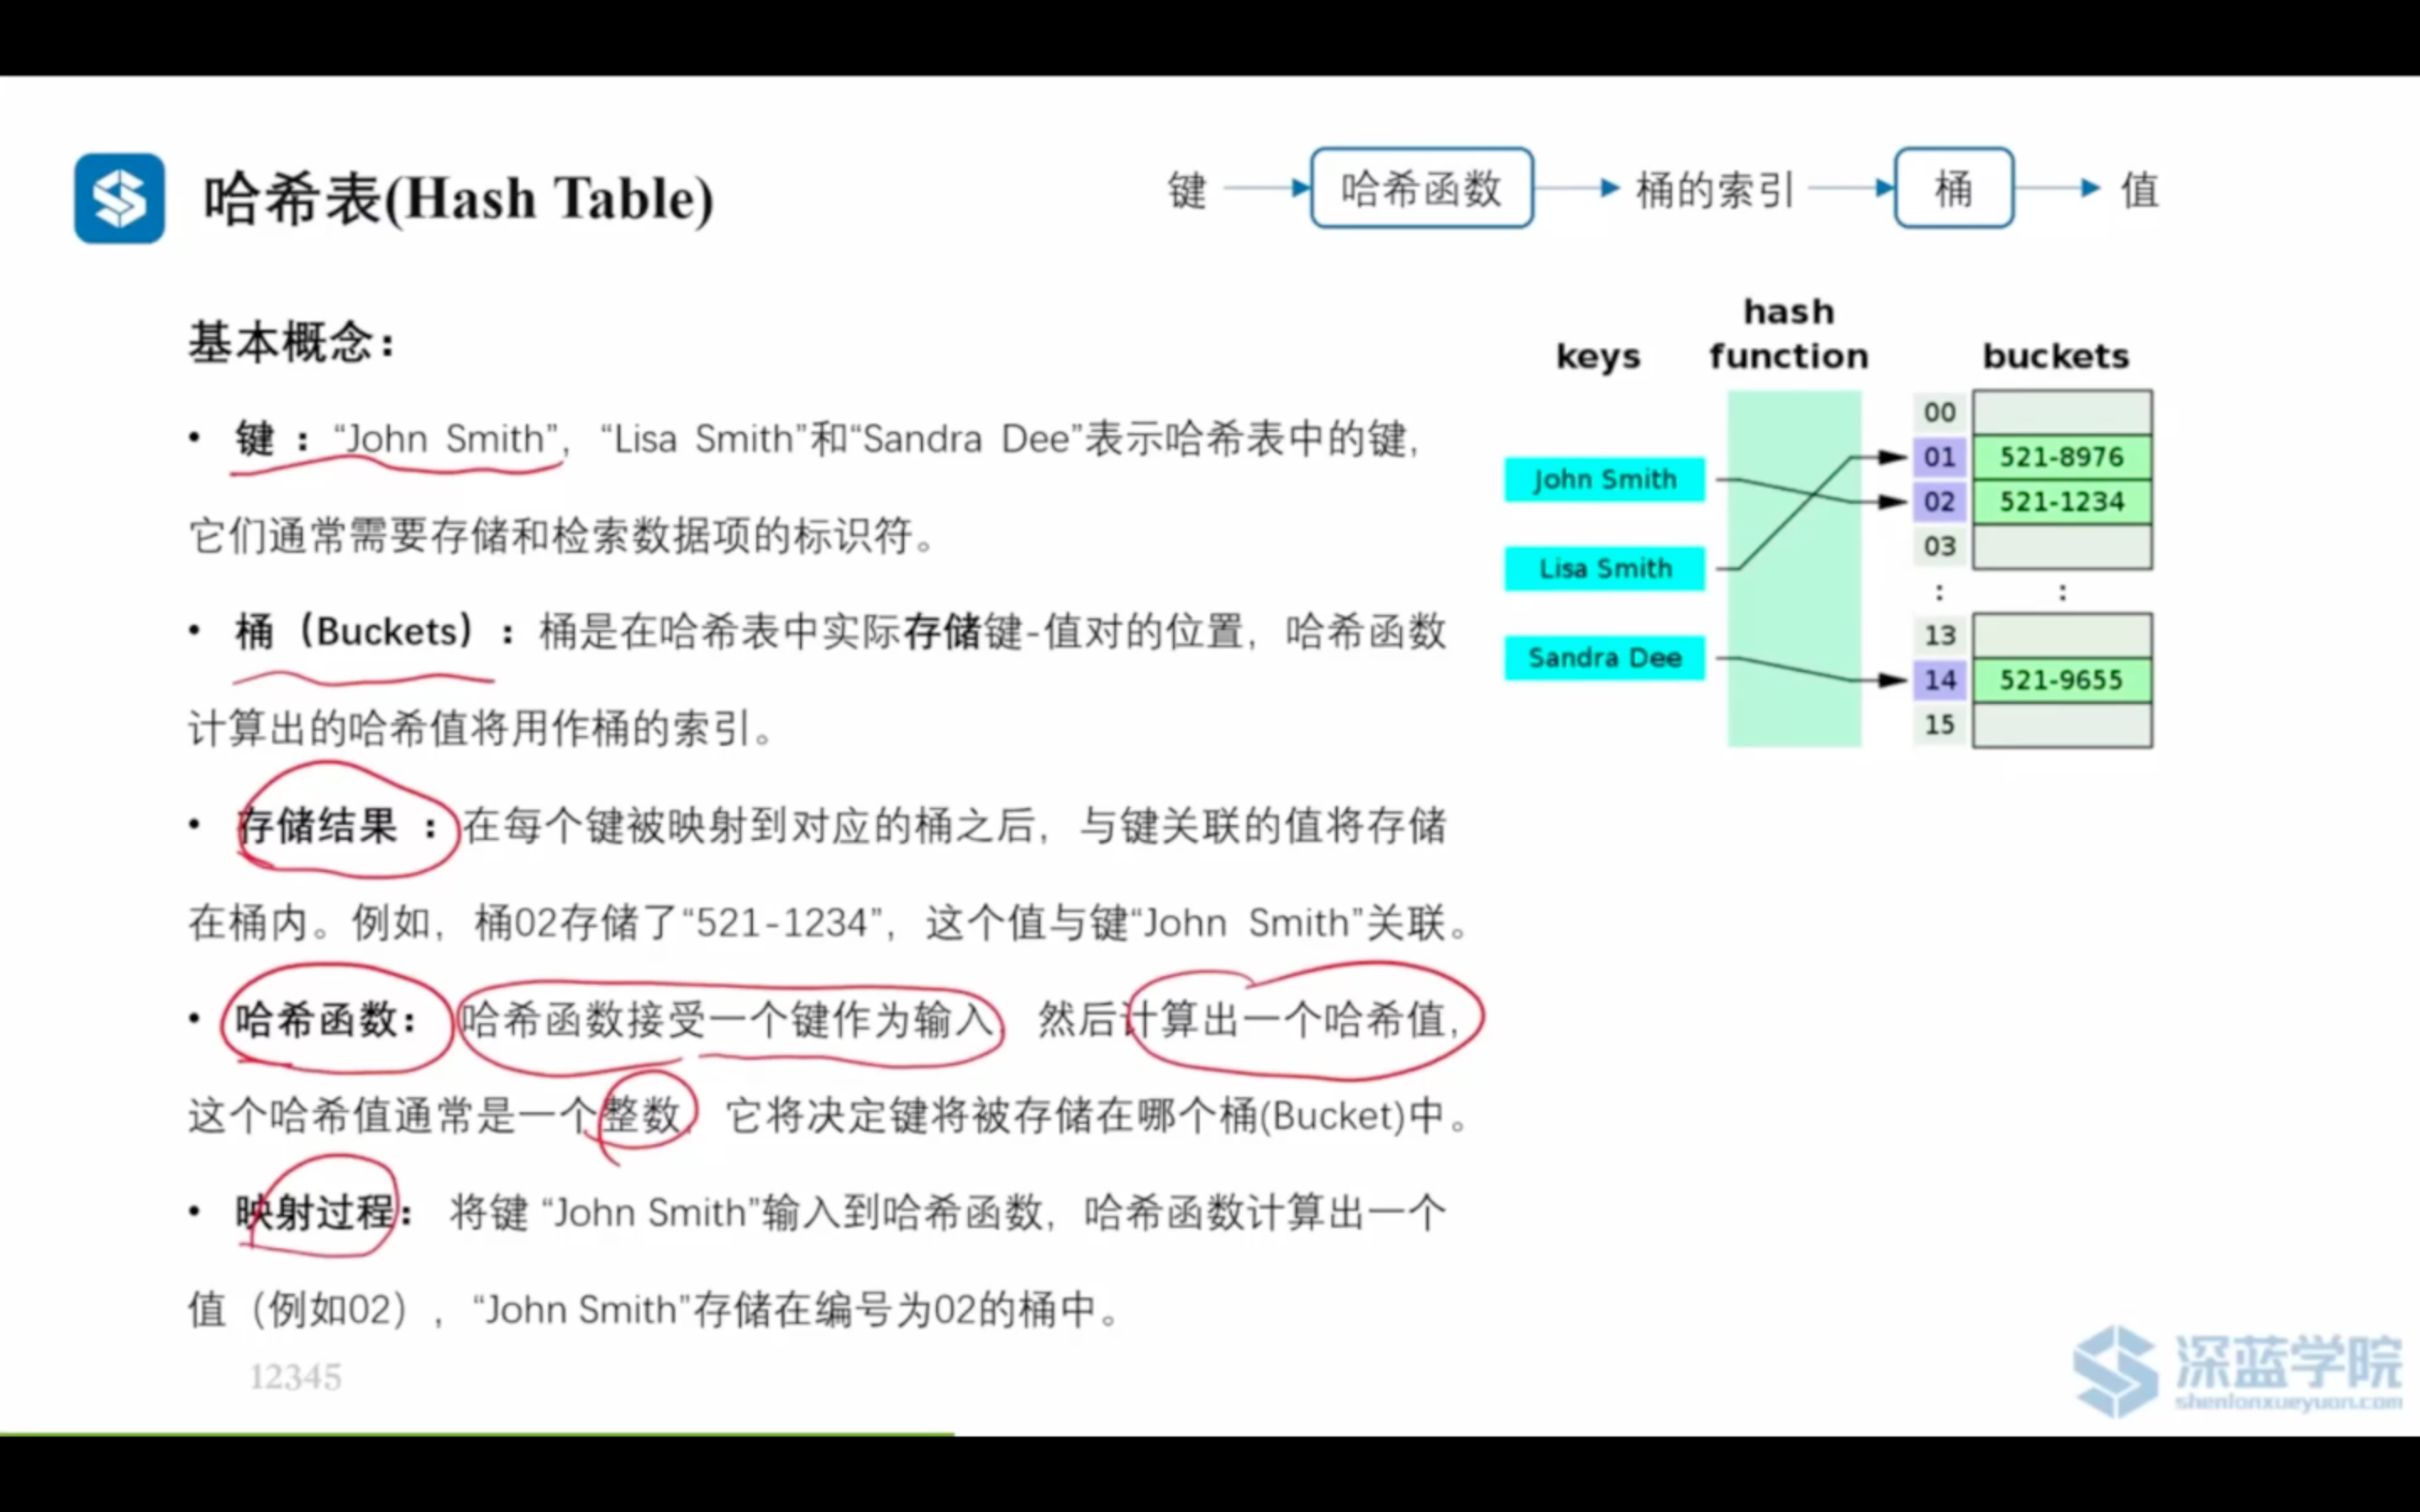
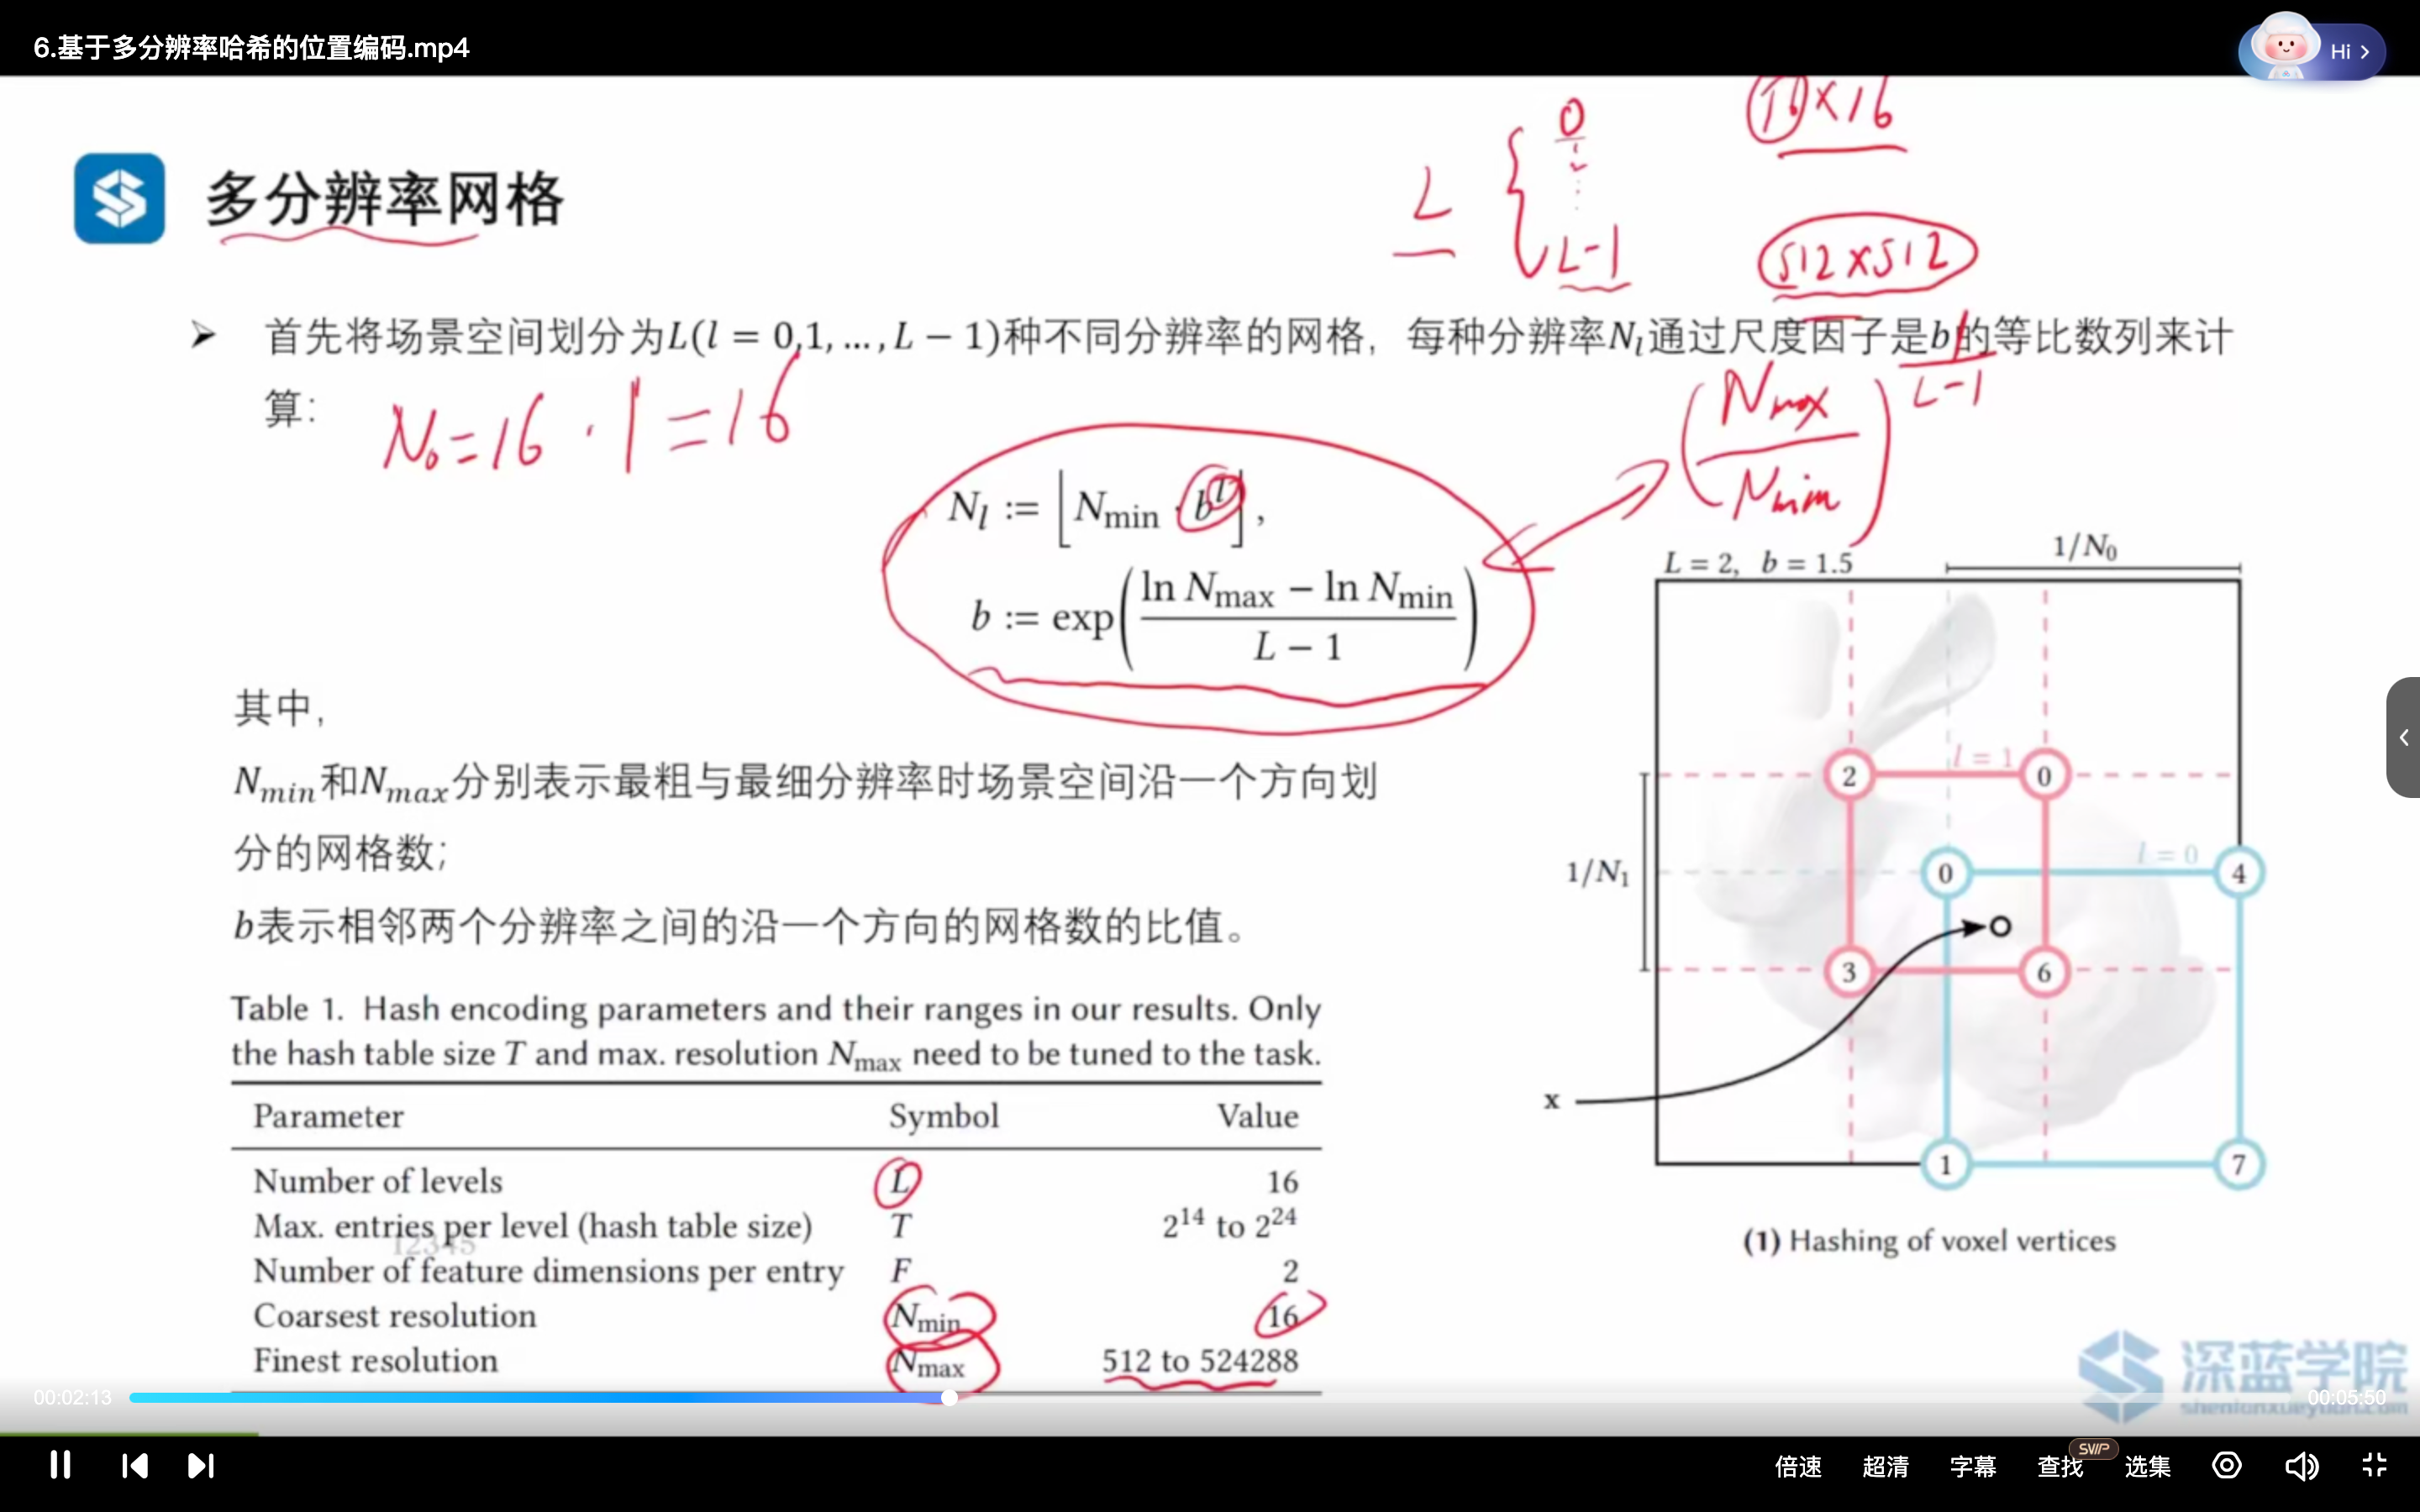
不过上述对观测方向编码方式的改变,并没有对 NeRF 的训练加速产生很大影响。Instant-NGP 真正的加速来自它对 \(xyz\) 采用的另一种编码方式。
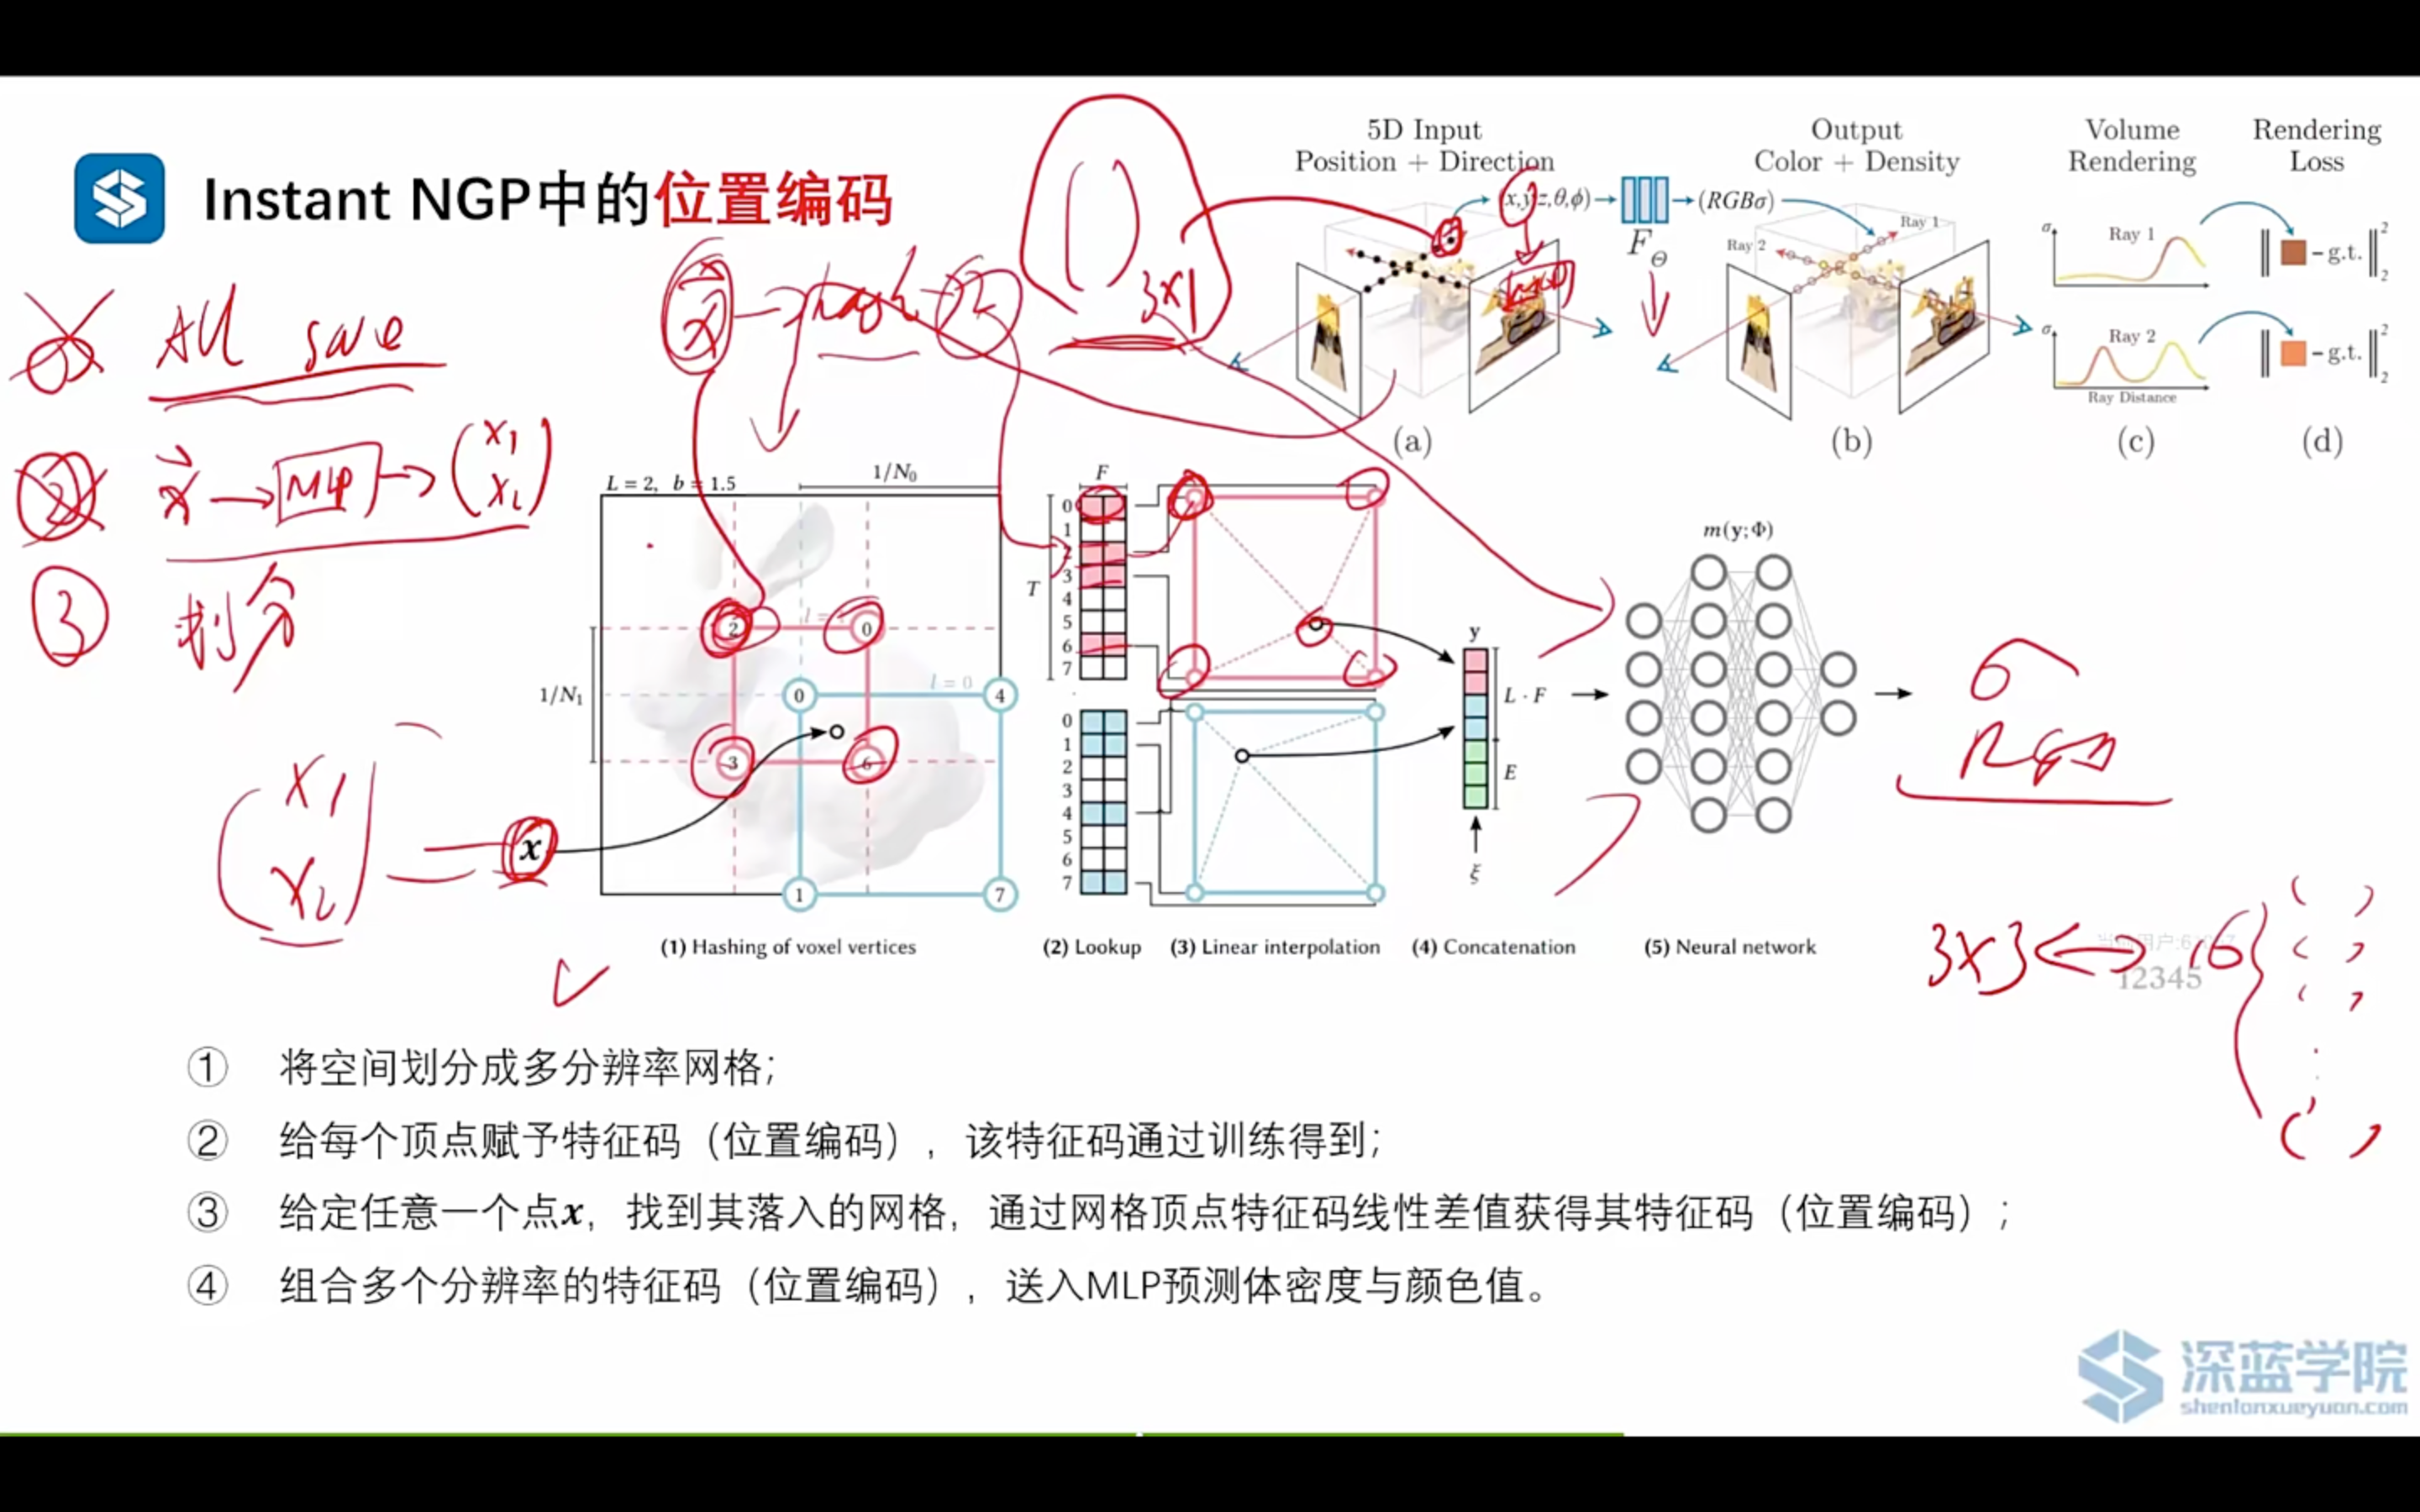
哈希码在此处的作用是:给定网格顶点的三维坐标,能够查找到其对应顶点的特征码(位置编码)。
可泛化 NeRF 与少视角 NeRF
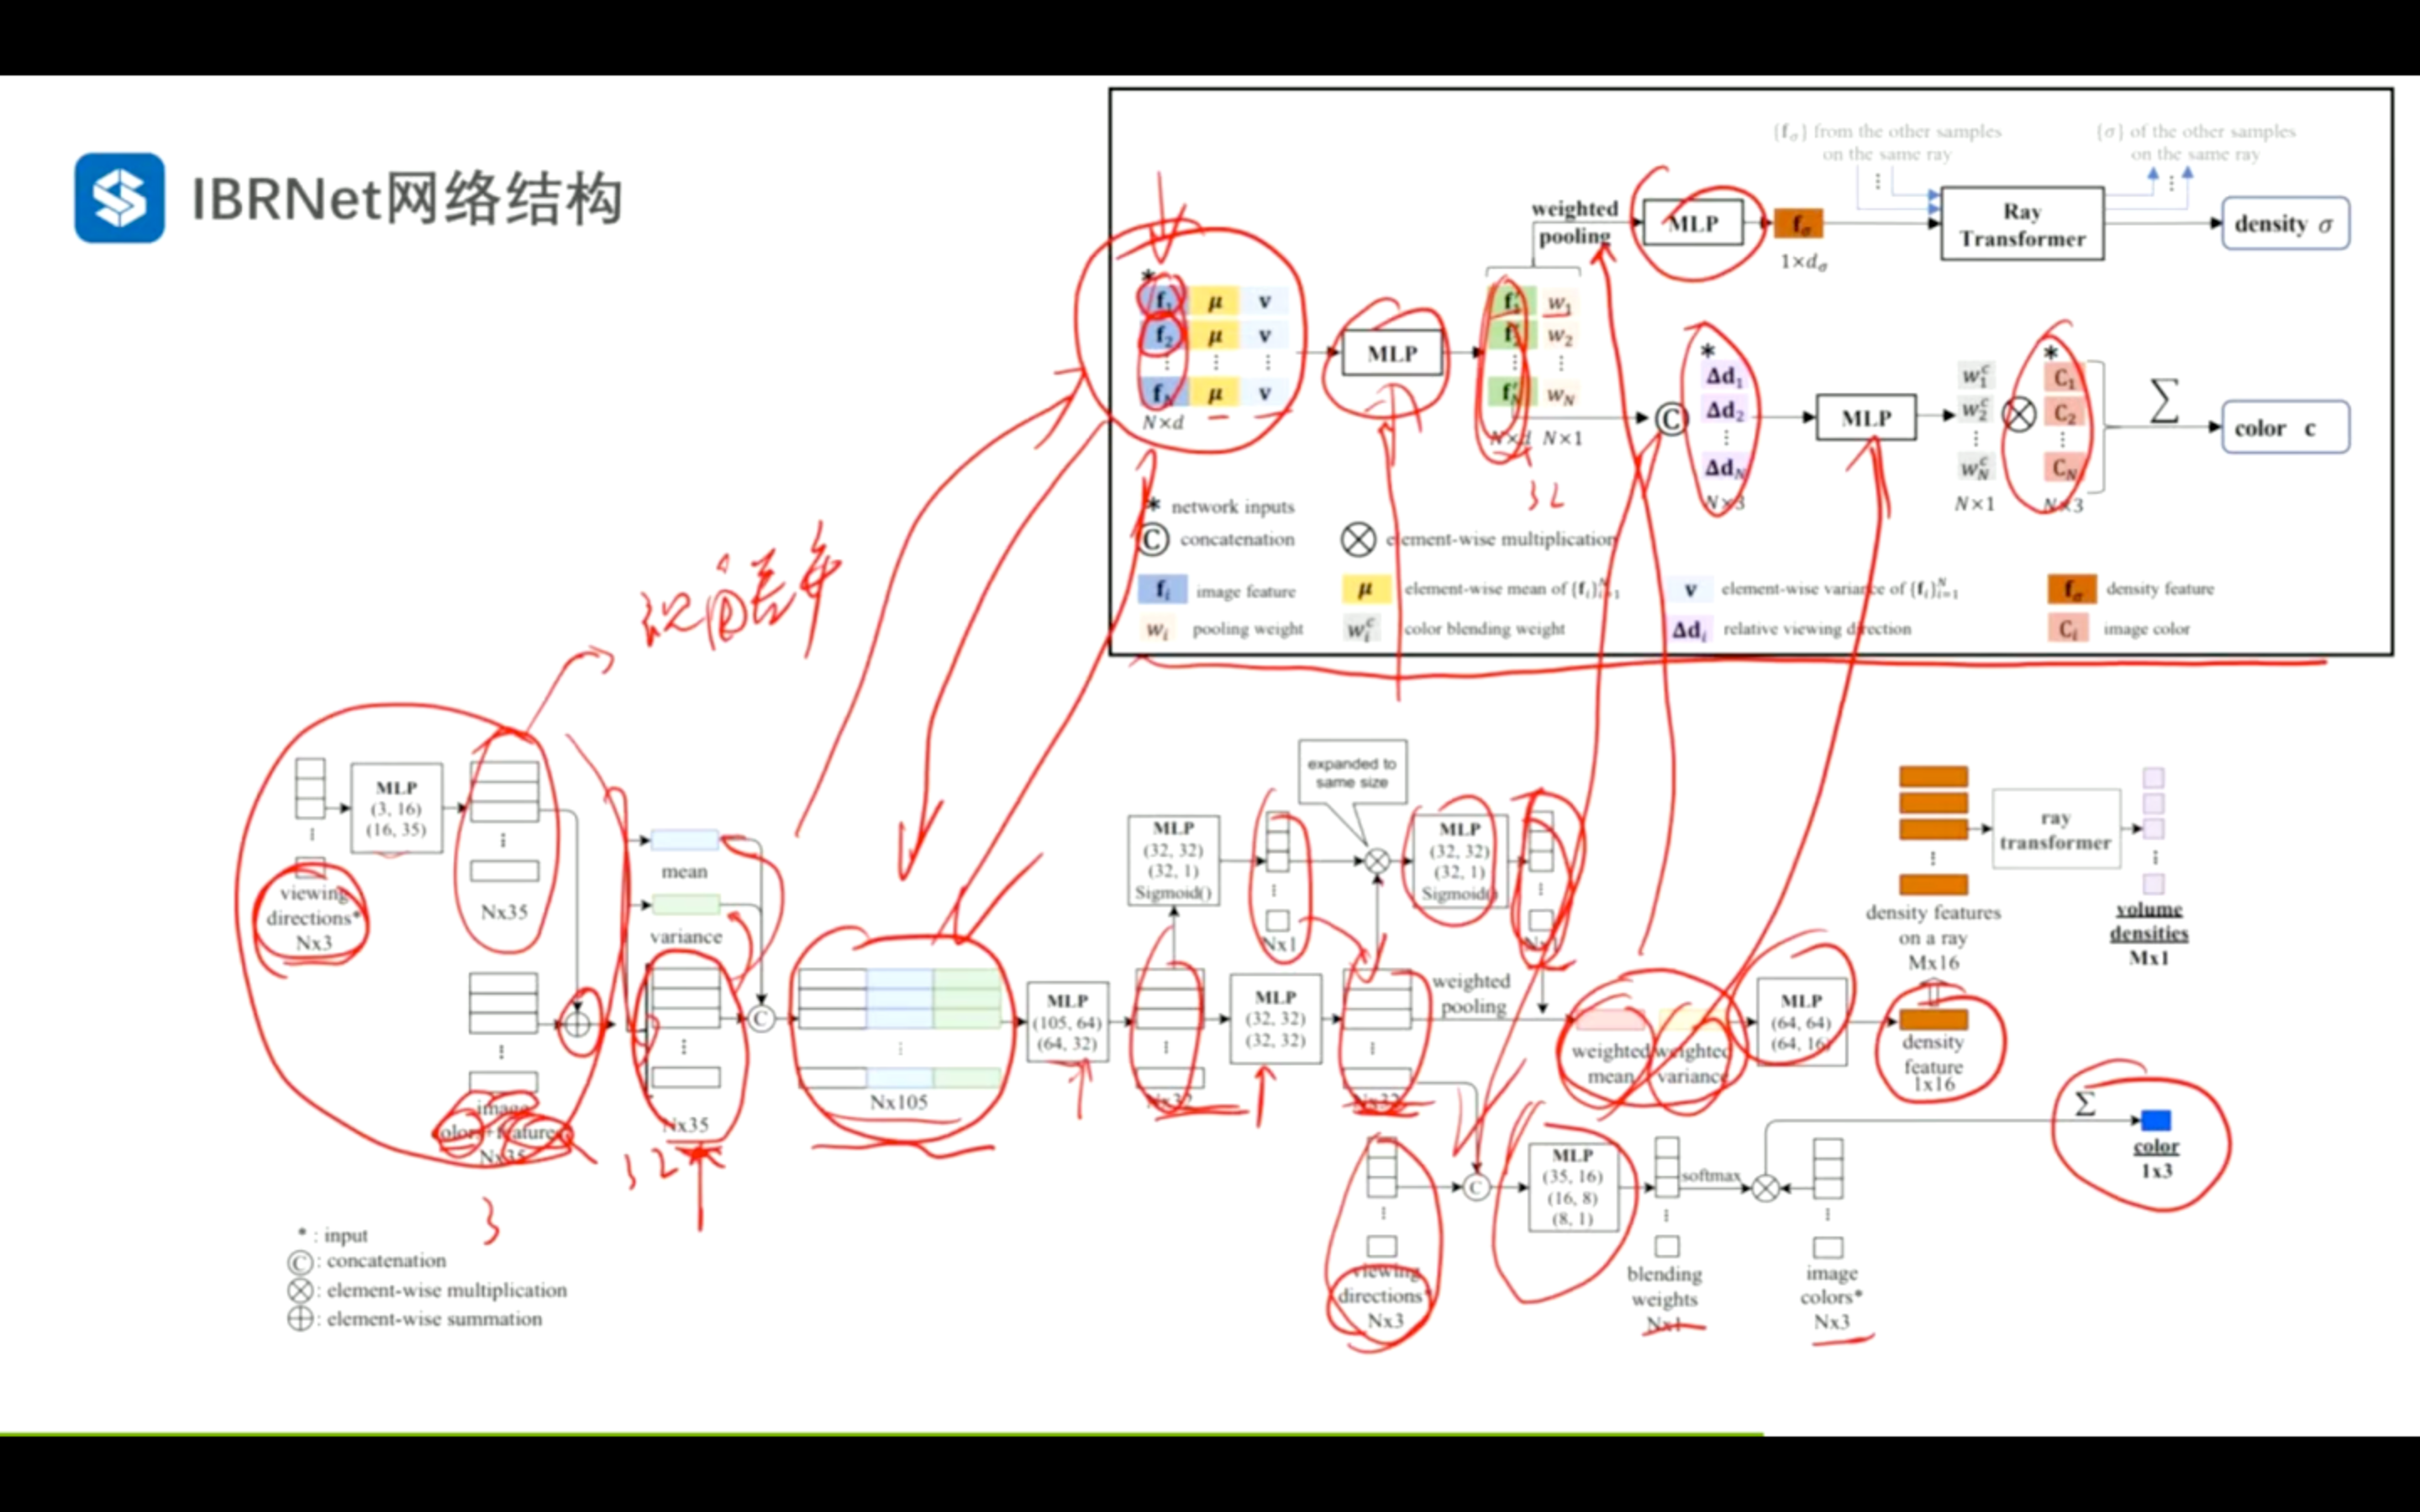
IBRNet(泛化)
DS-NeRF(少视角)
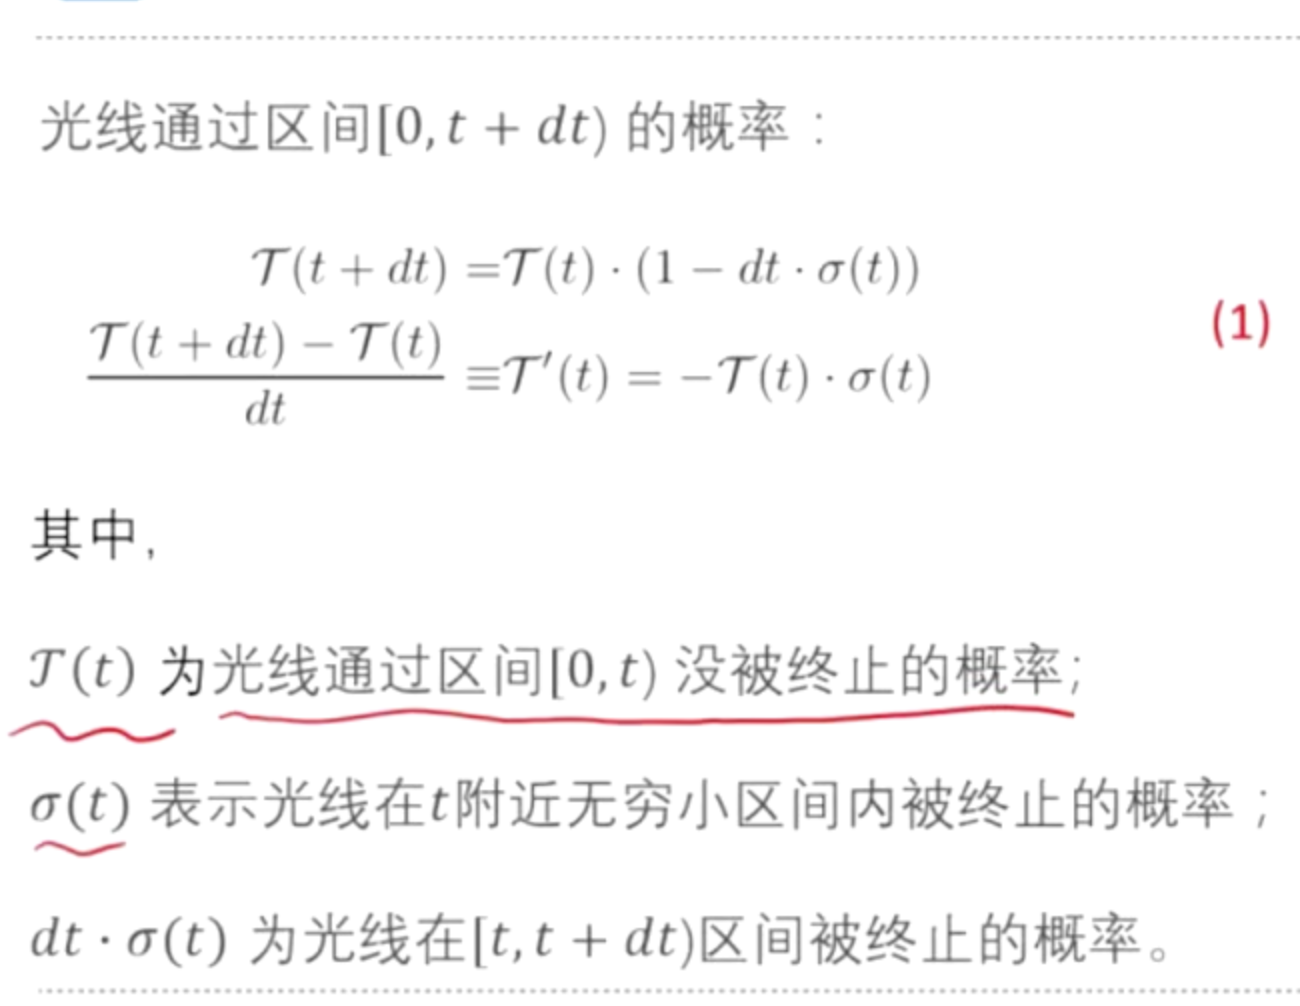
将累积透射率 \(\tau(t)\) 和消光系数 \(\sigma(t)\) 相乘,\(\tau(t)\sigma(t)\) 实际上代表了光线到达 \(t\) 点并在该点被终止(吸收或散射)的概率。这个表达式结合了两个物理过程:
- 光线在到达 \(t\) 点之前,由于经过介质的累积吸收和散射而剩余的光强比例 \(\tau(t)\)。
- 在 \(t\) 点处介质的消光能力,即光线在该点被吸收或散射的概率 \(\sigma(t)\)。
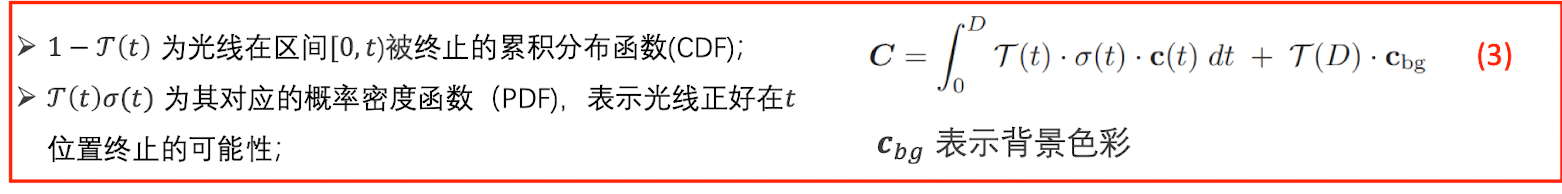
\(\tau(t)\) 表示光线在到达点 \(t\) 之前没有被吸收的概率,它随 \(t\) 增加而单调递减。相应地,\(1-\tau(t)\) 才是吸收事件的 CDF:它表示光线在这段路径上被吸收的概率,是从起点到 \(t\) 处光线遇到的所有吸收事件概率的总和,随 \(t\) 增加而单调递增——越远的点表示光线穿过了更多介质,因此被吸收的概率越大。
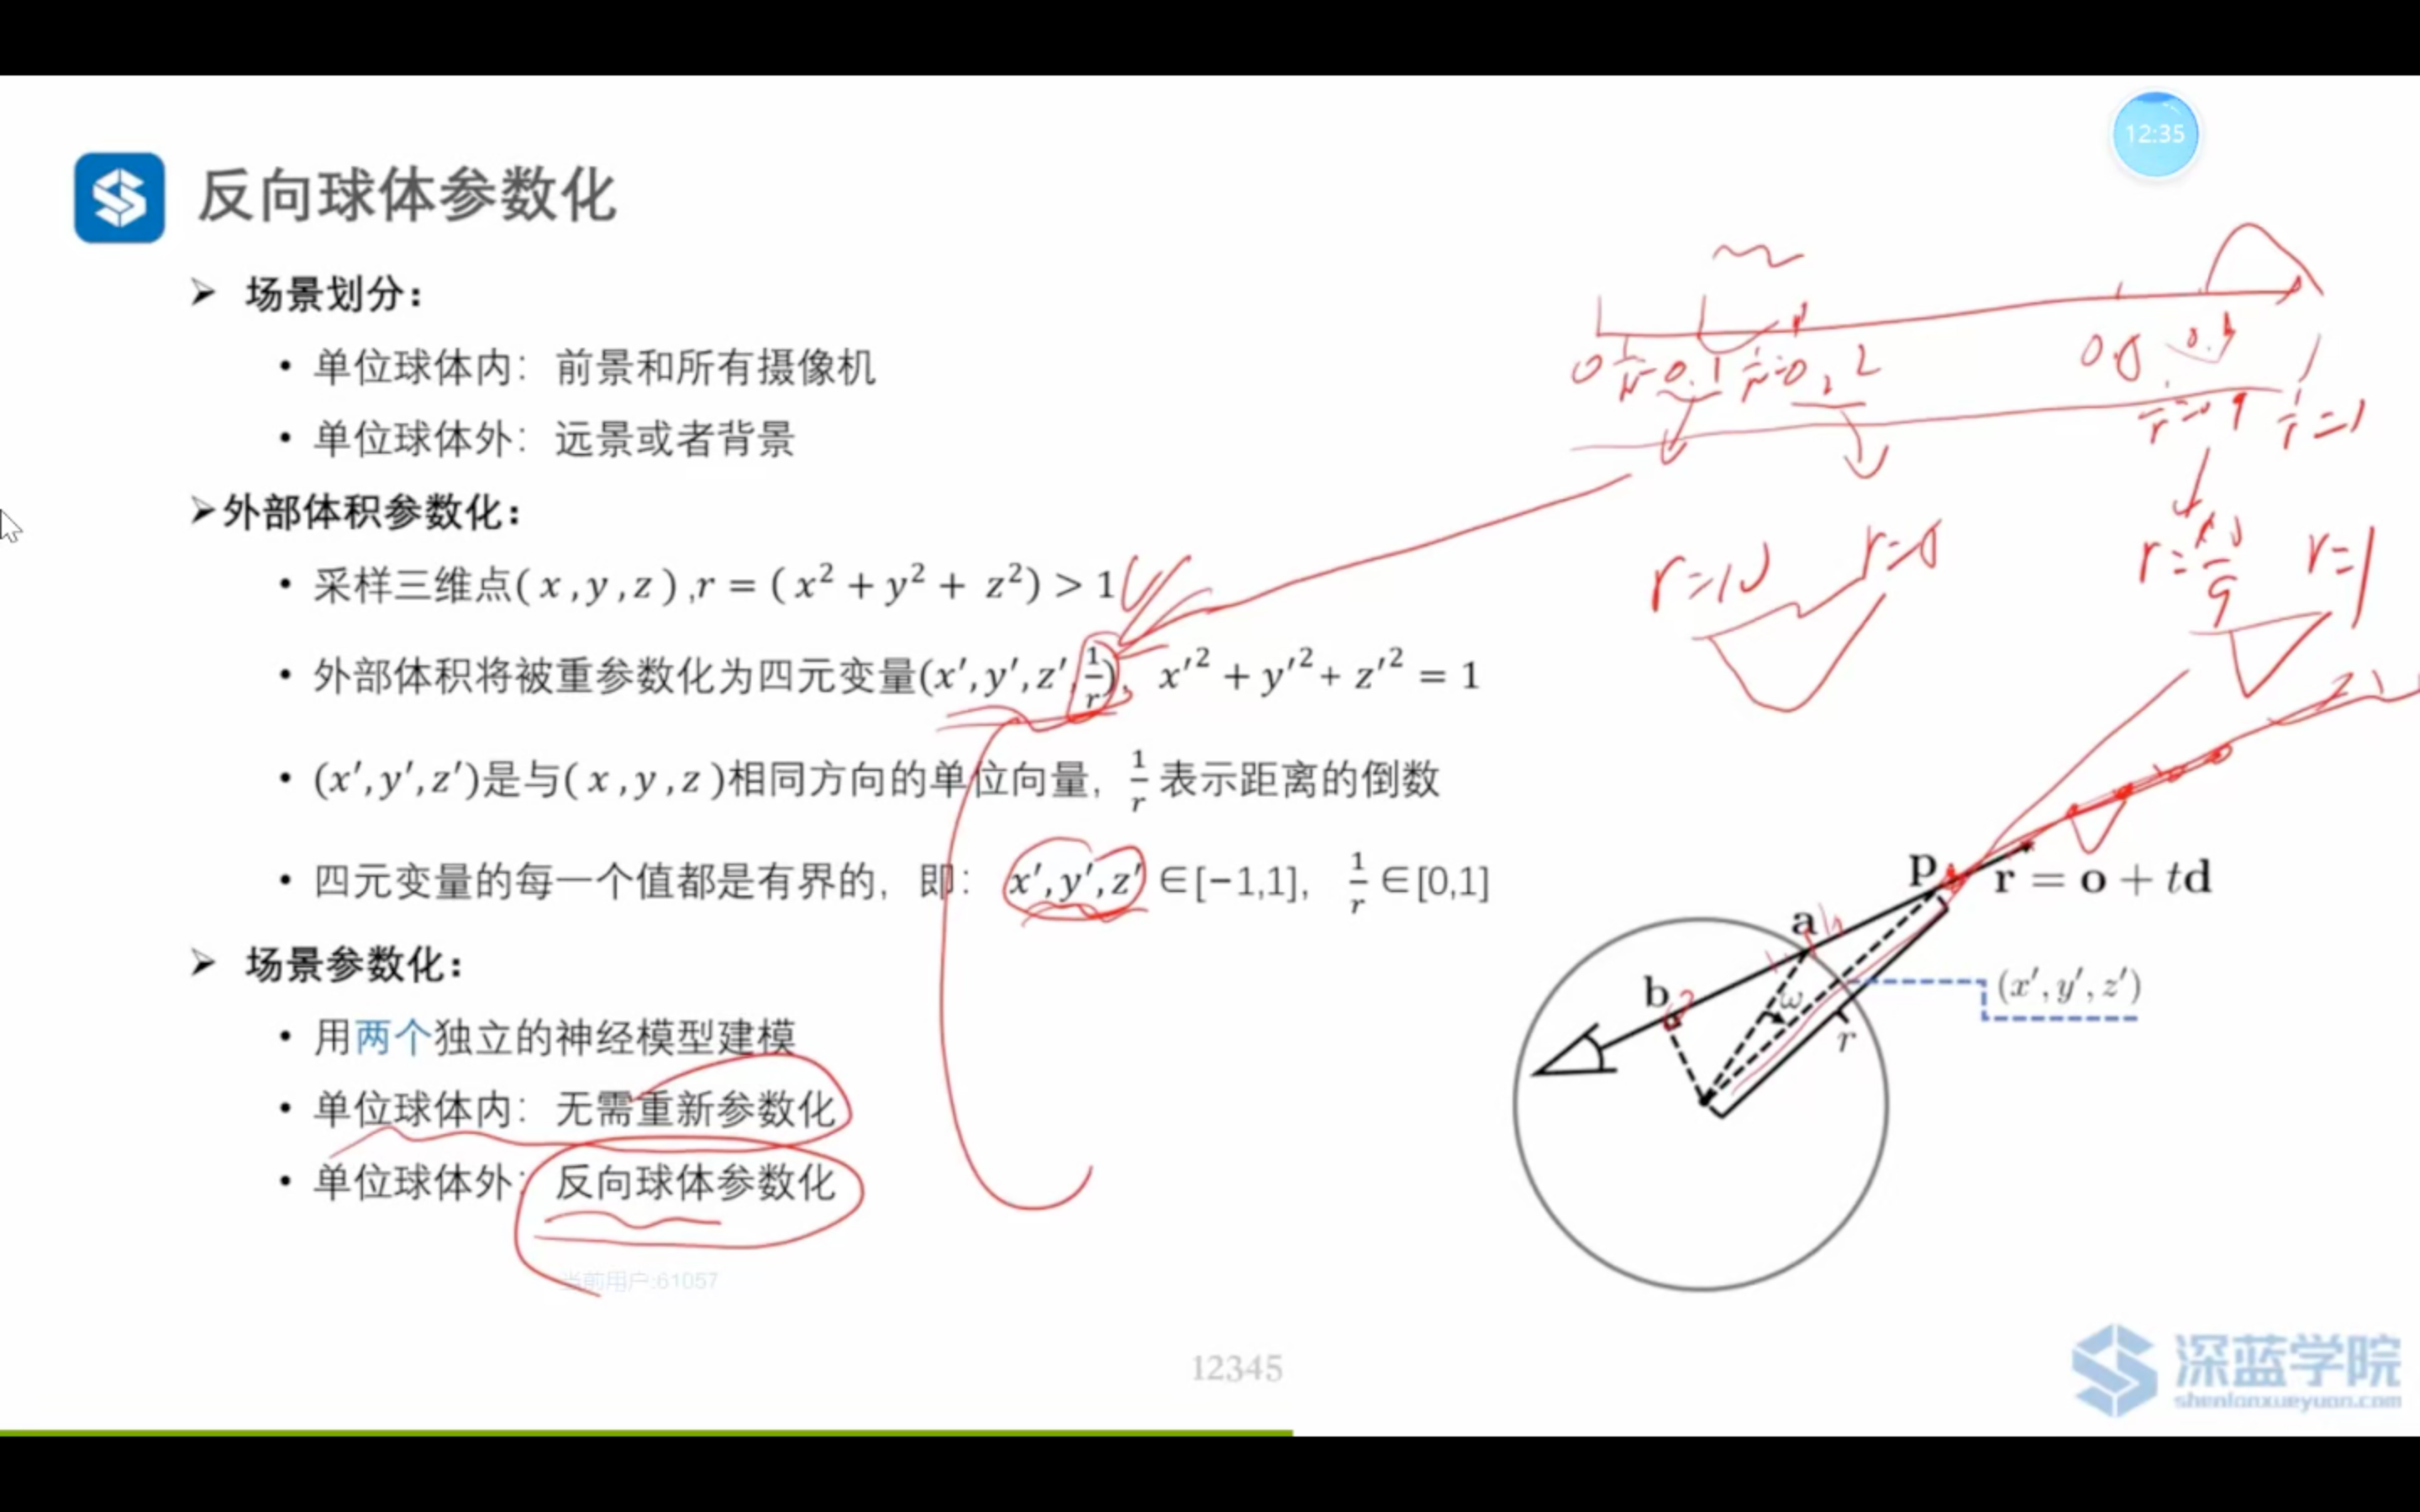
无界场景:NeRF++
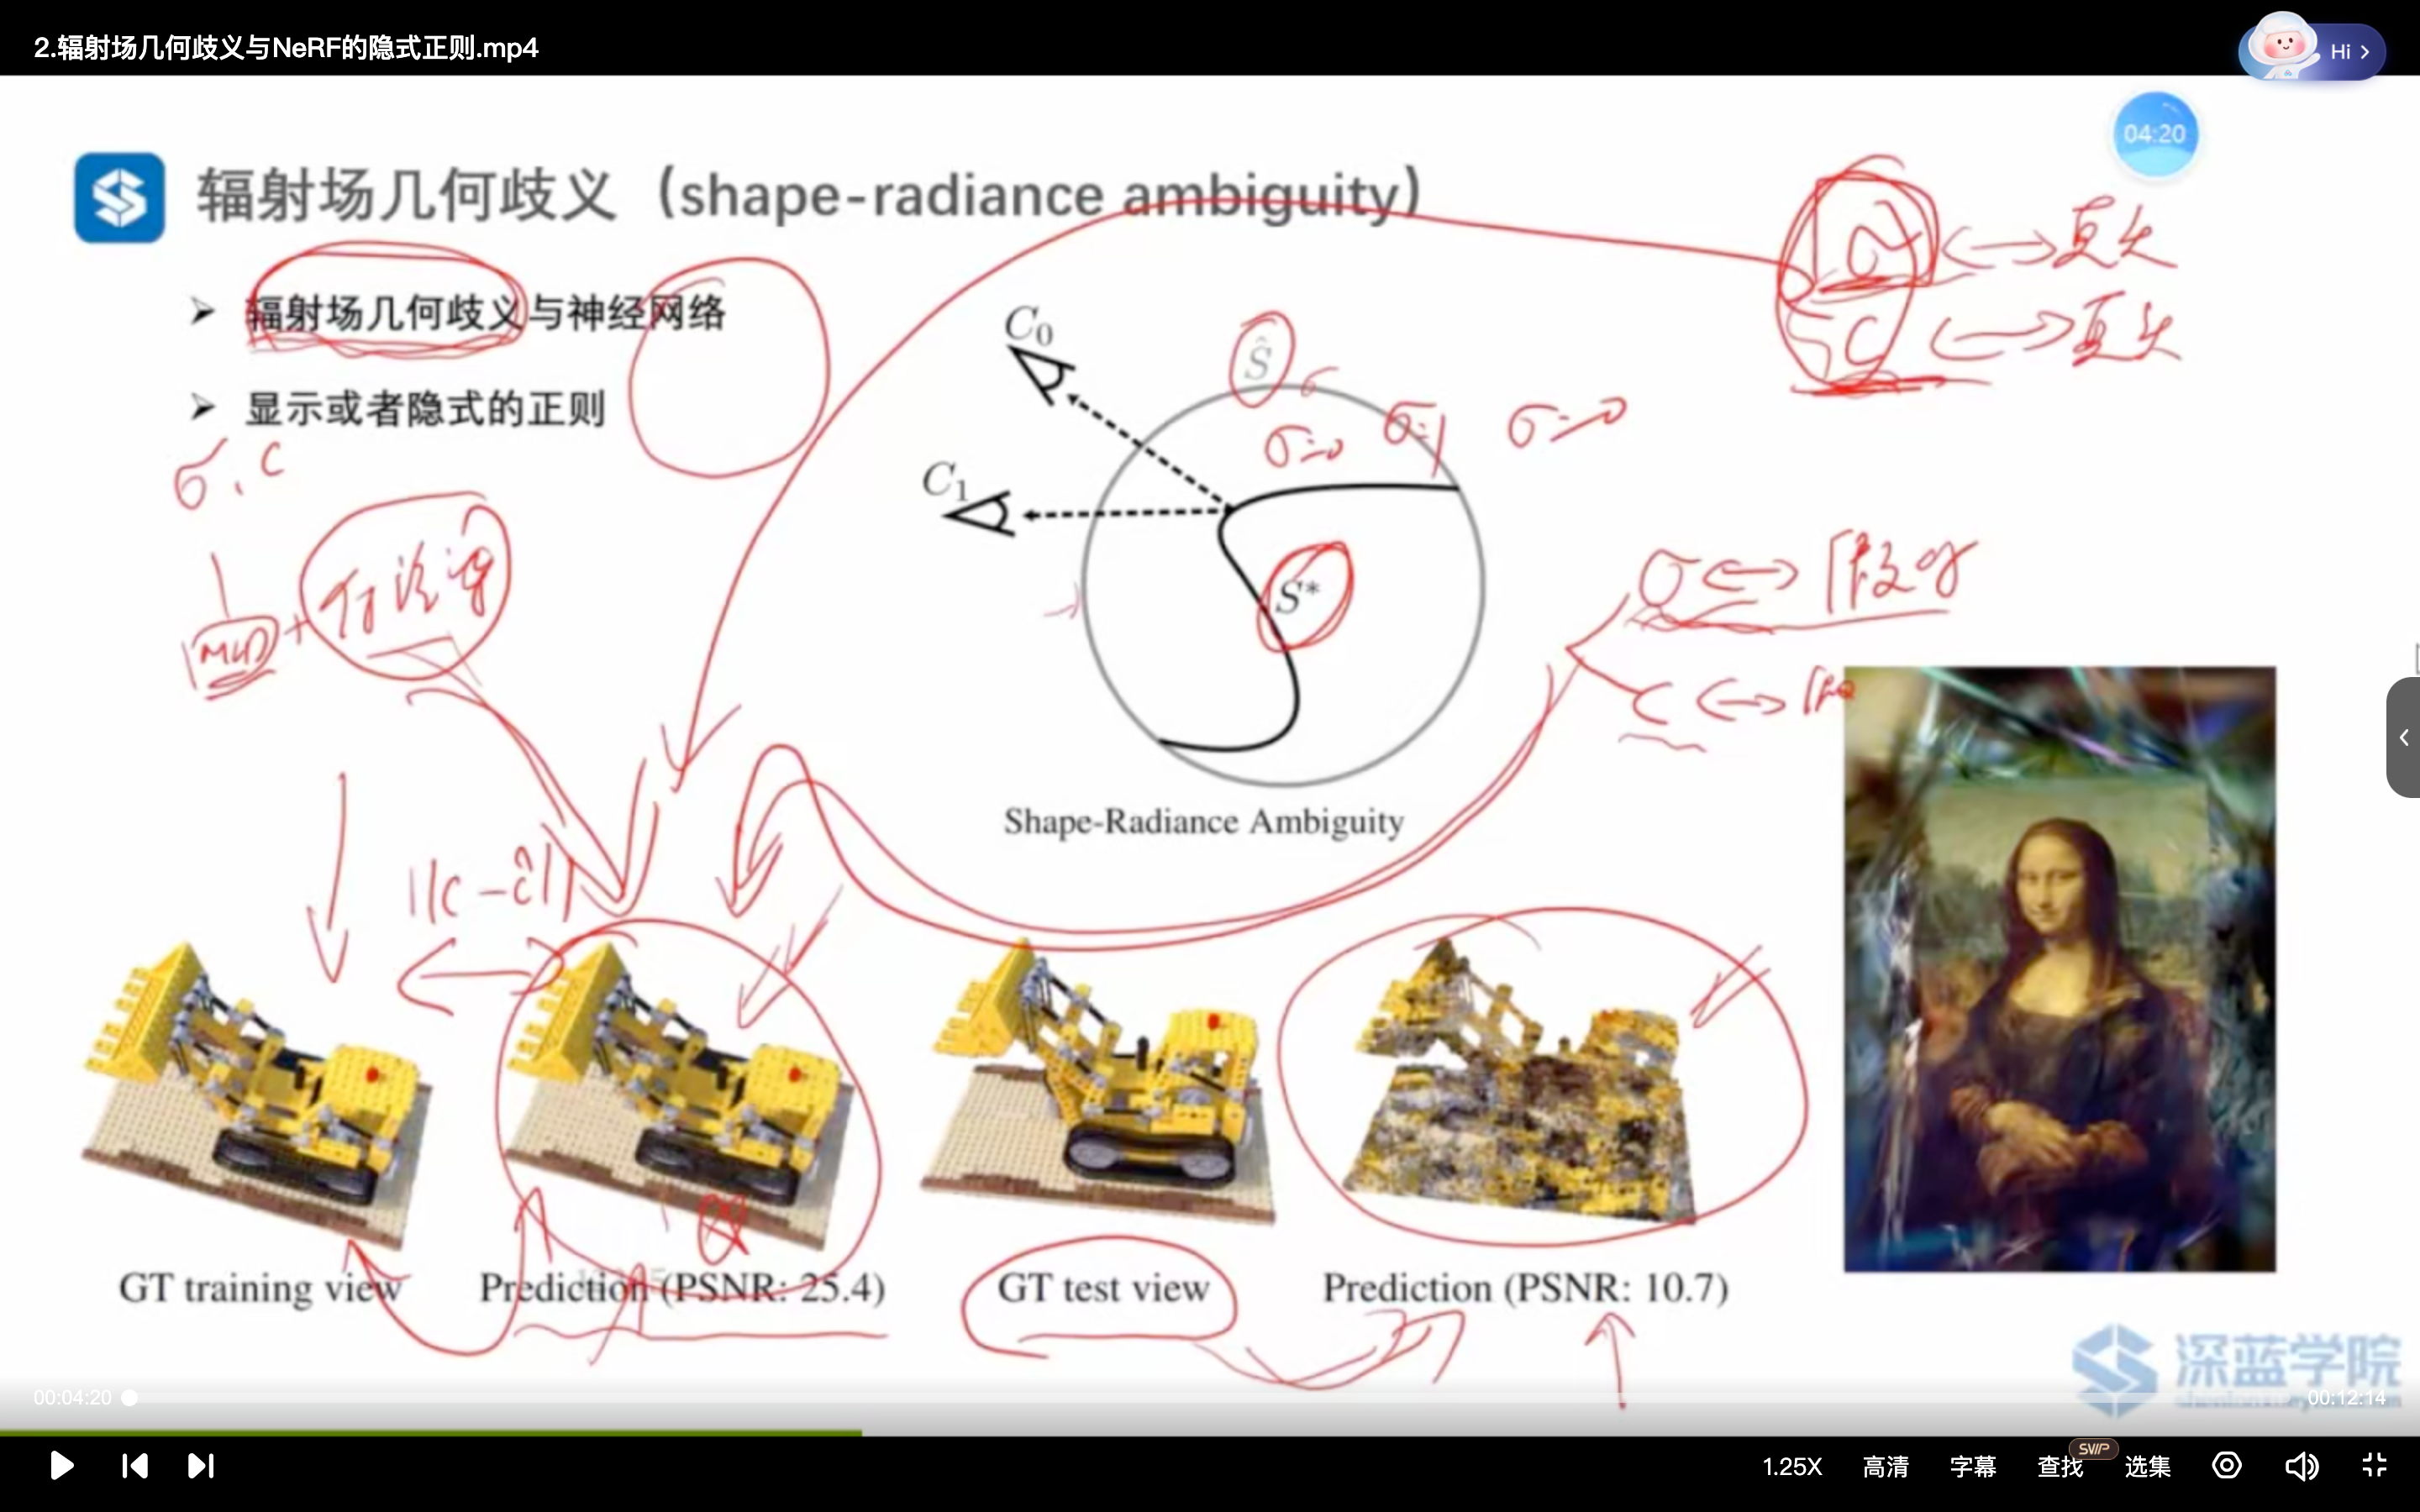
几何歧义是指:NeRF 约束的只是最后的颜色值 \(c\),而不是 \(\sigma\) 和 \(c\) 的组合,而很多不同的 \((\sigma, c)\) 组合都能生成同样的颜色值。
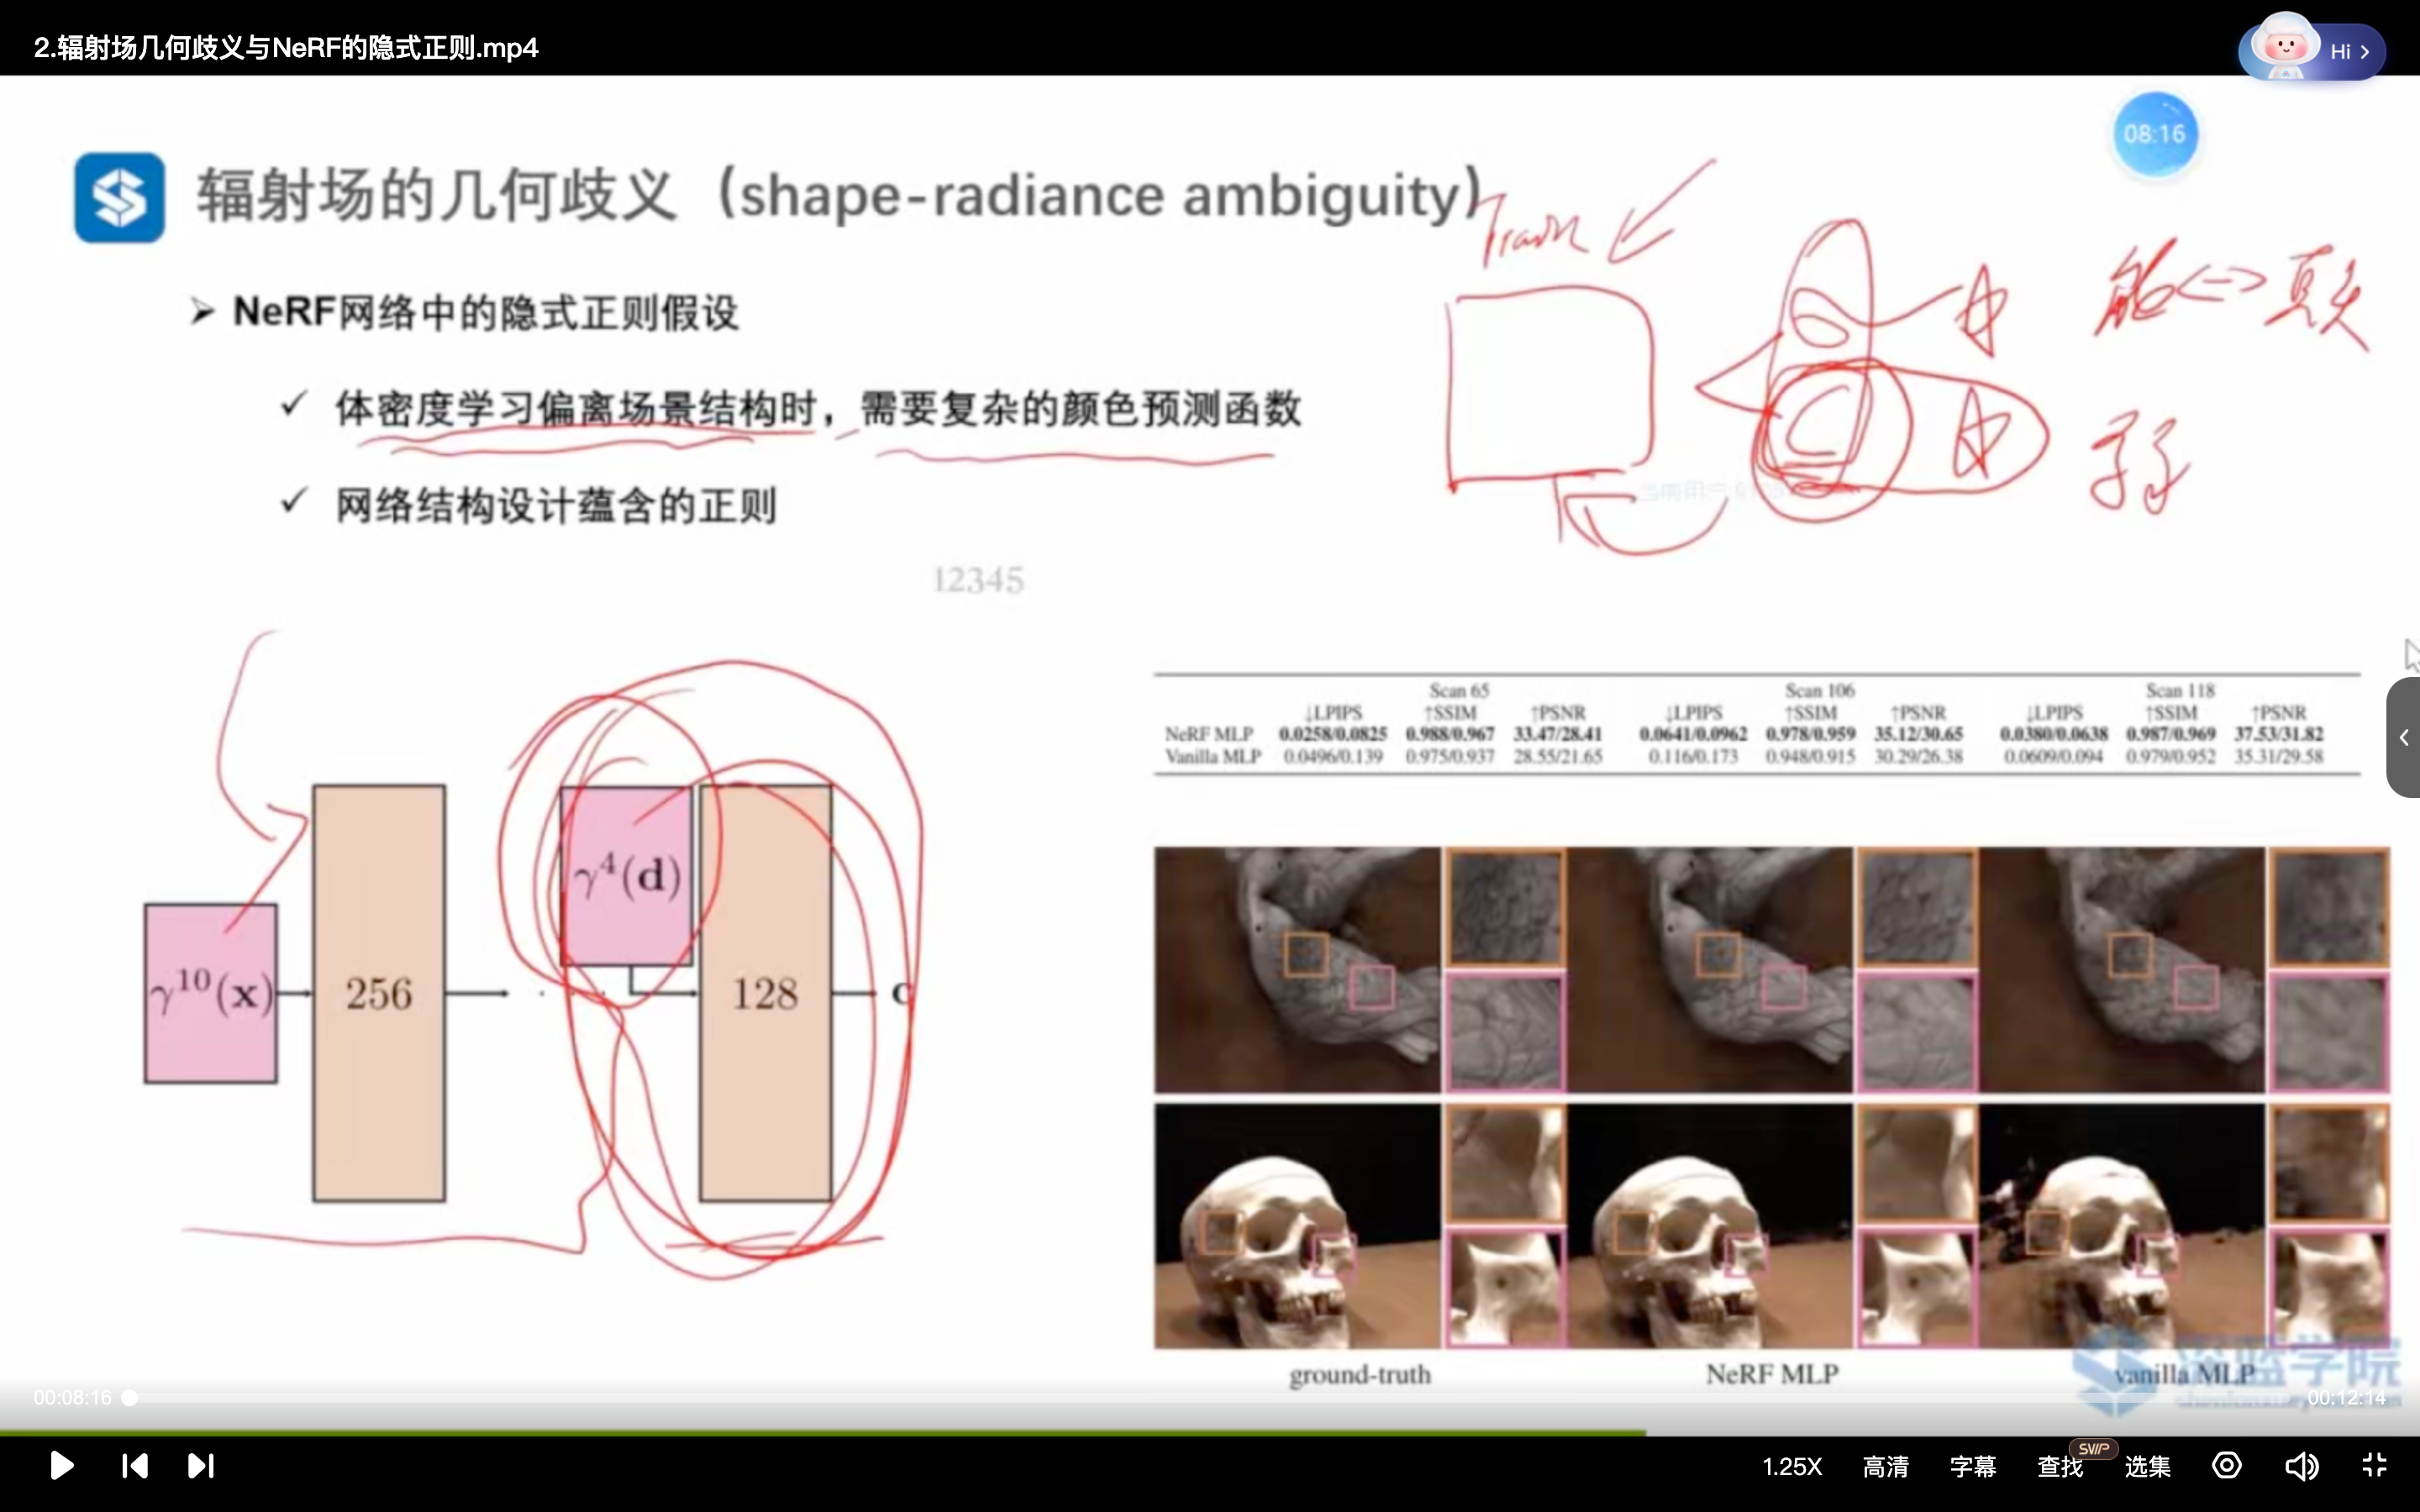
这里可以看到,为什么后面加入视角 \(d\) 后只通过一个很简单的网络就生成 \(c\):是因为不想让 \(c\) 的学习能力太强,而是要让 \(\sigma\) 的学习能力更强。在位置编码时,对于 \(xyz\) 取 \(L=10\),维度很大;但对于 \(c\) 取 \(L=4\),维度并不大,所以不让颜色学到很高频的信息。
在 NeRF++ 采样时,离得越近 \(r=1\),离得越远 \(r=0\)。在对单位球体外部均匀采样时,离得越近的采样点之间距离越近,离得越远的采样点之间距离越远,这也符合作者「远处物体越稀疏」的假设。
Mip-NeRF 360
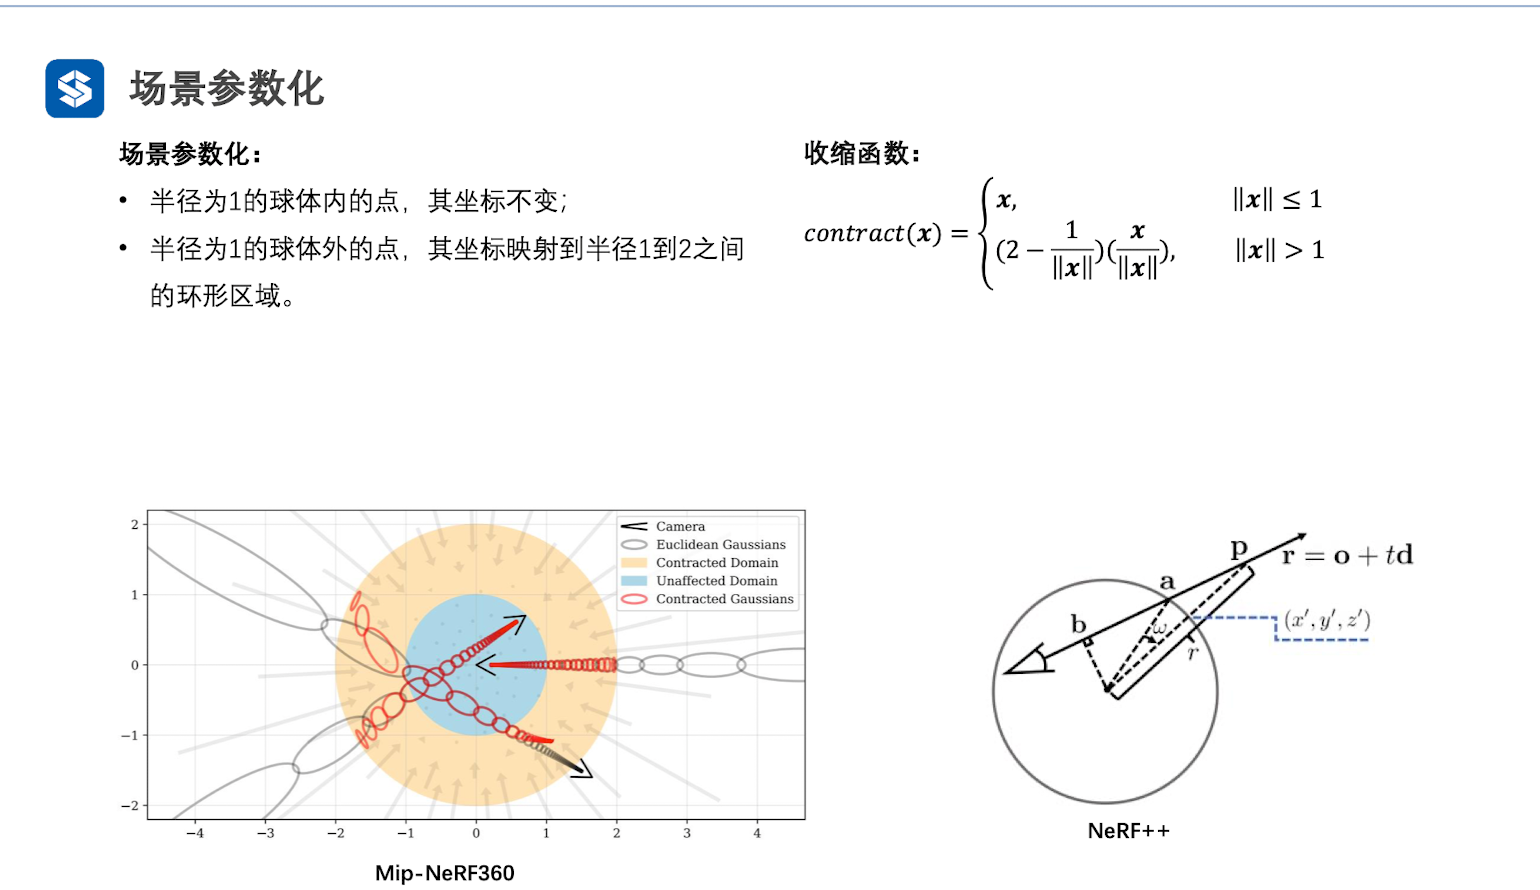
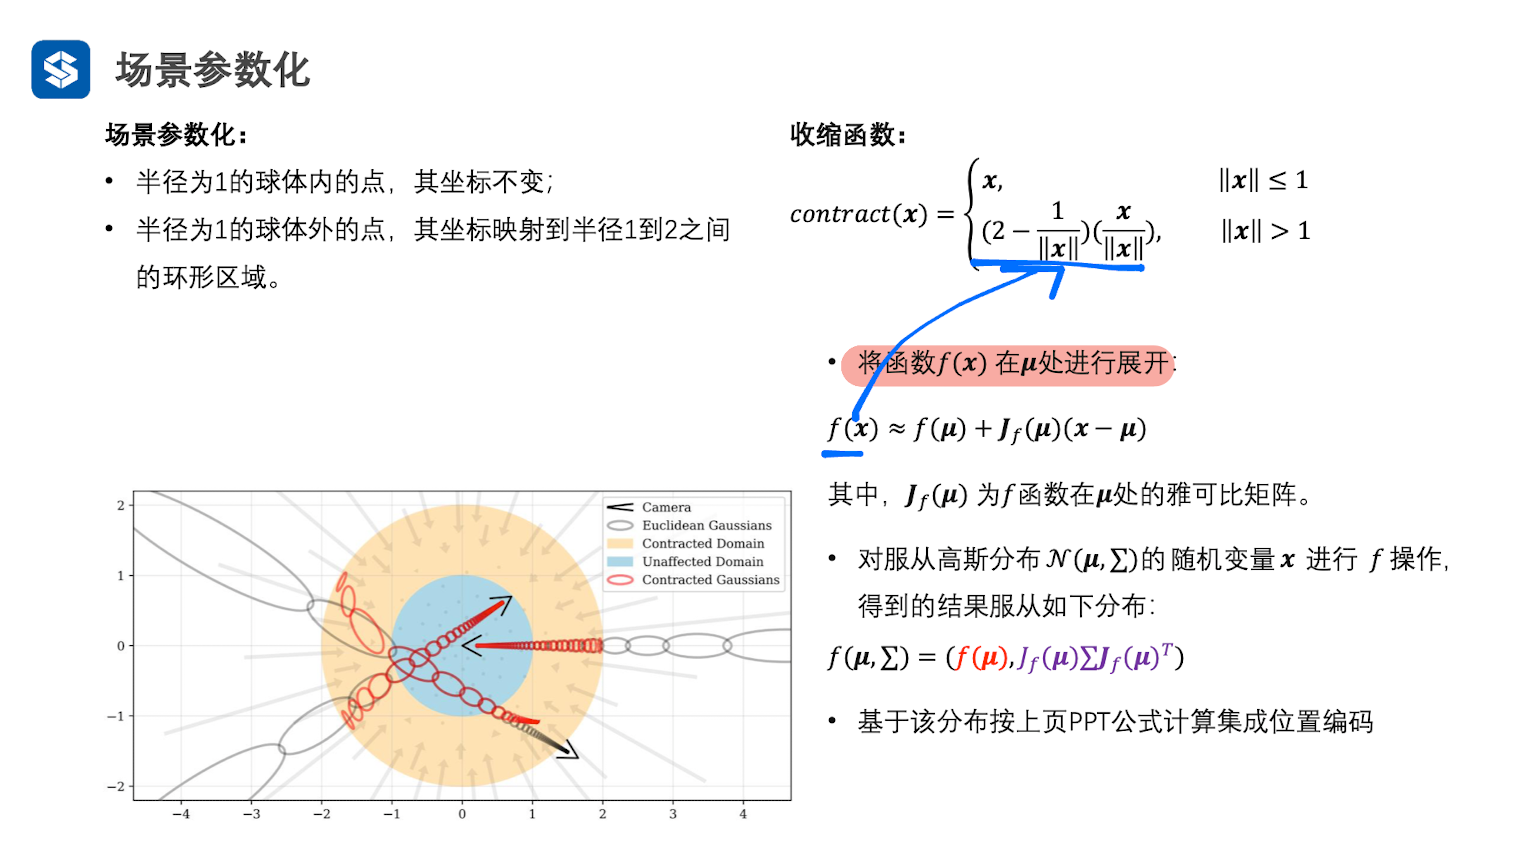
改进:相比于 NeRF++,维度依然是 3 维,不用单独再用其他网络进行学习。