Chapter 2: SVD 与伪逆
- The first \(R\) columns of \(V\) span an \(R\)-dimensional vector space called the row space.
- The first \(R\) columns of \(U\) span an \(R\)-dimensional vector space called the column space.
- 二者通过下式联系:
\[ Av_i = w_iu_i,\qquad A^Tu_i = w_iv_i,\qquad i = 1\ldots R \]
- 剩下的 \(M - R\) 个 \(V\) 的列向量张成零空间 \(\operatorname{Null}(A)\),或核 \(\ker(A)\)。对任意 \(x_\bot \in \operatorname{Null}(A)\),有 \(Ax_\bot = 0\)。
- 剩下的 \(N - R\) 个 \(U\) 的列向量张成 range complement \(\operatorname{range}_\bot(A)\),或余核(co-kernel)。对任意 \(b_\bot \in \operatorname{range}_\bot(A)\),不存在 \(x\) 使得 \(Ax = b_\bot\)。
SVD
\[ A = U\,W\,V^T \]
对满秩矩阵,其逆可以直接写出:
\[ A^{-1} = VW^{-1}U^T \]
其中 \(W^{-1}\) 是对角矩阵,元素为 \(\dfrac{1}{w_i},\ i = 1\ldots R\)。
任意矩阵都可以计算它的 Moore–Penrose 伪逆:
\[ A^\dagger = VW^\dagger U^T = \sum_{i=1}^R \frac{v_iu_i^T}{w_i} \]
Chapter 3: 正则化
Fredholm 积分方程
\[ g(x) = Af = \int_0^1 h(x - x')f(x')\,\mathrm{d}x' \]
其中核 \(h(x)\) 是一个模糊函数,也叫点扩散函数(Point Spread Function, PSF)。这里取为高斯:
\[ h(x) = \frac{1}{\sqrt{2\pi\sigma^2}}\exp\left[-\frac{x^2}{2\sigma^2}\right] \]
数据被随机测量噪声污染:
\[ \tilde{g}(x) = Af + \eta \]
我们要解的逆问题是:给定 \(\tilde{g}\) 求 \(f\)。
在离散设定下,\(A\) 可以近似为
\[ A_{ij} = \frac{\Delta x}{\sqrt{2\pi\sigma^2}}\exp\left[-\frac{((i - j)\Delta x)^2}{2\sigma^2}\right], \qquad i,j \in [1\ldots n] \]
其中 \(\Delta x = 1/n\) 是离散化步长。
由于 \(A\) 是满秩的,看起来可以直接用 \(A^{-1}\)(或伪逆)求解。
然而奇异谱是指数衰减的,在噪声存在下直接求逆会把噪声放大到不可用——所以这样做是错的。
解法一:构造正则化的逆
与直接用伪逆不同,我们构造一个正则化的逆:把伪逆中的 \(1/w_i\) 换成一个受滤波器调制的版本
\[ A^\dagger_\alpha = VW^\dagger_\alpha U^T = \sum_{i=1}^R q_\alpha(w_i^2)\,\frac{v_iu_i^T}{w_i} \]
其中 \(q_\alpha(w_i^2)\) 是作用在 SVD 谱上的滤波器。
1. Truncated SVD
\[ q_\alpha(w_i^2) = \begin{cases} 1 & \text{if } i \leq \alpha \\ 0 & \text{if } i > \alpha \end{cases} \]
2. Tikhonov filtering
\[ q_\alpha(w_i^2) = \frac{w_i^2}{w_i^2 + \alpha} \]
\(\alpha\) 越大平滑效果越强;\(\alpha\) 越小恢复的函数细节越多,但代价是噪声增加。
Zero-order Tikhonov filtering
\[ f^\dagger_\alpha = A^\dagger_\alpha \tilde{g} = (A^TA + \alpha I)^{-1} A^T\tilde{g} \]
其中:
- \(A^T\tilde{g}\) 是一个 back projection
- \((A^TA + \alpha I)^{-1}\) 是一个 image filter
上式等价于下面这个无约束优化问题:
\[ f^\dagger_\alpha = \arg\min_{f \in \mathbb{R}^n}\left[\phi = \frac{1}{2}\|\tilde{g} - Af\|^2 + \frac{\alpha}{2}\|f\|^2\right] \]
如果换成更一般的数据项和正则项,就得到通用形式:
\[ f^\dagger_\alpha = \arg\min_{f \in \mathbb{R}^n}\big[\phi = \mathcal{D}(\tilde{g},Af) + \alpha\Psi(f)\big] \]
General-order Tikhonov filtering
\[ \Psi(f) = \frac{1}{2}\|\mathbf{f}\|^2_{\Gamma} = \frac{1}{2}\mathbf{f}^T\Gamma\mathbf{f} \]
于是
\[ \begin{aligned} A^\dagger_\alpha &= (A^TA + \alpha \Gamma)^{-1}A^T \qquad \text{(regularised inverse)}\\ f^\dagger_\alpha &= A^\dagger_\alpha \tilde{g} = (A^TA + \alpha \Gamma)^{-1} A^T\tilde{g} \end{aligned} \]
方法一:Zero-order Tikhonov,即 \(\Gamma = \mathbf{I}\)。在 Fourier 域中:
\[ \hat{F}_\alpha(k) = \hat{G}(k)\,\frac{\hat{H}(k)}{|\hat{H}(k)|^2+\alpha} \]
方法二:First-order Tikhonov
\[ \begin{aligned} &\Psi(f) = \frac{1}{2}\left\|\frac{\mathrm{d}\mathbf{f}}{\mathrm{d}x}\right\|^2 = \frac{1}{2}\|D\mathbf{f}\|^2 = \frac{1}{2}\mathbf{f}^TD^TD\mathbf{f} = \frac{1}{2}\mathbf{f}^T\Gamma\mathbf{f} \\ &\text{with}\quad \Gamma=\mathbf{D}^T \mathbf{D} \\ &\text{as}\quad \mathbf{D} = \nabla,\ \Gamma = -\nabla^2 \end{aligned} \]
在 Fourier 域中等价于
\[ \hat{F}_\alpha(k) = \hat{G}(k)\,\frac{\hat{H}(k)}{|\hat{H}(k)|^2+\alpha k^2} \]
正则化参数的选取
通常被看作「恢复正确解的精度」与「拟合数据的精度」之间的权衡。
- Estimation error:\(\mathbf{e}_\alpha = \mathbf{f}_{true} - \mathbf{f}^\dagger_\alpha\)
- Data residual:\(\mathbf{r}_\alpha = \tilde{g} - A\mathbf{f}^\dagger_\alpha\)
- Predictive error:\(\mathbf{p}_\alpha = A\mathbf{e}_\alpha = A\mathbf{f}_{true} - A\mathbf{f}^\dagger_\alpha\)
1. Discrepancy Principle
这个方法假设残差的范数应当等于噪声范数的期望值:
\[ \|\mathbf{r}_\alpha\|^2 = \mathbb{E}\big(\|\eta\|^2\big) = n\sigma^2 \]
其中 \(n\) 是数据向量的长度。于是求解下面的非线性方程,即让不一致性函数 \(DP(\alpha)\) 等于 0:
\[ DP(\alpha) = \frac{1}{n}\|\mathbf{r}_\alpha\|^2 - \sigma^2 = 0 \]
如果 \(\eta \sim N(0,C)\),则 \(DP\) 也可以写成下式(其中 \(\Gamma = C^{-1}\)),这一步也称为 pre-whitening:
\[ \|\mathbf{r}_\alpha\|_\Gamma^2=\mathbb{E}\big(\|\eta\|_\Gamma^2\big)=1 \]
有时也可以用 SVD 来得到 \(DP(\alpha)\):
\[ \begin{aligned} &\mathbf{r}_\alpha=\left(UWW_\alpha^\dagger U^\mathrm{T}-\mathbf{I}\right)\tilde{g}\\ &DP(\alpha)=\frac{1}{n}\sum_{i=1}^n\left(q_\alpha(w_i^2)-1\right)^2(u_i\cdot\tilde{g})^2-\sigma^2 \end{aligned} \]
2. Miller Criteria
\[ \operatorname{Miller}(\alpha)=\frac{1}{2}\left[\frac{\|\mathbf{r}_\alpha\|^2}{\sigma^2}-\Psi(f_\alpha^\dagger)\right]\to 0 \]
3. UPRE(Unbiased Predictive Risk Estimator)
无偏地估计 predictive risk,取使其最小的 \(\alpha\):
\[ \operatorname{UPRE}(\alpha)=\frac{1}{n}\|\mathbf{r}_\alpha\|^2+\frac{2\sigma^2}{n}\operatorname{trace}\big(AA^\dagger_\alpha\big)-\sigma^2 \]
4. GCV(Generalized Cross Validation)
不需要预先知道噪声水平 \(\sigma\),取使下式最小的 \(\alpha\):
\[ \operatorname{GCV}(\alpha)=\frac{n\,\|\mathbf{r}_\alpha\|^2}{\big[\operatorname{trace}\big(\mathbf{I}-AA^\dagger_\alpha\big)\big]^2} \]
5. L-curve
画 \(\log(\|\mathbf{r}_\alpha\|^2)\) 对 \(\log(\Psi(f_\alpha^\dagger))\) 的图,然后找拐点。
Chapter 4: 迭代法
Motivation:当问题维度变大时,SVD 就不再是一个实用的工具,而直接对 \(A\) 求逆往往是不可能的。
为什么下面用的都是 \(A^TA\) 而不是 \(A\):因为 \(A\) 不一定对称正定(它甚至常常不是方阵),而共轭梯度法要求矩阵对称正定,所以改用 \(A^TA\)——它总是对称半正定的。
我们要最小化
\[ \Phi(\mathbf{f},\mathbf{g}) = \frac{1}{2}\|A\mathbf{f} - \mathbf{g}\|^2 \]
(这里的 f 就相当于其他材料中的变量
x。)也就是处理正规方程 \(A^TA\mathbf{f} =
A^T\mathbf{g}\),而不是直接处理 \(A\mathbf{f} = \mathbf{g}\)。
方法一:Steepest Descent
迭代公式:\(\mathbf{f}_{k+1} = \mathbf{f}_k + \tau \mathbf{r}_k\)。
由
\[ \Phi(\mathbf{f},\mathbf{g}) = \frac{1}{2}\|A\mathbf{f} - \mathbf{g}\|^2 = \frac{1}{2}\langle A^TA\mathbf{f},\mathbf{f}\rangle - \langle A^T\mathbf{g},\mathbf{f}\rangle + \frac{1}{2}\|\mathbf{g}\|^2 \]
- 方向(负梯度):\(-\nabla_\mathbf{f}\Phi = -(A^TA\mathbf{f} - A^T\mathbf{g})\),所以 \(\mathbf{r} = A^T(\mathbf{g} - A\mathbf{f})\)
- 步长(由精确一维线搜索得到):\(\tau = \dfrac{\|\mathbf{r}_k\|^2}{\|A\mathbf{r}_k\|^2}\)
- 由上式可得 \(\mathbf{r}_{k+1} = \mathbf{r}_k - \tau_kA^TA\mathbf{r}_k\)
- 于是 \(\langle\mathbf{r}_{k+1}, \mathbf{r}_k\rangle = 0\),即相邻的搜索方向互相正交
方法二:Conjugate Gradient
先定义:若 \(p_i^TAp_j=0\)(这里实际是 \(p_i^TA^TAp_j=0\)),则称这两个向量关于矩阵 \(A\) 共轭。
Pipeline:
\[ \begin{aligned} \alpha_k& \leftarrow\frac{\mathbf{r}_k^T\mathbf{r}_k}{\langle p_k,\,A^TAp_k\rangle} &&\text{(步长)} \\ \mathbf{f}_{k+1}& \leftarrow \mathbf{f}_k+\alpha_k p_k &&\text{(更新解)} \\ \mathbf{r}_{k+1}& \leftarrow \mathbf{r}_k - \alpha_k A^TAp_k &&\text{(更新残差)}\\ \beta_{k+1}& \leftarrow\frac{\mathbf{r}_{k+1}^T\mathbf{r}_{k+1}}{\mathbf{r}_k^T\mathbf{r}_k} &&\text{(共轭系数)} \\ p_{k+1} & \leftarrow \mathbf{r}_{k+1} + \beta_{k+1}p_k &&\text{(新的共轭方向)} \end{aligned} \]
Krylov subspace:
对于 \(A\mathbf{f} = \mathbf{g}\):
\[ \mathcal{K}_n(A,\mathbf{g})=\operatorname{span}\{\mathbf{g},A\mathbf{g},A^2\mathbf{g},\ldots,A^{n-1}\mathbf{g}\} \]
对于 \(A^TA\mathbf{f} = A^T\mathbf{g}\):
\[ \mathcal{K}_n(A^TA,A^T\mathbf{g})=\operatorname{span}\big\{A^T\mathbf{g},\,A^TA\,A^T\mathbf{g},\,\ldots,\,(A^TA)^{n-1}A^T\mathbf{g}\big\} \]
对于迭代算法来说,早停本身就是一种正则化技术。
Preconditioned Conjugate Gradient(预处理共轭梯度法)
为了加速共轭梯度算法。假设需要求 \(Ax = b\),预处理共轭梯度法的思路是求解 \(\tilde{A}\tilde{x} = \tilde{b}\),其中
\[ \tilde{A} = C^{-1}AC^{-1},\qquad \tilde{x} = Cx,\qquad \tilde{b} = C^{-1}b \]
\(C\) 为对称正定矩阵,选取它使 \(\tilde A\) 尽量接近单位矩阵。
LSQR
对于逆问题,最合适的求解器是 LSQR:
\[ \begin{aligned} \mathbf{f}_{\alpha,L} &= \arg \min_{\mathbf{f}} \left[ \Phi = \left\| \begin{pmatrix} A \\ \sqrt{\alpha}L \end{pmatrix} \mathbf{f} - \begin{pmatrix} \mathbf{g} \\ 0 \end{pmatrix}\right\|^2 \right] \\ &= \arg \min_{\mathbf{f}}\left[\|\mathbf{g} - A\mathbf{f}\|^2 + \alpha\|L\mathbf{f}\|^2\right] \end{aligned} \]
Chapter 5: 非线性正则化与 PDE
为什么用 Aᵀ
首先,\(A\) 是一个线性映射(或线性算子),把参数空间 \(f\) 映射到数据空间 \(g\),即 \(g=Af\)。如果 \(A\) 可逆,那么理论上可以通过 \(A^{-1}\) 直接从 \(g\) 得到 \(f\)。然而在很多实际情况下,特别是在大规模逆问题中,\(A\) 通常不是方阵,或者即使是方阵也可能不可逆(系统可能是超定或欠定的),因此直接计算 \(A^{-1}\) 并不可行。
在这些情况下,\(A^T\)(\(A\) 的转置或伴随)扮演了重要角色。对于最小二乘问题,我们关心的是找到一个解 \(f\),它在某种意义上最接近真实解(即最小化 \(\|Af-g\|_2^2\))。在这个框架下,\(A^T\) 不是用来直接「逆转」映射 \(Af=g\),而是用来构造优化问题的梯度,从而指导如何调整 \(f\) 以减少残差。
直观上,\(A^T\) 起到了把残差 \(g-Af\)(数据空间中的向量)「投影」回参数空间的作用:在计算梯度时,\(A^T\) 把数据空间中的信息(模型输出与实际观测之间的差异)转换为对参数 \(f\) 的调整指南。也就是说,\(A^T\) 告诉我们如何根据数据拟合项的梯度在参数空间中移动,以改进模型的拟合度。
更准确地说,\(A^T\) 不是直接把残差投影回参数空间,而是间接地起一个指导作用。这种方法在处理大规模和/或病态问题时尤为关键,因为它允许我们通过迭代方法逼近问题的解,而无需直接求解可能非常复杂或不稳定的逆问题。
目标函数的梯度
\[ \frac{\partial\Phi(f,g)}{\partial\boldsymbol{f}} =\frac{\partial\mathcal{D}(\boldsymbol{f},\boldsymbol{g})}{\partial\boldsymbol{f}} +\alpha\frac{\partial\Psi(\boldsymbol{f})}{\partial\boldsymbol{f}} \]
右边第一项是 gradient of data fit,第二项是 gradient of prior,也就是正则化项,用于引入先验知识或额外约束。
对于最小二乘拟合:\(\mathcal{D}(\mathbf{f},\mathbf{g}) = \frac{1}{2}\|\mathbf{g} - A\mathbf{f}\|^2\)。
Example 1:Zero-order Tikhonov
\[ \Psi(f)=\frac{1}{2}\|f\|^2=\frac{1}{2}f^\mathrm{T}f \quad\Leftrightarrow\quad \frac{\partial\Psi(f)}{\partial f}=f \]
Example 2:Generalized Tikhonov
\[ \Psi(f)=\frac{1}{2}\|f\|_{\mathbb{C}^{-1}}^2=\frac{1}{2}f^{\mathrm{T}}\mathbb{C}^{-1}f \quad\Leftrightarrow\quad \frac{\partial\Psi(f)}{\partial f}=\mathbb{C}^{-1}f \]
Example 3:同 Example 2,但均值非零
\[ \Psi(f)=\frac{1}{2}\|f-f_\#\|_{\mathbb{C}^{-1}}^2=\frac{1}{2}(f-f_\#)^{\mathrm{T}}\mathbb{C}^{-1}(f-f_\#) \quad\Leftrightarrow\quad \frac{\partial\Psi(f)}{\partial f}=\mathbb{C}^{-1}(f-f_\#) \]
图像正则项
图像重建和图像处理中常用的一类泛函定义为
\[ \Psi(f) = \int_\Omega \psi(|\nabla f|)\,\mathrm{d}x \]
常用的图像正则项(都是凸的):
- Total Variation:\(\psi(s) = s\)
- Smoothed Total Variation:\(\psi(s) = T\sqrt{s^2+T^2} - T^2\),其中 \(T\) 是阈值
- Perona-Malik:\(\psi(s) = \dfrac{T^2}{2}\log\left(1+ \left(\dfrac{s}{T}\right)^2\right)\),其中 \(T\) 是阈值
- Huber:
\[ \psi(s)=\begin{cases}Ts-\dfrac{T^2}{2}&s>T\\[6pt]\dfrac{s^2}{2}&s\leq T\end{cases} \]
Gâteaux 导数
\[ \Psi^{\prime}(f)h:=\lim_{\epsilon\to0}\left[\frac{\Psi(f+\epsilon h)-\Psi(f)}{\epsilon}\right] \]
当我们讨论表达式 \(\Psi^{\prime}(f)h\) 时,是在计算泛函 \(\Psi\) 在 \(f\) 点的 Gâteaux 导数 \(\Psi^{\prime}(f)\),并把这个导数作用于方向函数 \(h\)。这个操作给出了泛函 \(\Psi\) 在 \(f\) 点沿 \(h\) 方向的变化率。
如果 \(\Psi^{\prime}(f)\) 不依赖于 \(h\),则它是泛函 \(\Psi\) 的 Fréchet 导数。
定义
\[ \kappa:=\frac{\psi^{\prime}\left(\left|\nabla f\right|\right)}{\left|\nabla f\right|} \]
于是(对第二个等号用了分部积分)
\[ \Psi^{\prime}(f)h=\int_\Omega\kappa\,\nabla f\cdot\nabla h\,\mathrm{d}x =-\int_\Omega h\,\nabla\cdot\kappa\nabla f\,\mathrm{d}x \]
再定义算子
\[ \mathcal{L}(f)=-\nabla\cdot\kappa\nabla \]
就有
\[ \Psi^{\prime}(f)h=\int_\Omega h\,\mathcal{L}(f)f\,\mathrm{d}x =\langle h,\mathcal{L}(f)f\rangle =\langle h,\delta\Psi\rangle \]
- \(\mathcal{L}(f)\) 是一个线性算子,但由于函数 \(\kappa\) 的存在,它以 \(f\) 为参数。
- \(\Psi^{\prime}(f)\) 不依赖于 \(h\),它是一个以 \(\delta\Psi\) 为核函数的线性积分算子。
各正则项对应的 \(\kappa\):
Total Variation
\[ \psi(s)=s,\quad\psi^{\prime}(s)=1,\quad\kappa=\frac{1}{|\nabla f|} \]
Smoothed Total Variation
\[ \psi(s)=T\sqrt{s^2+T^2}-T^2,\quad \psi^{\prime}(s)=\frac{sT}{\sqrt{s^2+T^2}} \Leftrightarrow \kappa=\frac{T}{\sqrt{|\nabla f|^2+T^2}}=\frac{1}{\sqrt{1+\left(\frac{|\nabla f|}{T}\right)^2}} \]
Perona-Malik
\[ \psi(s)=\frac{T^2}{2}\log\left(1+\left(\frac{s}{T}\right)^2\right),\quad \psi^{\prime}(s)=\frac{sT^2}{T^2+s^2},\quad \kappa=\frac{T^2}{T^2+|\nabla f|^2} \]
Huber
\[ \psi^{\prime}(s)=\begin{cases}T&s>T\\s&s\leq T\end{cases} \Leftrightarrow \kappa=\begin{cases}\dfrac{T}{|\nabla f|}&|\nabla f|>T\\[6pt]1&|\nabla f|\leq T\end{cases} \]
从梯度下降到 PDE
梯度下降方程:
\[ \frac{f^{(n+1)}-f^{(n)}}{\tau}=-\nabla_f\Psi(f)\big|_{f=f^{(n)}}=-\mathcal{L}(f)f \]
对应的偏微分方程(PDE):
\[ \left[\frac{\partial}{\partial t}+\mathcal{L}\right]f(x,t)=0 \]
可以用 Green's operator 求解:
\[ (\mathcal{G}f)(x,t):=\int_{\Omega}G(x,x^{\prime},t,t^{\prime})f(x^{\prime},t^{\prime})\,\mathrm{d}^nx^{\prime}\,\mathrm{d}t^{\prime} \]
其中 \(G(x,x^{\prime},t,t^{\prime})\) 是 \(\mathcal{L}\) 的 Green's function(配合适当的边界条件),满足
\[ \left[\frac{\partial}{\partial t}+\mathcal{L}\right]G(x,x^{\prime},t,t^{\prime})=\delta(x,x^{\prime},t,t^{\prime}) \]
- \(\mathcal{G}f\) 表示通过 Green's 函数 \(G\) 作用于函数 \(f\) 的结果,\(\mathcal{G}\) 是一个算子。
- \(\mathrm{d}^nx^{\prime}\) 表示对 \(x^{\prime}\) 进行 \(n\) 维空间积分,其中 \(n\) 是空间维度;如果 \(x'=(x_1',x_2',\ldots,x_n')\),那么它等于 \(\mathrm{d}x_1^{\prime}\mathrm{d}x_2^{\prime}\ldots\mathrm{d}x_n^{\prime}\)。
对于任意非齐次 PDE
\[ \left[\frac{\partial}{\partial t}+\mathcal{L}\right]f(x,t)=q(x,t) \]
其解为
\[ \mathbf{f} = \mathcal{G}q \]
热扩散与高斯平滑的等价性
把图像 \(f_0\) 作为初始条件,按热方程演化到时间 \(t=\frac{\sigma^2}{2}\) 得到的结果,与直接用标准差为 \(\sigma\) 的高斯核对 \(f_0\) 做卷积得到的结果是相同的。这揭示了高斯平滑的物理含义——它等价于图像在一定时间内的热扩散过程。
Explicit Method
\[ \mathbf{f}^{(n+1)} = \big[I + \Delta t\,K\big] \mathbf{f}^{(n)} \]
\[ K_{i,j}= \begin{cases} \kappa_{i,j-\frac12}&j=i-N\\ \kappa_{i-\frac12,j}&j=i-1\\ -\left(\kappa_{i+\frac12,j}+\kappa_{i-\frac12,j}+\kappa_{i,j+\frac12}+\kappa_{i,j-\frac12}\right)&i=j\\ \kappa_{i+\frac12,j}&j=i+1\\ \kappa_{i,j+\frac12}&j=i+N \end{cases} \]
Implicit Method
\[ \mathbf{f}^{(n)} = \big[I - \Delta t\,K\big] \mathbf{f}^{(n+1)} \]
Alternating Direction Implicit(ADI)与半隐式方法
上面的 \(K\) 可以拆成 \(K = K^{(x)} + K^{(y)}\),其中
\[ K_{i,j}^{(x)}=\begin{cases}\kappa_{i-\frac12,j}&j=i-1\\-\left(\kappa_{i+\frac12,j}+\kappa_{i-\frac12,j}\right)&i=j\\\kappa_{i+\frac12,j}&j=i+1\end{cases} \qquad K_{i,j}^{(y)}=\begin{cases}\kappa_{i,j-\frac12}&j=i-N\\-\left(\kappa_{i,j+\frac12}+\kappa_{i,j-\frac12}\right)&i=j\\\kappa_{i,j+\frac12}&j=i+N\end{cases} \]
于是 ADI 格式为
\[ \begin{aligned} \left[I-\frac{\Delta t}{2}K^{(x)}\right]f^{(n+\frac12)}&=\left[I+\frac{\Delta t}{2}K^{(y)}\right]f^{(n)}\\ \left[I-\frac{\Delta t}{2}K^{(y)}\right]f^{(n+1)}&=\left[I+\frac{\Delta t}{2}K^{(x)}\right]f^{(n+\frac12)} \end{aligned} \]
Bayesian 视角
在 Bayesian 设定下,惩罚函数 \(\Psi(f)\) 是某个概率分布的负对数:
\[ P(f) \propto \mathrm{e}^{-\Psi(f)} \]
Chapter 6: 去噪与二阶方法
去噪问题
\[ \begin{aligned} f_{\mathrm{recon}}&=\arg\min_f\left[\Phi(f,g)=\frac{1}{2}\|g-Af\|^2+\alpha\Psi(f)\right] \\ &=\arg\min_f\left[\Phi(f,g)=\frac{1}{2}\|g-f\|^2+\alpha\Psi(f)\right] \end{aligned} \]
这是一个 forward mapping 为 \(A = I\) 的逆问题。
用梯度
\[ \frac{\partial\Phi}{\partial f}=-A^T\left(g-Af\right)+\alpha\mathcal{L}(f)f \]
可得
\[ \mathbf{f}^{(n+1)} = \mathbf{f}^{(n)} + \tau\left(A^T\mathbf{g} - A^TA\mathbf{f}^{(n)} - \alpha\mathcal{L}(\mathbf{f}^{(n)})\mathbf{f}^{(n)}\right) \]
这对应于求解抛物型 PDE 的显式(前向差分)格式。
也可以使用隐式(后向差分)格式:
\[ \mathbf{f}^{(n+1)} = \mathbf{f}^{(n)} + \tau\left(A^T\mathbf{g} - A^TA\mathbf{f}^{(n+1)} - \alpha\mathcal{L}(\mathbf{f}^{(n)})\mathbf{f}^{(n+1)}\right) \]
由于无法使用 \(\mathcal{L}(\mathbf{f}^{(n+1)})\)(它依赖于还没算出来的量),只能仍用 \(\mathcal{L}(\mathbf{f}^{(n)})\),所以上面这个方法叫做 Lagged Diffusivity Implicit Method。
二阶方法(牛顿法)
\[ \Phi(f+h,g)\simeq\Phi(f,g)+\langle\Phi^{\prime}(f,g),h\rangle+\frac{1}{2}\left\langle h,\Phi^{\prime\prime}(f,g)h\right\rangle \]
更新规则:
\[ \mathbf{f}^{(n+1)} = \mathbf{f}^{(n)} + h \]
其中 \(h\) 同时包含步长和方向,由下式解出:
\[ \Phi^{\prime\prime}(f^{(n)},g)\,h=-\Phi^{\prime}(f^{(n)},g) \]
这等价于其他材料中常写的
\[ h = -\left(\nabla^2\Phi_n\right)^{-1}\nabla\Phi_n \]
在当前问题中已经有
\[ \Phi^{\prime}(f^{(n)},g)=\frac{\partial\Phi}{\partial f}=-\left(g-f^{(n)}\right)+\alpha\mathcal{L}(f^{(n)})f^{(n)} \]
\[ \Phi^{\prime\prime}(f^{(n)},g)=\frac{\partial^2\Phi}{\partial f^2}=I+\alpha\left[\mathcal{L}(f^{(n)})+\mathcal{L}^{\prime}(f^{(n)})f^{(n)}\right] \]
以上称为 Full Newton Method。
Gauss-Newton Method:忽略 \(\mathcal{L}^{\prime}(\mathbf{f}^{(n)})\)。最终的 Lagged Diffusivity Gauss-Newton 方法为
\[ f^{(n+1)}=f^{(n)}-\left(I+\alpha\mathcal{L}(f^{(n)})\right)^{-1}\left[-\left(g-f^{(n)}\right)+\alpha\mathcal{L}(f^{(n)})f^{(n)}\right] \]
Gauss-Newton 法和 Newton 法的区别见《视觉 SLAM 十四讲》第 6 讲。
最后,一个更简单的二阶方法是 Lagged Diffusivity fixed point method:
\[ \left(I+\alpha\mathcal{L}(f^{(n)})\right)f^{(n+1)}=g \]
Chapter 7: Tomography
Tomography 是一种通过在多个角度上获取图像数据,来创建特定平面内或三维体内部详细横断面图像的成像技术。
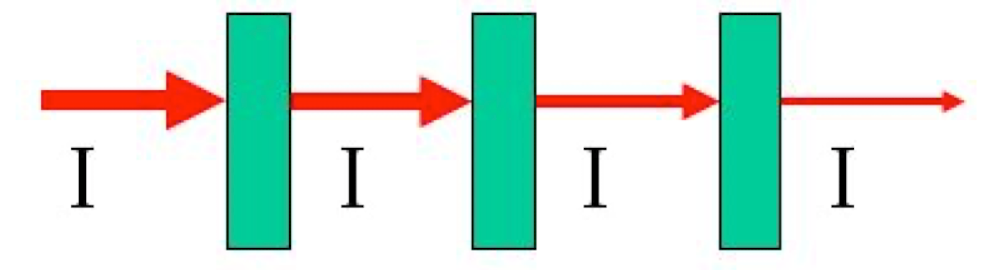
\[ \begin{aligned} &I=I_0\exp(-\mu_{\mathrm{a}}z) \\ \text{取对数:}\quad &A=\log(I_0/I)=\log(1/T)=\mu_{\mathrm{a}}z \end{aligned} \]
其中 \(T\) 称为 transmittance,\(A\) 称为 absorbance,\(\mu_{\mathrm{a}}\) 是一个常数,称为吸收系数(单位 \(\mathrm{mm}^{-1}\)),\(z\) 是厚度。
Beer–Lambert Law:
\[ A=\log(I_0/I)=\epsilon C z \]
其中 \(\epsilon\) 是比消光系数,\(C\) 是浓度。
如果是混合溶液:
\[ A=\underbrace{(\epsilon_1C_1+\epsilon_2C_2+\epsilon_3C_3+\cdots+\epsilon_nC_n)}_{\mu_\mathrm{a}}\,z \]
\(\mu_{\mathrm{a}}\) 可以解释为单个光子在单位长度内被吸收的概率。\(1/\mu_{\mathrm{a}}\) 是「吸收长度」,即光强 \(I\) 衰减到 \(\mathrm{e}^{-1}I_0\) 所需的距离。
如果把 3D 物体的一个切片 \(\mathcal{M}\) 看作 2D 图像,那么可以把 X-Ray 衰减系数看作一个 2D 函数:
\[ f(x,y)\equiv\mu_{\mathrm{a}}\big|_{(x,y)\in\mathcal{M}} \]
一个单一的 X 射线投影图像,是通过在 \(\mathcal{M}\) 平面内沿射线路径积分形成的,产生一行数据。但单一角度的投影通常不足以复原整个 \(f(x,y)\) 函数,即不能提供关于物体内部结构的完整信息。
Radon Transform
2D Radon 变换的前向投影算子是一个积分算子,它把函数 \(f(x,y)\) 映射到函数 \(g(s,\theta)\),做法是沿平行线 \(\mathbf{r} \cdot \hat{n} = s\) 积分(表示直线上所有点在单位法向量上的投影都为 \(s\)),其中 \(\mathbf{r} = \begin{pmatrix}x\\y\end{pmatrix}\):
\[ g=\mathcal{R}_\text{2D}f=g(s,\theta)=\int_{-\infty}^{\infty}\int_{-\infty}^{\infty}f(x,y)\underbrace{\delta\big(s-(y\cos\theta-x\sin\theta)\big)}_{K(x,y,\theta,s)}\,\mathrm{d}x\,\mathrm{d}y =\int_{\mathbf{r}\cdot\hat{n}=s}f(x,y)\,\mathrm{d}\ell \]
其中 \(\hat{\mathbf{n}}=\begin{pmatrix}-\sin\theta\\\cos\theta\end{pmatrix}\) 是垂直于射线方向的单位向量。
Adjoint Radon Transform
在医学成像时,是通过 X 射线穿过人体来实现的。射线穿过人体后会衰减,然后被仪器测量到——也就是说我们已经知道了 Radon 变换的结果,需要通过这个结果还原出射线穿过的人体剖面,这个还原过程被称为 Radon 逆变换。
\[ h=\mathcal{R}_{2\mathrm{D}}^*b = h(x,y)=\int_{-\infty}^\infty\int_0^\pi b(s,\theta)\,\delta\big(s-(y\cos\theta-x\sin\theta)\big)\,\mathrm{d}\theta\,\mathrm{d}s \]
如果对某一固定点的 \(\delta\) 函数(即在二维空间中仅在一个点上有值的函数)做 Radon 变换,它在数据空间中随角度 \(\theta\) 和位置变量 \(s\) 变化的位置会形成一条正弦曲线。
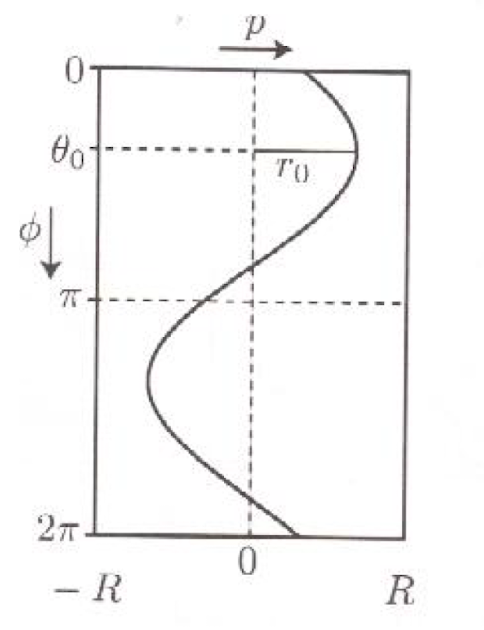
Radon 变换是线性的,这意味着一个复杂物体的 Radon 变换(即其 sinogram)可以看作它所有单独像素点的正弦曲线的叠加。
Central Slice Theorem(CST)
中心切片定理指出:一个函数二维傅里叶变换的一条中心切片,等价于该函数一维 Radon 变换沿 \(s\) 方向的傅里叶变换。
\[ \int_{-\infty}^\infty\mathrm{e}^{-\mathrm{i}ks}\int_{-\infty}^\infty\int_{-\infty}^\infty f(x,y)\,\delta\big(s-(y\cos\theta-x\sin\theta)\big)\,\mathrm{d}x\,\mathrm{d}y\,\mathrm{d}s =\hat{F}(-k\sin\theta,\ k\cos\theta) \]
也就是把 Radon 变换的结果沿 \(s\) 这一维做傅里叶变换。
如果进行逆傅里叶变换:
\[ f(x,y)=\frac{1}{(2\pi)^2}\int_{0}^{\pi}\int_{-\infty}^{\infty}\mathrm{e}^{\mathrm{i}k\boldsymbol{r}\cdot\hat{\mathbf{n}}}\,\mathcal{F}_{1D}\left[\mathcal{R}f(x,y)\right]\,|k|\,\mathrm{d}k\,\mathrm{d}\theta \]
\(k\) 是傅里叶域中的空间频率变量,\(\theta\) 是角度。积分表达式中的 \(|k|\) 是用来修正傅里叶变换幅度的滤波器(ramp filter)。
\[ \mathcal{R}_{2D}^*\mathcal{R}_{2D}f=\int_{-\infty}^\infty\frac{f(r^{\prime})}{|r-r^{\prime}|}\,\mathrm{d}r^{\prime} \]
这个方程的左边 \(\mathcal{R}_{2D}^*\mathcal{R}_{2D}f\) 表示对函数 \(f(r^{\prime})\) 先做 Radon 变换再做反投影,在数学上等同于把 \(f(r^{\prime})\) 与某个核函数卷积。
总体来说,这个卷积操作的结果不是原始的函数 \(f\),而是一个模糊了的版本,需要用一个滤波器来补偿这个损失。
Pipeline(Filtered Back Projection)
- 从物体的多个角度收集 X 射线投影(Radon 变换 \(\mathcal{R}(\theta,s)\)),对每个角度的投影做一维傅里叶变换。
- 对得到的傅里叶变换应用滤波器 \(|k|\),这个过程在频率域中增强了特定频率的成分。
- 对滤波后的傅里叶变换做逆傅里叶变换,得到滤波后的投影。
- 将滤波后的投影数据进行反投影,以重建原始图像。
Radon 变换可以被分解成一系列正交谐波基函数。通过 SVD,可以鉴定哪些方向的数据对图像重建贡献最大,以及哪些方向可能需要更多的正则化或滤波:
\[ \mathcal{R}_{2D}\,\mathrm{e}^{\mathrm{i}k\cdot r}\ \longrightarrow\ \frac{1}{\sqrt{|k|}}\,\mathrm{e}^{\mathrm{i}ks}\,\delta(\hat{k}\cdot\hat{n}_\perp) \]
这个式子说明:在 Radon 变换下,平面波 \(\mathrm{e}^{\mathrm{i}k\cdot r}\) 的投影可以表达为一个与 \(k\) 相关的振幅因子,乘以一个决定该波在 sinogram 空间中位置的 Dirac \(\delta\) 函数。
Chapter 8: Sparsity
\[ \Psi(f)=\sum_{j=1}^{J}\psi\big(\langle f,\phi_j\rangle\big)=\sum_{j=1}^{J}\psi(c_j) \]
这个公式描述了一个正则化项:把函数 \(f\) 在一组代表性函数 \(\{\phi_j; j=1\ldots J\}\) 上的投影系数 \(c_j\) 代入正则化函数 \(\psi\) 得到。这种形式允许在这组基函数上更灵活地控制正则化的强度。
- 映射 \(T: X \to C\) 被称为分析算子,负责把信号从原始空间转换到系数空间。
- 伴随映射 \(T^*: C\to X\) 被称为综合算子,负责把系数空间的信号重建回原始信号空间。
- 更一般地,如果集合 \(\{\phi_j\}\) 是超完备的,它们被称为构成一个框架(frame),意味着这些函数覆盖了原始信号空间,可能是冗余的,但可以提供一种稳健的信号表示方式。
尽管图像可能包含数百万像素,但它们所包含的有效信息远少于像素数。换句话说,大多数图像可以用更少的参数来紧凑表示,只要找到合适的表示方法。
在这种情况下,我们寻找一个能够有效表示图像的基或字典 \(\{\phi_j\}\),使得图像 \(f\) 可以表达为这些基函数的线性组合,并且大多数系数都是零或接近零。三种常用的稀疏表示方法:
- Total Variation
- Wavelet basis
- Dictionary basis
Total Variation
这种方法侧重于保持图像中的边缘,通过最小化图像的梯度(即变化率)实现。总变分正则化假设图像中非零梯度(边缘)的数量是少的,而平坦区域的梯度接近零。
Regularizer function:
\[ \Psi_{TV}(f)=\int|\nabla f|\,\mathrm{d}x \]
由于梯度在边缘处变化最大,所以总变分正则化主要关注这些边缘区域。在图像去噪或重建中应用 TV 正则化,可以在恢复边缘的同时抑制噪声。
设 \(f\) 是区间 \([a, b]\) 上的实值函数,\(f\) 的总变分记作 \(\mathrm{TV}(f)\):
\[ \mathrm{TV}(f):=\sup\sum_{j=1}^{J}\big|f(x_j)-f(x_{j-1})\big| \]
其中 supremum 取遍区间 \([a,b]\) 的所有划分 \(\{a = x_0 < x_1 < \ldots < x_{J-1} < x_J = b\}\)。
另一个有用的等价表达:
\[ \mathrm{TV}(f):=\sup_{\mathbf{v}\in\mathcal{V}}\int_\Omega f(x,y)\,\nabla\cdot\mathbf{v}\,\mathrm{d}x\,\mathrm{d}y \]
即函数梯度与所有可能的矢量场 \(\mathbf{v}\) 内积的最大值,其中 \(\mathbf{v}\) 的范数不超过 1,并且在单位正方形的边界上消失。
Total Variation 函数是凸的但不光滑。
TV 正则化的约束优化解法
要找到函数 \(f\) 的最优估计 \(f_\alpha^{TV}\):
\[ f_\alpha^{\mathrm{TV}}=\operatorname*{argmin}_f\left[\Phi(\boldsymbol{f}):=\frac{1}{2}\|\boldsymbol{g}^\mathrm{obs}-A\boldsymbol{f}\|^2+\alpha|\mathsf{D}\boldsymbol{f}|\right] \]
(obs 指 observation。)其中 \(\mathsf{D}\) 是离散差分矩阵。由于 \(|\mathsf{D}f|\) 在 \(f\) 的某些点可能不可微,因此引入 \(\mathbf{v}_+\) 和 \(\mathbf{v}_-\) 作为 \(\mathsf{D}f\) 的「分裂」(splitting),其中两者都是正值函数。这个分裂技术允许我们把 \(\mathsf{D}f\) 表示为 \(\mathbf{v}_+ - \mathbf{v}_-\),从而把问题转化为线性问题。于是公式变为
\[ \begin{aligned} f_\alpha^\mathrm{TV}&=\operatorname*{argmin}\left[\frac{1}{2}\|\mathsf{A}f\|^2-\mathsf{f}^\mathrm{T}\mathsf{A}^\mathrm{T}\boldsymbol{g}^\mathrm{obs}+\alpha\mathbf{1}^\mathrm{T}\mathbf{v}_++\alpha\mathbf{1}^\mathrm{T}\mathbf{v}_-\right]\\ \mathrm{subject\ to}\quad &\mathsf{D}f-\mathbf{v}_++\mathbf{v}_-=0 \end{aligned} \]
记
\[ \mathcal{H}=\begin{pmatrix}\mathsf{A}^\mathrm{T}\mathsf{A}&0&0\\0&0&0\\0&0&0\end{pmatrix},\quad \boldsymbol{b}=\begin{pmatrix}-\mathsf{A}^\mathrm{T}\boldsymbol{g}^\mathrm{obs}\\\alpha\boldsymbol{1}\\\alpha\boldsymbol{1}\end{pmatrix},\quad \boldsymbol{h}=\begin{pmatrix}f\\\mathbf{v}_+\\\mathbf{v}_-\end{pmatrix} \]
这样就把上面带约束的问题写成了标准的二次规划形式 \(\frac12\boldsymbol{h}^T\mathcal{H}\boldsymbol{h}+\boldsymbol{b}^T\boldsymbol{h}\)。
Wavelets
小波变换利用具有不同位置和尺度的小波母函数来表示图像,这些函数可以有效地捕捉图像的局部特征(如边缘、纹理等)。小波基通常可以实现非常紧凑的图像表示。
基本思想是采用一个基函数 \(\phi_\mathrm{Mother}(x)\),这个函数在空间域是紧支的;通过对它进行缩放(dilation)和平移(translation),可以生成一个代表性的函数集合。
与傅里叶变换不同,小波变换产生一组多尺度的「平滑」(低分辨率)数据和剩余的「细节」数据。这意味着小波变换能够保留不同尺度上的局部细节,而傅里叶变换只能在全局频域分析信号。
小波变换的截断可以用来去除多个尺度上的非必要细节,同时保留局部细节。这在图像压缩中特别有用,因为它允许我们仅保留图像中最重要的特征,去除不那么重要的信息,从而减少存储和传输所需的数据量。
Dictionary basis
前两种方法用的都是预先给定的表示(TV 的差分算子、小波母函数)。字典学习的想法是:既然不同图像的结构不同,不如从数据里学出一组最适合这类图像的原子。
问题形式
设 \(\boldsymbol{Y} \in \mathbb{R}^{n\times N}\) 的每一列是一个训练信号(实践中是图像的一个 patch),要同时求过完备字典 \(\boldsymbol{D} \in \mathbb{R}^{n\times K}\)(\(K > n\),各列 atom 归一化)和稀疏系数 \(\boldsymbol{X} \in \mathbb{R}^{K\times N}\):
\[ \min_{\boldsymbol{D},\boldsymbol{X}} \|\boldsymbol{Y} - \boldsymbol{D}\boldsymbol{X}\|_F^2 \quad \text{subject to}\quad \|\mathbf{x}_i\|_0 \leq T_0\ \ \forall i \]
这个问题对 \(\boldsymbol{D}\) 和 \(\boldsymbol{X}\) 联合起来是非凸的,因此采用交替最小化:固定 \(\boldsymbol{D}\) 解稀疏编码,固定 \(\boldsymbol{X}\) 更新字典。
稀疏编码阶段
固定 \(\boldsymbol{D}\),对每个信号求稀疏系数。常用求解器:
- OMP / Batch-OMP:贪心,快,最常与 K-SVD 搭配
- Basis Pursuit / LASSO(\(\ell_1\) 松弛):凸,可用 LARS
- Matching Pursuit、IRLS 等
字典更新阶段
MOD(Method of Optimal Directions),Engan et al., 1999:把整个字典当作一个最小二乘问题一次性更新
\[ \boldsymbol{D}^{(k+1)} = \boldsymbol{Y}\boldsymbol{X}^T(\boldsymbol{X}\boldsymbol{X}^T)^{-1} = \boldsymbol{Y}\boldsymbol{X}^{\dagger} \]
瓶颈是那个伪逆,而且更新字典时系数是冻结的,收敛较慢。
K-SVD,Aharon, Elad & Bruckstein, 2006:逐个 atom 更新,同时refine该 atom 的系数。对第 \(k\) 个 atom,先算去掉它贡献后的残差
\[ \boldsymbol{E}_k = \boldsymbol{Y} - \sum_{j\neq k} \mathbf{d}_j \mathbf{x}_j^T \]
为了不破坏稀疏结构,只在该 atom 的支撑集 \(\omega_k = \{i : \mathbf{x}_k^T(i) \neq 0\}\) 上取子矩阵 \(\boldsymbol{E}_k^R\),再做秩一近似:
\[ \boldsymbol{E}_k^R = \boldsymbol{U}\boldsymbol{\Sigma}\boldsymbol{V}^T \quad\Rightarrow\quad \mathbf{d}_k = \mathbf{u}_1,\qquad \mathbf{x}_k^R = \sigma_1\mathbf{v}_1 \]
同时更新 atom 和它的系数,收敛比 MOD 快得多。当 \(T_0 = 1\) 且系数取二值时,K-SVD 退化为 K-means——这也是名字的来源。
变体:Approximate K-SVD(用一步幂迭代代替 SVD)。
用于逆问题
对一般逆问题 \(\mathbf{y} = A\mathbf{x} + \mathbf{n}\),采用 patch 形式(Elad & Aharon, 2006):
\[ \min_{\mathbf{x},\boldsymbol{D},\boldsymbol{\alpha}}\ \lambda\|\mathbf{y} - A\mathbf{x}\|_2^2 + \sum_{ij}\Big(\mu_{ij}\|\boldsymbol{\alpha}_{ij}\|_0 + \|\boldsymbol{D}\boldsymbol{\alpha}_{ij} - R_{ij}\mathbf{x}\|_2^2\Big) \]
其中 \(R_{ij}\) 是提取第 \((i,j)\) 个 patch 的算子。重建时对重叠 patch 的估计取平均。
典型应用:去噪、超分辨(Yang et al., 2010 的耦合字典)、inpainting、压缩感知 MRI(DLMRI, Ravishankar & Bresler, 2011)、低剂量 CT。
与 TV / 小波的对比
| 是否需要学习 | 适应性 | 代价 | |
|---|---|---|---|
| TV | 否 | 只假设梯度稀疏,偏好分片常值(易产生阶梯效应) | 最低 |
| Wavelet | 否 | 固定的多尺度基,对点/边奇异性好 | 低 |
| Dictionary | 是 | 自适应于具体图像类别,稀疏度最高 | 高(需训练,且稀疏编码是 NP 难,只能贪心/松弛) |
延伸方向:Online Dictionary Learning(Mairal et al., 2009)处理大规模数据;卷积字典学习用平移不变模型替代 patch 模型;Transform Learning(Ravishankar & Bresler)用闭式更新绕过 NP 难的稀疏编码;深度展开(LISTA、ADMM-Net、ISTA-Net)把迭代过程展开成网络。
参考:Elad, Sparse and Redundant Representations(Springer, 2010);Rubinstein, Bruckstein & Elad, "Dictionaries for Sparse Representation Modeling", Proc. IEEE 98(6), 2010。