Feat2GS: Probing Visual Foundation Models with Gaussian Splatting
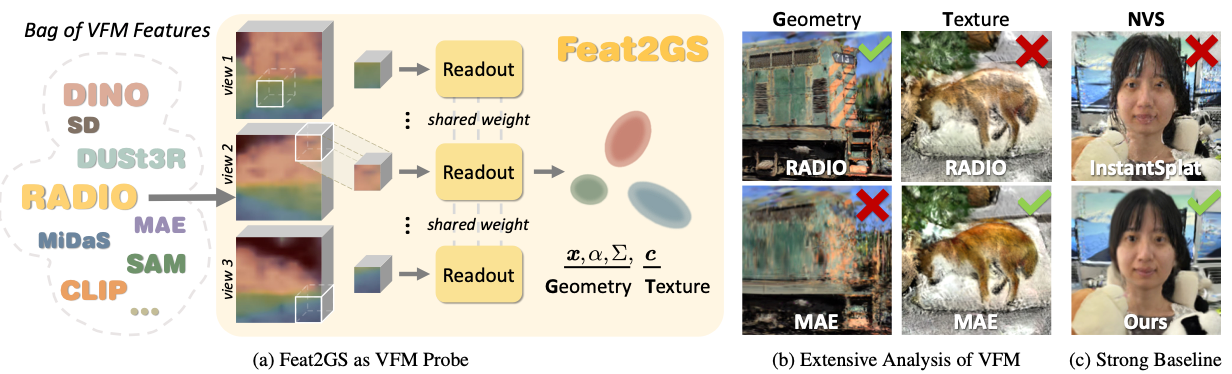
该论文系统地探测了视觉基础模型(VFM)在几何和纹理两个维度上的三维感知能力。以下是主要结论。
1. VFM 在几何上表现良好,但在纹理上存在挑战
几何感知
- 使用 3D 数据训练的模型(如 DUSt3R、MASt3R)表现出优秀的几何感知能力和跨视角一致性。
- 几何感知受监督类型影响很大:用 point map 训练优于用 depth map 训练。
纹理感知
- 纹理感知受限于「专注几何鲁棒性而非保留纹理细节」的不变性训练策略。
- 像 RADIO 这样专注几何感知的 VFM,继承了其源模型(DINO、CLIP)较差的纹理感知。
2. 3D 数据与 point map 对几何感知至关重要
用 3D point map 训练可以在不同视角下产生一致的特征,因为 point map 表示在视角变化时保持不变。而用 2.5D 数据(如 depth map)训练的模型,从不同视角观看时往往产生不一致的特征。
3. 纹理感知受益于掩码图像重建
用掩码图像重建预训练的模型(如 MAE)在纹理相关任务上表现更好;相比之下,用强数据增强(颜色抖动、模糊等)训练的模型效果较差。例如 MAE 在纹理感知上超越了 RADIO 和 DUSt3R,因为它专注于重建原始图像,没有引入破坏纹理的不变性增强。
4. 数据集多样性是全面评估的关键
性能在不同数据集间差异显著,这说明测试多样化数据以避免有偏结论很重要:
- 密集数据集如 LLFF 对 NVS 任务较为容易。
- 具有挑战性的数据集如 Tanks and Temples(T&T)能揭示某些模型的局限性。
5. 特征拼接可提高整体性能
不同 VFM(如 DINOv2 + CLIP + SAM)特征的简单拼接,就可以达到与蒸馏模型(如 RADIO)相当甚至更好的结果。把几何和纹理两种模式下最好的特征组合起来(如 RADIO + MAE + IUVRGB),能在 all-mode 的新视角合成中进一步提升性能。
6. 新视角合成是可靠的三维评估代理
NVS 质量与 accuracy、completeness、distance 等 3D 指标强相关。用 NVS 作为 2D 代理任务,可以在不需要 3D 真值的情况下进行大规模评估。
7. 微调可提高特征性能
在 warm-up 阶段微调 VFM 特征能显著提升 NVS 性能,在纹理度量(如 LPIPS)上尤为明显。
8. VFM 受限于低分辨率特征
从 VFM 提取的低分辨率特征限制了它们在新视角合成中渲染高频细节的能力。特征上采样方法相比微调或换用更高分辨率的特征提取器,带来的改进有限。
9. Gaussian Splatting 避免过拟合
配合轻量级 MLP readout 层的 Gaussian Splatting,在稀疏视角场景下避免了对高频细节的过拟合,因此比 InstantSplat 等方法具有更好的泛化能力。
10. 纹理与几何模式相关但独立
all-mode 在结构一致性指标(PSNR、SSIM)上与几何模式高度相关,在锐度相关指标(LPIPS)上与纹理模式相关。因此纹理和几何应当在照片级真实渲染中分别考虑。
11. RADIO 的蒸馏优于其源模型
RADIO 通过蒸馏 DINOv2、CLIP 和 SAM,实现了最佳的几何感知,但在纹理表示上仍继承了一些局限性。
12. Feat2GS 的局限性
- 依赖无约束立体重建提供的初始相机姿态与点云估计,在严重噪声或大量离群值等极端情况下可能失败。
- 目前仅限于静态场景,在动态或长时序数据集(光照、视角持续变化)上表现不佳。
13. 对未来 VFM 的启示
- 几何感知:利用 3D point map 训练来改善多视角一致性。
- 纹理感知:使用掩码图像重建(如 MAE)预训练以保留高质量纹理特征。
- 特征集成:用拼接或其他融合策略结合多个 VFM 的优势。
Scene Representation Transformer: Geometry-Free Novel View Synthesis Through Set-Latent Scene Representations
Task: Novel View Synthesis
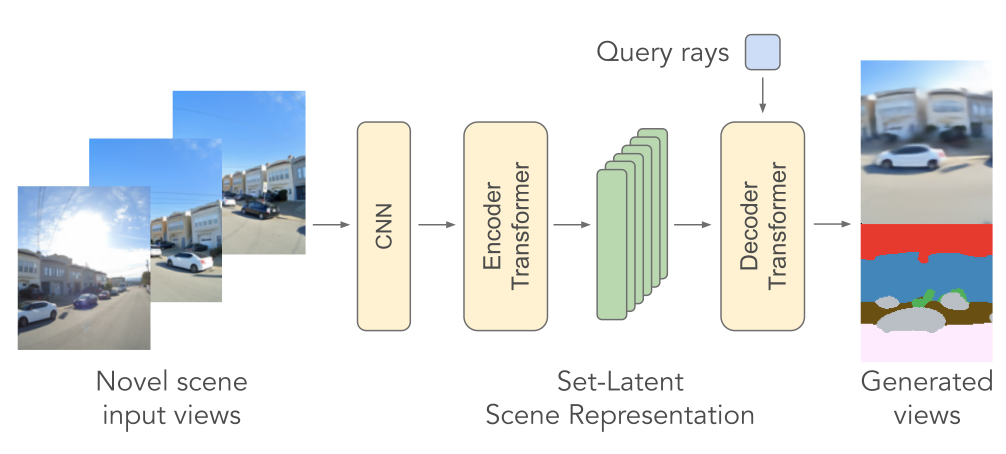
指出 NeRF 的缺点:不同场景之间不共享任何参数,也就是说 NeRF 的所有参数都是 scene-specific 的。
这篇工作使用一个基于 transformer 的 encoder-decoder 模型,学习一个可扩展的隐式表示,并用学习到的 attention 机制替换显式的几何操作。
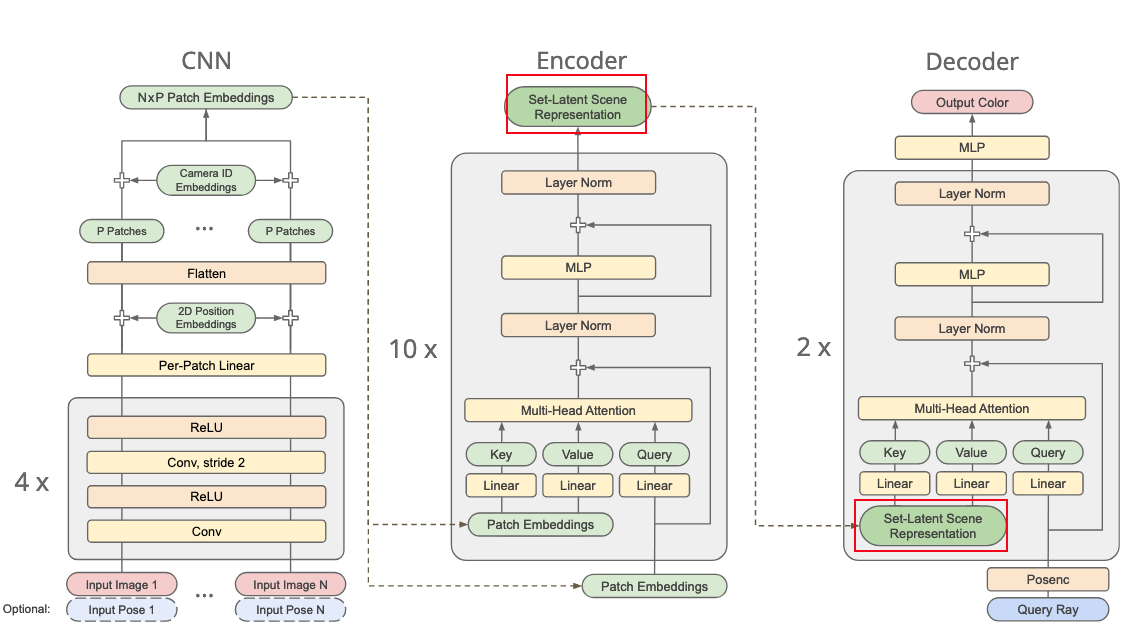
这里的 set-latent scene representation 把一个特定 3D 场景完整编码为「对应图像集合所观测到的样子」,因此称为 set-latent scene representation。