Prompt-to-Prompt Image Editing with Cross Attention Control
Hertz et al., ICLR 2023,arXiv:2208.01626
Motivation
文生图 diffusion model 生成质量很高,但编辑很难:prompt 里改动一个词,或者换一个随机种子,产出的图像就完全变了。而编辑这件事的内在要求恰恰是保留原图的大部分内容。
此前的方法需要用户提供一个 mask 来指定编辑区域,这不仅费力,而且会丢弃 mask 内部原有的结构信息。
这篇工作的核心洞察是:图像的空间布局和几何结构,取决于 text embedding 与图像像素之间的 cross-attention map。因此编辑可以完全在文本空间完成——把原始生成过程的 attention map 注入到新的生成过程中即可,不需要任何 mask。
原理
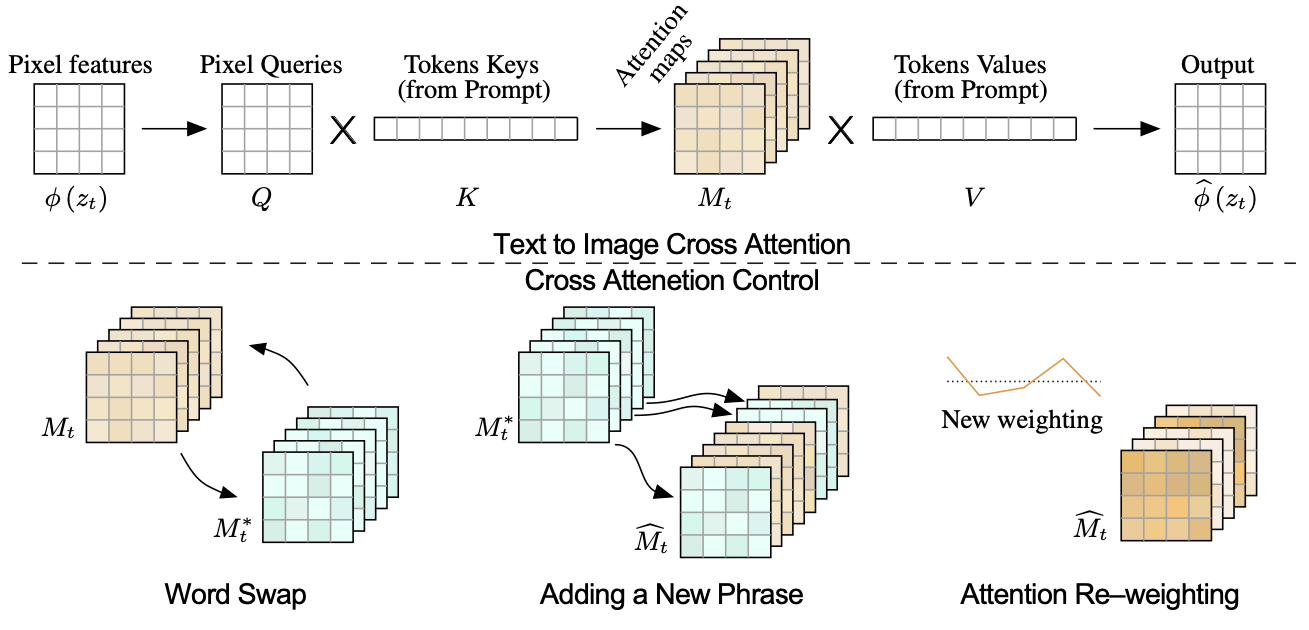
在 text-conditioned 的 diffusion U-Net 中,每个去噪步 \(t\) 的每个 attention 层里,含噪图像特征投影成 query,text embedding 投影成 key 和 value:
\[ Q = \ell_Q(\phi(z_t)),\qquad K = \ell_K(\psi(\mathcal{P})),\qquad V = \ell_V(\psi(\mathcal{P})) \]
\[ M = \operatorname{Softmax}\left(\frac{QK^\top}{\sqrt{d}}\right), \qquad \hat{\phi}(z_t) = MV \]
其中 \(M_{ij}\) 是第 \(j\) 个 token 对第 \(i\) 个像素的权重。把 \(M\) 在多头和多层上做平均,就得到一张可解释的、逐 token 的空间图——本质上是每个词「住在」图像哪个位置的软分割。
关键在于:这些 map 在扩散过程的极早期就已经形成,前几步基本决定了整张图的布局。
总体算法:用同一个随机种子并行跑两条 diffusion——一条用原始 prompt \(\mathcal{P}\)(产生 \(M_t\)),一条用编辑后的 prompt \(\mathcal{P}^*\)(产生 \(M_t^*\))。每一步把新的 attention map 替换为二者的某个函数:
\[ \widehat{M}_t = \operatorname{Edit}(M_t, M_t^*, t) \]
注意只覆盖 attention map(即 \(QK^\top\) 部分),value \(V\) 仍来自新 prompt。所以新的语义内容被注入进来,而原有的空间结构被保留下来。
三种编辑操作
1. Word Swap(替换词 → 替换 attention map)
例如 "a big red bicycle" → "a big red car":
\[ \operatorname{Edit}(M_t, M_t^*, t) := \begin{cases} M_t^* & \text{if } t < \tau \\ M_t & \text{if } t \ge \tau \end{cases} \]
在早期步骤(大 \(t\),直到切换时刻 \(\tau\))注入原始的 map \(M_t\),之后让新 prompt 自己的 map \(M_t^*\) 接管。
\(\tau\) 是一个超参,权衡对原始几何的忠实度与对新 prompt 的贴合度。当新词蕴含的形状差异很大时(如 bicycle → car),必须靠调 \(\tau\) 来放松几何约束。如果两个 prompt 的 token 数不同,可以用 attention map 的软插值。
2. Prompt Refinement(添加新短语 → 对齐后注入)
例如 "a castle next to a river" → "children drawing of a castle next to a river",或者添加风格描述。
引入一个对齐函数 \(A\),\(A(j)\) 把 \(\mathcal{P}^*\) 的 token 下标 \(j\) 映射到 \(\mathcal{P}\) 中对应的下标(新增 token 则映射为 \(\emptyset\)):
\[ \big(\operatorname{Edit}(M_t, M_t^*, t)\big)_{i,j} := \begin{cases} (M_t^*)_{i,j} & \text{if } A(j) = \emptyset \\ (M_t)_{i,A(j)} & \text{otherwise} \end{cases} \]
共有的 token 继承原始的 attention map(保留共享内容),而新增的 token 则自由地去关注它想关注的地方。这就实现了全局风格迁移、添加物体/细节描述,以及无需 mask 的局部编辑。
3. Attention Re-weighting(重加权 → 控制语义强度)
控制某个词影响有多强——比如山上的雪有多厚、泰迪熊有多毛绒。把目标 token \(j^*\) 的 attention map 乘以一个系数 \(c \in [-2, 2]\):
\[ \big(\operatorname{Edit}(M_t, M_t^*, t)\big)_{i,j} := \begin{cases} c \cdot (M_t)_{i,j} & \text{if } j = j^* \\ (M_t)_{i,j} & \text{otherwise} \end{cases} \]
\(c > 1\) 放大效果,\(c < 1\)(或负值)削弱/移除。这相当于给了一个连续的「滑块」,纯靠文字是做不到的。
实现细节
- attention 注入作用在所有分辨率的所有 cross-attention 层上;其中 \(16\times16\) 的 map 携带了最多的语义布局信息。
- 原文只注入 cross-attention。后续工作(如 MasaCtrl、Plug-and-Play)也操作 self-attention,以更好地解耦结构与外观。
- 把注入限制在由 attention map 阈值化得到的空间 mask 内,就能实现局部编辑:背景被完全保留,且不需要用户手绘 mask。
- 要编辑真实图像,Prompt-to-Prompt 必须搭配 inversion 技术。朴素的 DDIM inversion 在高 classifier-free guidance 尺度下会失效,因此配套提出了 Null-Text Inversion(Mokady et al., CVPR 2023)——逐时间步优化 unconditional/null embedding,这也是标准搭配。
优缺点
优点:免训练、免微调、不需要 mask、纯文本交互直观、保留构图与 identity、局部与全局编辑都支持。影响力极大,是 Null-Text Inversion、pix2pix-zero、InstructPix2Pix 数据生成、Attend-and-Excite 等一系列工作的基础。
缺点:
- 需要访问模型内部的 attention,无法用于黑盒 API
- \(\tau\) 与 \(c\) 需要逐案调参
- 当编辑需要大幅几何变化时会失效——结构被绑得太紧
- word swap 在新物体的合理形状与被注入的布局冲突时会失败
- 真实图像编辑的质量取决于 inversion 的精度