Birth and Death of a Rose
提出一个 pipeline,生成随时间演化的 3D 物体序列,同时覆盖几何与材质属性(albedo、roughness、metallic)。这些资产由预训练 2D diffusion model 蒸馏出的信号驱动生成。
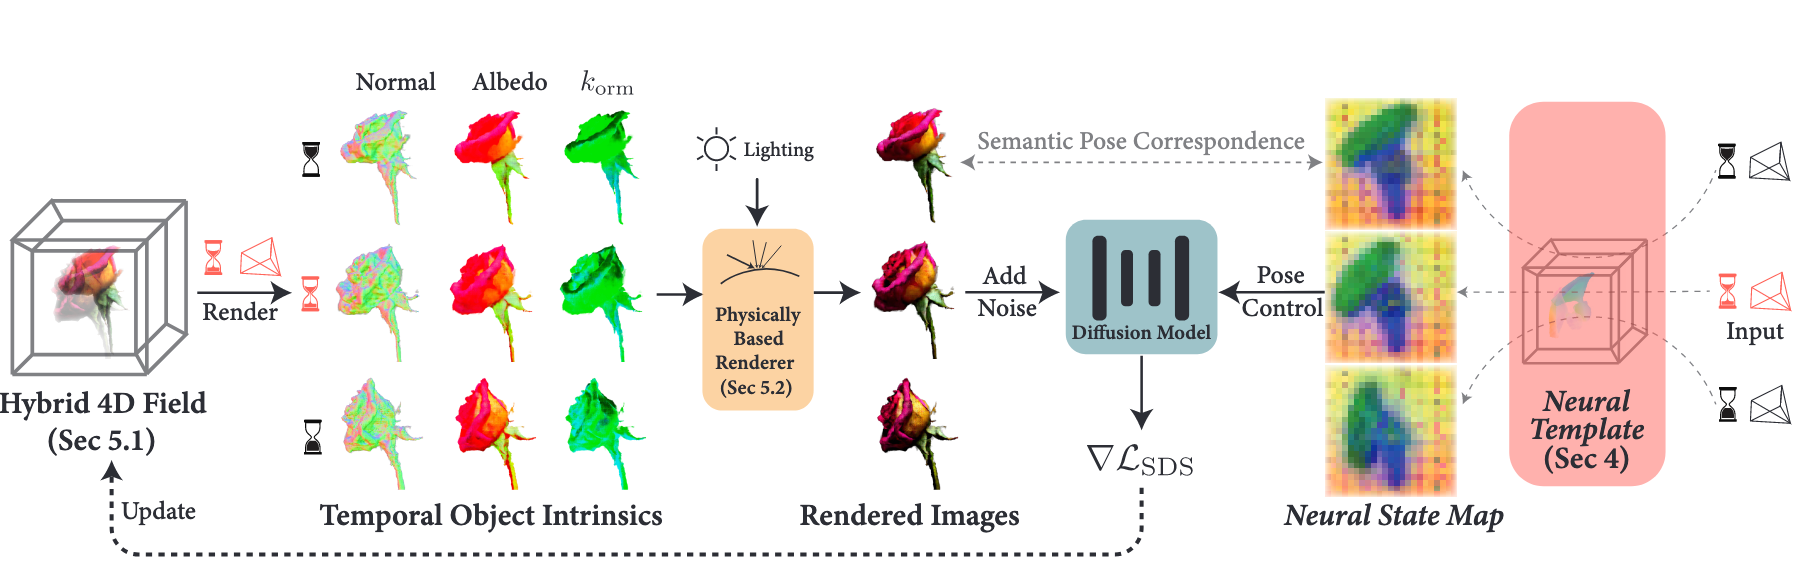
Neural Templates:一个以视角和时间为输入、输出所建模自然过程的「temporal state」信息的映射。
关键点是不需要预先设定好的 template,因此该方法可以应用到任意物体上。
作者认为,经过下采样 + DINOv2 提取到的特征图就可以当作 semantic affinity information,等价于原来的 SMPL 框架——相当于给任意一个物体都设置了一个 template(本文称为 Neural State Maps)。并且经验性地发现,这些 map 可以当作 ControlNet 的 condition,用来控制 temporal state 和 viewpoint。
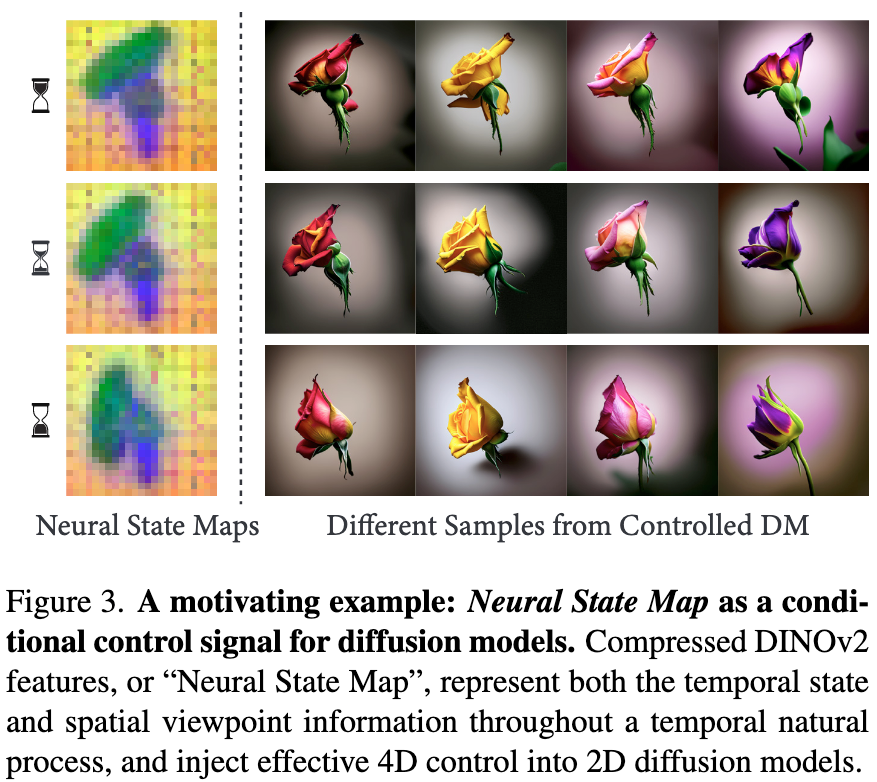
Neural Template 的目标是刻画所建模过程中 canonical 的 temporal state 变化。它是一个映射,输入 query viewpoint \(\epsilon \in SE(3)\) 和时间戳 \(t\),输出对应的 Neural State Map。
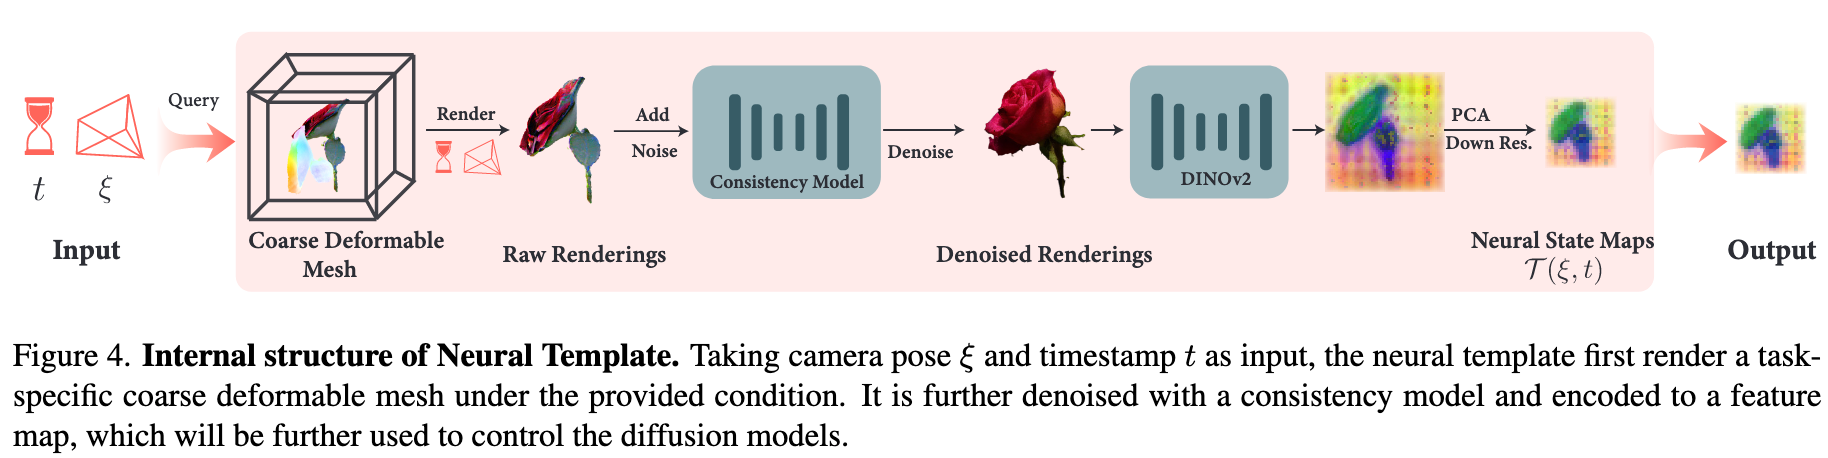
得到 Neural State Maps 的 Pipeline
先用 video diffusion model 在给定 prompt 的情况下生成一段视频。
从中挑选一帧,送进单图生 3D 的模型,得到静止的 3D mesh。
优化一个 deformation field \(D(\epsilon, t)\),显式地 deform mesh 来匹配视频的其余帧。
上一步得到的 coarse dynamic mesh 不一定符合 natural image distribution,所以用 consistency distillation 从 2D 生成模型中聚合先验。做法类似 SDS 蒸馏:随机选取时间 \(t\) 加噪,conditioned on \(y\) 去噪;此时可以认为在时间 \(t\) 下的输出已经符合该 consistency model 的数据分布。
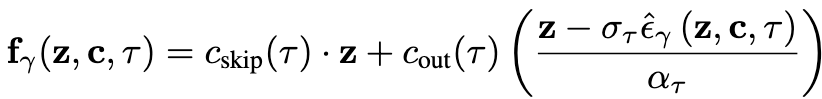
Guided 4D Object Intrinsics Synthesis
使用 K-Planes + NGP 的混合表示来表达 4D:前者可以很好地表示低频信息并保证时间上的一致性,后者用来补充缺失的高频信息。
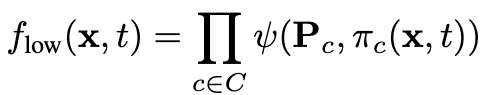
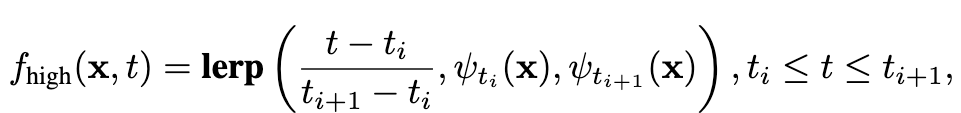
然后把 low-frequency 与 high-frequency feature 拼接,送给一个 2 层 MLP。最后用 SDS loss 从 2D diffusion model 蒸馏。
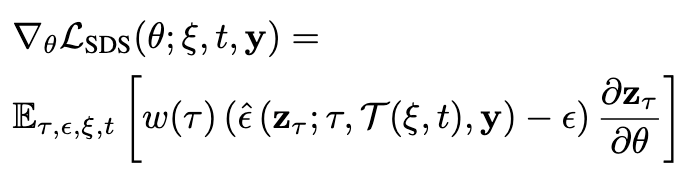
为了更好地保证 temporal consistency,会随机选择一个视角渲染出一段视频,送给 video diffusion model 得到更好的结果,再把输出前后两段视频的 MSE loss 加入优化。